





当 AI 开始像人一样“反思错题”,小模型也能逆袭大十倍的对手。本文拆解一篇 16 页实战论文:用“反思-重试-奖励”三步法,让 15 亿参数的模型在函数调用和数学题上碾压 720 亿参数的“学霸”。作者亲授 3 个可复制的训练技巧,教你把 AI 从一次性答题机器变成会自我纠错的“错题本”,效率直接拉满。
今天想跟大家分享一篇有意思的AI论文,标题有点长,叫《反思,重试,奖励:通过强化学习实现自我改进的大语言模型》。
说内容前,我先说说自己是怎么发现这篇论文的。熟悉AI的同学大多知道一个网站叫Hugging Face,这个平台不仅有各种大模型的训练场和技术讨论区,还开设了一个“每日论文”栏目。由于AI领域如今太过火热,每天都有大量新论文发布,这个栏目就像是一个论文版的“知乎热榜”——作者提交论文,读者点赞排名。
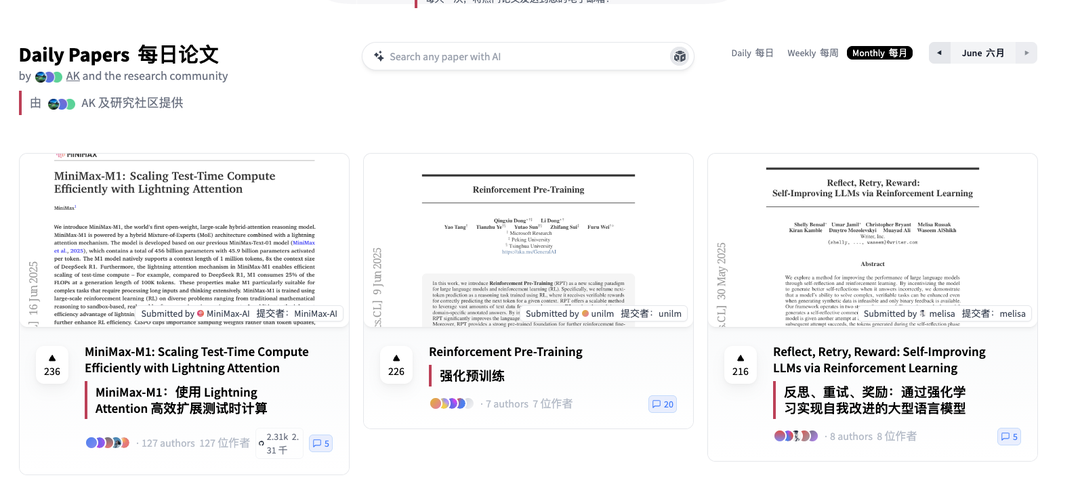
今天要介绍的这篇论文,是这个栏目6月排行榜的第三位。论文作者并不是一个典型的高校研究学者,而是一家名叫Writer的人工智能创业公司的研究团队,联合作者一共有八个人。
也许正因为是创业企业的研究团队,所以没有那么在乎学术层面的论文惯例,整个论文加上引用也只有16页,读起来也没有故作高深,非常简单明了。
这篇论文——《反思、重试、奖励:通过强化学习实现自我改进的大语言模型》——光是题目,你就能知道这项研究的核心结论是什么。
对我们人类来说,“从错误中学习”是非常重要并且有效的学习方式之一。不信你去网上搜搜看,文具有一个专门的品类就叫“错题本”。我们在求学时,当一道题没做对的时候,好的老师肯定不会直接说答案,而是会引导我们反思:“你觉得问题出在什么地方?下次可以怎么改进?”
而这篇论文的核心研究,就提出了一种巧妙的方法,能让AI像人一样,从错误中不断成长。
研究团队发现,即便是再强大的模型,也存在自己的“盲区”——它在某一个任务上表现得非常好,但并不代表它就一定能顺利搞定类似的另一个任务。
面对这个问题,传统的解决办法是收集更多数据,对模型进行重新训练或微调。
但这样的做法往往存在几个现实难题:一是很多时候你并没有更高质量的新数据可用;二是即便训练了,也常常出现“打地鼠”式的问题——那就是优化了一个点,另一个原本表现不错的地方反而出了问题。
后来,研究团队就换了一个思路:与其一遍遍喂AI数据、调优模型,不如教会它怎么反思。只要让AI掌握“怎么从错误中总结经验、改进自己”的方法,它在面对不同任务时,就能逐步自行进化。用通俗的话说,就是不再一味“灌知识”,而是教它“怎么学”。
这个方法一共包含三个步骤,就像论文标题里写的那样:反思、重试和奖励。
第一步,反思。当模型在某个任务上第一次失败时,系统不会直接结束,而是让它先生成一段自我反思的内容,分析自己到底哪里出了问题。就像学生考试答错题后,会问自己:“我哪一步想错了?是不是公式用错了?”这一环节的核心目的,是让AI开始自我觉察,并意识到错误的原因。
第二步,重试。这时候,AI模型会带着刚才的反思内容,再去尝试完成同一个任务。就像学生在弄明白上次哪里出错后,再去解同一类题目,就更容易成功。
第三步,奖励。如果模型在第二次尝试中成功完成了任务,系统就会对它在“反思阶段”所生成的内容进行奖励。这里的“奖励”并不是我们理解中的发红包,而是一种强化学习技术。简单来说,就是通过调整模型参数,让它更偏向于那些曾经带来正面结果的反思方式。
你可以把这个过程想象成一个老师在表扬学生:当学生通过反思改正了错误,终于做对了一道难题,老师会说:“你的反思很有帮助,继续保持下去,你的数学会越来越好。”注意,老师夸奖的不是解题方法本身,而是“反思”这一学习策略。所以学生就会知道,反思是有效果的,遇到问题的时候,就应该用这种方式来解决。
所以,这个机制的创新点在于:研究人员奖励的并不是模型最后给出的正确答案,而是它中间生成的“反思过程”。
这样的训练方式,让模型不再依赖死记硬背某个问题的答案,而是逐渐学会了一种通用的、自我纠错和自我提升的能力。
研究团队不是光讲概念,他们还做了两个实验,来实际验证这个机制的有效性。
这两个实验对于AI来说都不算简单,一个是函数调用,一个是数学方程求解,都属于具有挑战性、但又能够清晰判断对错的任务类型。
先说函数调用。传统技术开发需要对接各种API接口,要填入各种参数。这个任务就是看AI能不能正确地调用,这不同于那种没有标准答案的写作任务,调用API,成功与否,判断标准非常明确。
实验团队在多种规模大小的模型上都做了实验,测试了这种机制,例如从15亿参数的小模型到72亿参数的模型不等。效果令人惊叹。
一个只有15亿参数的阿里千问小模型,在这个任务上,一次就答对的概率只有大约32.6%。
但是经过今天介绍的这个反思训练后,第一次尝试的准确率就跃升到了48.6%,提升了16个百分点。如果允许它利用自己的反思再尝试一次,第二次的成功率就达到了52.9%,这相比原始能力提高了20多个百分点。
再说第二个任务——数学方程求解,它比函数调用更困难得多。
实验中,15亿参数的模型在第一次尝试时,正确率只有6%,几乎等于纯靠蒙的水平,就好比初中数学100分满分只考了个6分。
但当模型引入“反思机制”训练后,第一次尝试的正确率跃升到了34.9%,已经是一个质的飞跃。如果再让它根据第一次的反思重试一遍,第二次的成功率更是提升到45%。
正确率从最初的6%到最后的45%,这个跨度就像从不及格一路提升到接近及格线。
还有一个更惊人的发现是,经过这种学习方法训练的小模型,在能力上超过了参数量比自己大十倍的更高级模型。
研究团队同样使用了千问的70亿参数模型进行训练,结果发现,在这两个任务上,学会“反思”的70亿模型,表现都超过了不会反思的720亿模型。要知道,这两个模型都属于阿里千问系列。
这就像一个经过良好学习方法训练的高中生,在某些难题上,反而能打败知识储备多出十倍、但缺乏方法的博士生。
这个发现的现实意义在于,对于某些任务来说,并不一定非得依赖超大规模模型,如果能优化训练方式,小模型不仅节省成本,也能具备很强的能力。
我之所以要介绍这篇论文,是因为它的核心结论,对我们普通人是有借鉴价值的。
我观察到身边有一些同事在使用AI工具时,往往只进行一轮对话:给AI发一个任务,等它完成后就结束了。有时即便AI明显给出了错误答案,回应也只是简单一句“错了,再试一次”。
但按照这篇论文的启发,我们其实可以稍微调整一下话术,比如说:“你的答案可能有问题,请分析一下哪里出错了,然后再重新回答一遍。”
其次,在一些具体场景下,我们可以给AI提供更明确的反思方向。
比如在做商业决策分析时,读完AI的第一轮回答后,你可以补充说:“你的分析似乎忽略了市场风险因素,请重新考虑并补充完整。”当然,这种方式前提是你自己能敏锐地识别出回答中的问题。
类似的反思提示词还有很多,例如:
最后,我想分享一个我偶尔会用的小技巧,它和本文介绍的“反思机制”有异曲同工之妙。我给它起了个名字,叫做 “PUA大法”。
这个方法尤其适用于那些重要且复杂的任务,比如撰写竞品分析报告或者调研文档。我的做法是,先准备好三到四个表现稳定的大模型,比如从ChatGPT、Claude、DeepSeek、豆包、Kimi中挑选几个。
我个人的习惯是:先把任务描述清楚,然后分别让豆包、Kimi和DeepSeek先各自完成一次回答。
接下来,我会打开ChatGPT,对它说:“我正在完成一个任务,任务内容是……我已经请三个AI助手分别作答。现在你是评审官,请你根据任务的特点,制定一套100分制的评卷规则,然后分别对这三个助手的答案打分,并详细说明你的评分理由。”
接下来,我就会把其他几个AI的回答一个个发给ChatGPT。这时它会先搭建一套评分标准,再对其他AI的回答进行打分和点评,比如给出85分、87分之类的分数,并详细解释打分理由。
然后,我就会开始“PUA”它,对它说:“你既然这么懂,那你自己来答一遍这个问题看看?”
它会乖乖照做,答完后,我继续追问:“那你就按你刚才的评分规则,对你自己的回答也打个分,并说明理由。”
它通常会开始进行所谓的“公正打分”和自我评价——但你会发现,它几乎每次都比给其他AI打的分数高,一般会打个90到95分之间。哪怕这样,我也不会放过它,还要继续追问:“那你这剩下的几分是扣在哪里了?好好想想,再改一遍。”
当然,它最后输出的结果是不是满分作品,其实并不重要。但在这个过程中,往往会冒出很多新思路和新角度,对我们人类来说是很有启发的。
这个方法其实很简单,说到底,可能还是被我初中数学老师“深刻启发”过。当年他那种高压反思式教学,让我一度对数学敬而远之。
不过还好,现在的AI没有情绪,不会反抗,我们可以尽情用“PUA语气”去激发它的智力潜力。
本文由人人都是产品经理作者【快刀青衣】,微信公众号:【快刀青衣】,原创/授权 发布于人人都是产品经理,未经许可,禁止转载。
题图来自Unsplash,基于 CC0 协议。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。