


企业级AI Agent的开发常陷入成本陷阱,Token消耗如同电费账单令人猝不及防。本文直击四大架构级省token策略:从场景选型、模型分级到熔断机制与成本可视化,揭示真正的成本优化不在Prompt微调,而在于前期的治理决策。那些让团队省下数量级成本的秘密,都藏在最初的产品架构设计里。
做企业级AI Agent的时候,几乎每个人都会踩同一个坑。
Demo阶段,所有人关心的都是效果——”能不能跑通?””回答准不准?””看起来聪不聪明?”没人盯成本。
等到系统真正跑起来,账单甩到你脸上的时候,你才会感受到——
Token 就是 Agent 时代的电费。而说到省 token,大部分人上来就盯着 prompt 写短点、加个缓存——这些当然有用,但它属于末端的小修小补。真正的省,在架构和治理决策的关口上。
我给你拆成四个层级,从前到后,越靠前越剩的多。
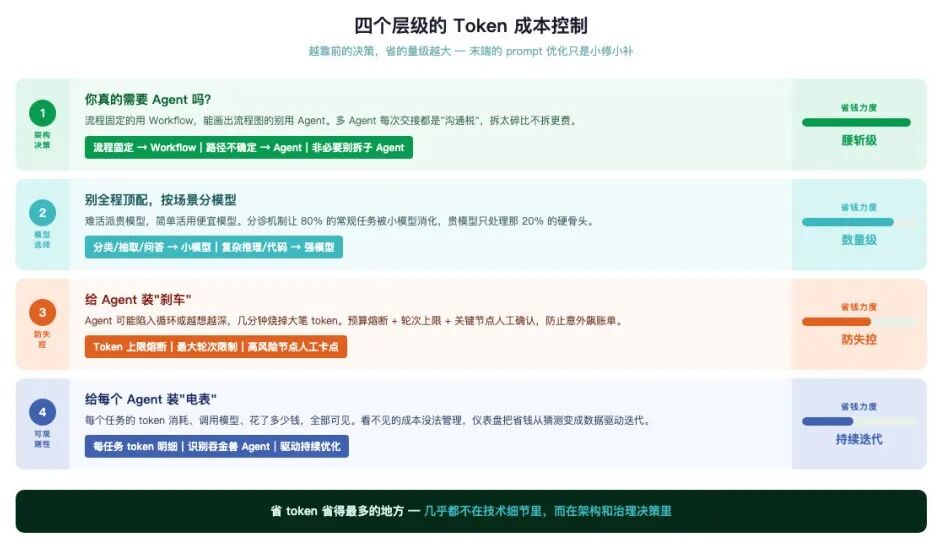
这是最容易被跳过的一层,也是最省钱的一层。
现在 Agent 太火了,火到什么程度呢?很多团队一上来就把所有任务都包成 Agent。但 Agent 的本质是什么?是”让大模型自己决定下一步做什么”。大模型每一次生成都带着概率和随机性——这既是它智能的来源,也是它成本和不确定性的来源。
所以判断标准其实特别朴素——
流程固定的,用 Workflow。路径不确定的,才用 Agent。
什么叫流程固定?简单说就是你能提前把它画成一张流程图。
工单分类路由、固定格式的信息抽取、按模板生成回执、定时报表汇总——这些事儿步骤是确定的,不需要让模型思考。该调模型的环节调一次就行了,其余靠规则流转。
这一刀砍下去,token 消耗可能直接腰斩。而且结果更稳定、更可控——LLM的本质还是概率预测,这样也可以减少模型突然”灵光一现”走偏了的情况。
那什么场景必须上 Agent 呢?事先画不出完整流程图、下一步依赖上一步结果的那种开放式任务。比如做一个调研——下一步搜什么、要不要深挖,取决于上一步查到了什么。比如一个故障排查——先看日志,然后根据日志内容决定是查数据库还是查配置文件。
这种”走一步看一步”的活儿,才值得为 Agent 的灵活性付那个溢价。
就算你确定了某个场景该上 Agent,也不意味着要把它拆成一大堆小 Agent 互相调用。
为什么?因为多 Agent 之间每一次交接,都要传上下文、都要发生一次模型调用。拆得越碎,Agent 之间的沟通就越重。
我见过一个特别典型的案例——把一个本来可以一次完成的任务,拆成了四个 Agent:”规划 Agent → 检索 Agent → 分析 Agent → 总结 Agent”。结果光是它们之间互相传话、反复确认,就烧掉了比干活本身还多的 token。
正确的做法是:该上 Agent 的整体场景上 Agent,但内部的子步骤如果是确定的,就在这个 Agent 内部用 Workflow 式的固定逻辑串起来,别拆成更多子 Agent。Agent 负责那个不确定的主干决策,确定的枝节用 Workflow 收进来。
能用 Workflow 的别上 Agent,非上 Agent 不可的,也别拆太碎。
确定了哪里真的需要模型之后,第二个决策是:每个环节用哪个模型?
很多人有个惯性思维——”全程用最好的”,从头到尾顶配。只要你看账单衡量一下消耗和产出,就能很明显觉得需要有分级:
难活派给贵的、聪明的;简单活派给便宜的、够用的。
那些真正需要强推理、容错率低的环节——复杂决策、高质量代码生成——值得上最强模型,因为这里质量直接决定成败,省不得。而那些大量常规的、确定性高的环节——分类、抽取、格式化、简单问答——用便宜模型完全够用。在高频调用下,这一项省下来的可能是数量级的差异。
对小公司、小团队来说,有时候第一版直接上最贵的模型,反而是对的。
为什么?因为 Agent 落地的初期,最大的风险不是成本,而是员工不信任它、觉得它不聪明,然后直接弃用。这个阶段,让员工第一次用就感觉到”这东西是真聪明”,建立起信任,比省那点钱重要得多。而且小公司的文件体量、调用量通常不大,贵模型和便宜模型的绝对费用差距其实很小——你省下的几十块钱,可能换来的是整个团队对 AI 的抵触。
所以这一条要辩证看:成本优化是为业务服务的,不是为省钱而省钱。判断标准永远是”这一步的钱花得值不值”,而不是”贵的就浪费”。
“按场景分模型”是原则,落地的时候你需要一个具体的机制来执行它。这个机制叫”分诊”。
逻辑跟医院一模一样——不是所有病人一来就挂专家号,而是先经过分诊台。一个便宜、快速的小模型先接住所有任务,简单的它自己当场处理掉,只有真正复杂、它拿不准的,才升级转交给贵模型。
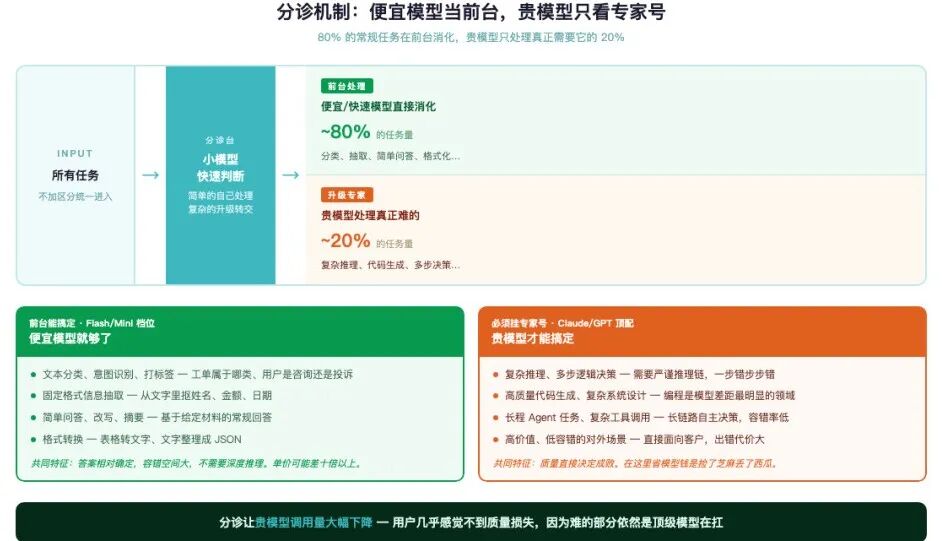
那么问题哪些问题用便宜的,哪些问题用贵的呢?
轻量模型
强模型
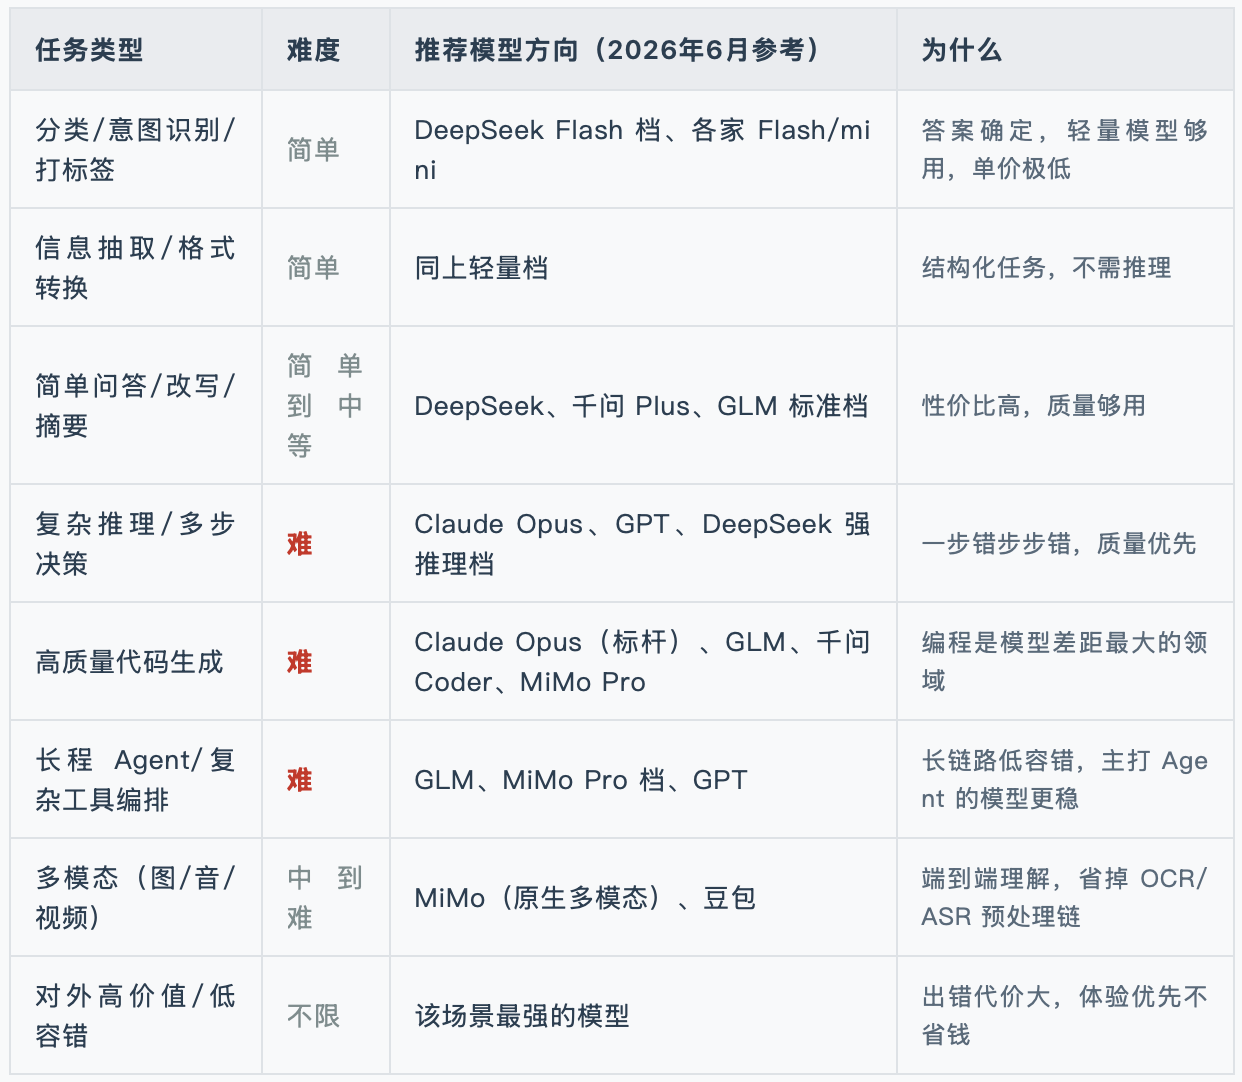
为了更直观的举例,我把市面上常见的大模型对照关系做成一张表(方向仅供参考,以最新版本和实测为准):
说完主动省token的场景,还需要防失控。
Agent——尤其是多个 Agent 互相调用的时候——有个非常真实的危险:它可能陷进某种循环,或者越想越深,在你不知道的情况下,几分钟烧掉一大笔 token。大模型的随机性意味着,你没法百分百保证它每次都规规矩矩地停下来。
与其事后看着账单心疼,不如事前给它划好不能越过的红线。不仅是省钱,也是控风险。
省 token 不是一次性动作,是个持续迭代的过程。而迭代的前提是可观测。
一个非常实用的做法是:给每个 Agent——甚至每个任务——配一个 token 仪表盘,清清楚楚显示:这次任务烧了多少 token、花在哪个环节、调用了哪个模型、花了多少钱。
有了这块”电表”,很多优化才有据可依:你能看到哪个 Agent 是吞金兽,知道该优先优化谁。你能发现某个环节其实用便宜模型就够,做模型降级。你能定位某类任务总是异常地贵,去查是不是 prompt 设计或流程有问题。
看不见的成本没法管理,先让它可见。
前面四层是骨架。既然聊到多Agent协同,再补几个更细的思路:
回头看这四层,你会发现一个挺有意思的规律:
省token省得最多的地方,几乎都不在“技术细节”里,而在“架构和治理决策”里。
要不要用Agent、用什么模型、给不给它装刹车、能不能看见它花了多少——这些都是在设计AI产品架构就该想清楚的判断。等到上线之后才想起在 prompt里抠字数,那是末端的小修小补,省不出量级的差异。
Token 是Agent时代的电费。而真正会省电的人,不是天天盯着电表抠那一度两度,而是在装修的时候就把电路设计对了。
本文由 @是AD 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自 unsplash,基于CC0协议
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。