








当工具强大与能力错配形成数据时代的最大悖论,产品运营者该如何突围?本文揭秘一套革命性的Prompt设计哲学,将业务经验转化为AI可执行的指令集,从单变量分析到复杂因素分解,教你用AI工具实现高效归因分析。特别是针对渠道投放、用户行为等关键场景,提供可直接套用的分析框架与计算公式。
周一10:00,你打开BI看板,指尖划过KPI曲线,在周报“波动归因”栏写下:“DAU上降5% → 人均游戏时长下降4%,可能与新渠道用户属性有关。”老板秒回:“波动我看到了。但你怎么排除是渠道投放衰减?请用数据闭环回答‘为什么是你说的这个原因’。”
这不是挑剔,而是业务决策的底线要求。
我们正站在一个悖论性的临界点:
而真正的高价值动作——建立因果假设、设计归因实验、量化变量贡献、构建业务解释框架——却被压缩在10%的碎片时间里,甚至沦为“等分析师排期”的被动等待。
本文不提供万能模板,而交付一套可内化的Prompt设计哲学:这套Prompt的本质,是把产运人的业务经验转化为AI可执行的分析指令集——它不取代思考,而是把思考结晶为可复用、可审计、可传承的分析契约。
我们先以最简单的“单变量”场景为例(如:收益、流量),看看如何进行周维度的异动分析。
假设我们在 A、B、C 三个渠道投放某款游戏:
周期一:分别获得 100、200、300 的收益。
周期二:分别获得 50、150、600 的收益。
基础数据表:
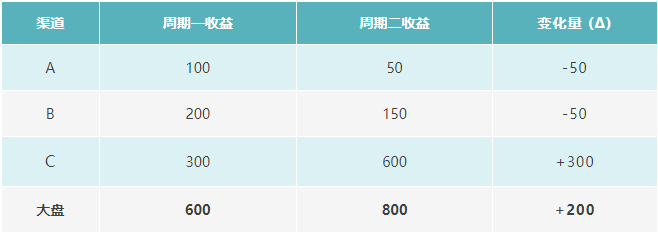
公式:整体环比增长率 = (周期二总收益 – 周期一总收益) / 周期一总收益 × 100%
计算:(800 – 600) / 600 × 100% = 33.33%
结论:整体收益环比增长 33.33%。
通常我们需要计算各分项对大盘变化的贡献程度。
计算逻辑:
渠道贡献值 = 该渠道周期二的收益 – 该渠道周期一的收益
总变化量 = 周期二总收益 – 周期一总收益
贡献占比 = 渠道贡献值 / 总变化量
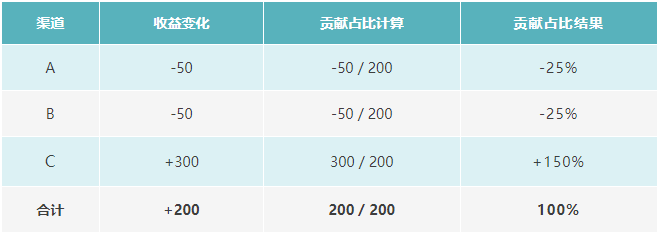
关键结论:
实际工作中,我们常遇到比率型指标(如:人均时长、转化率、点击率)
公式:人均时长 = 总游戏时长 / 活跃用户数 (DAU)
这类指标涉及两个变量:分子(总时长)和 分母(DAU)。当大盘人均时长下滑时,我们不能简单地做减法,因为需要区分是“结构变化(Mix)”导致,还是“效率变化(Rate)”导致
此时我们要用到这个分析公式
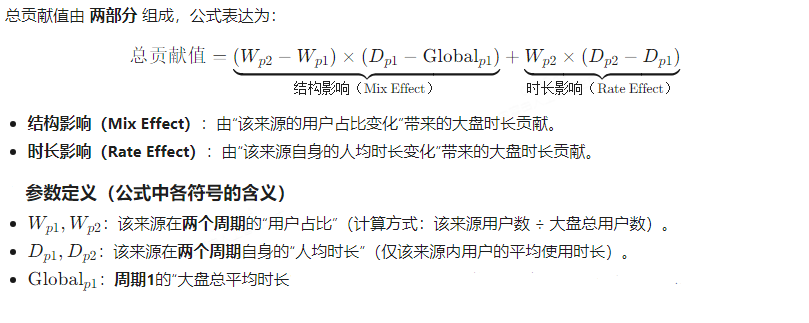
公式解释:单渠道总贡献 = 结构影响 (Mix Effect) + 数值影响 (Rate Effect)
结构影响 (Mix):(本期权重 – 上期权重) × (上期单渠道值 – 上期大盘均值)
含义:因为该渠道用户占比变化,导致大盘被拉高/拉低了多少。
数值影响 (Rate):本期权重 × (本期单渠道值 – 上期单渠道值)
含义:因为该渠道自身时长变化,导致大盘被拉高/拉低了多少。
假设 A、B、C 三个渠道的数据如下:
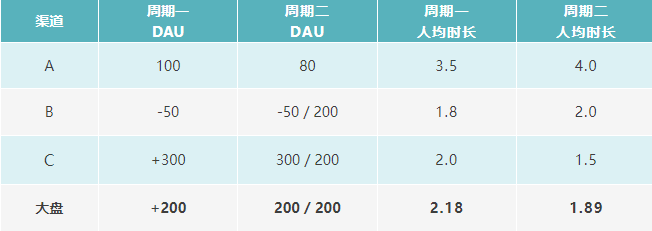
案例计算:以渠道 C 为例准备数据:
Wp1 (上期权重):300 / 600 = 50%
Wp2 (本期权重):500 / 800 = 62.5%
Dp1 (上期时长):2.0
Dp2 (本期时长):1.5
Global_p1 (上期大盘):2.18
代入计算:
结构影响:(62.5% – 50%) × (2.0 – 2.18) = 0.125 × (-0.18) = -0.0225
数值影响:62.5% × (1.5 – 2.0) = 0.625 × (-0.5) = -0.3125
渠道 C 总贡献:-0.0225 + (-0.3125) = -0.335
那么就可以汇报成:
渠道 C 自身时长大幅下降(数值影响 -0.3125)是主要原因,同时因为它是低于均值的渠道且占比扩大了(结构影响 -0.0225),进一步拉低了大盘。
同理计算出 A 和 B 后,汇总如下:
渠道 A 贡献:-0.038
渠道 B 贡献:+0.077
渠道 C 贡献:-0.335
最终评价渠道 C 的作用:
净贡献率:-0.335 / -0.29 ≈ 116%
结论:大盘跌了 0.29,渠道 C 贡献了 116% 的负面力量(它是罪魁祸首)。
毛贡献率(负向归因占比):-0.335 / (-0.335 + (-0.038)) ≈ 89.8%
结论:在所有导致大盘下跌的因素中,渠道 C 占了 89.8% 的责任。(业务复盘时用这个更容易解释)
弄懂了原理,接下来就是怎么通过AI来实现上面的分析了,我们可以使用 AI 工具。使用前请确认好你的数据源(CSV/Excel)及分析目标。适用工具推荐:Gemini 3 (PRO模式)
(注:一定是PRO模式,需要开通的话,就去某鱼/某宝上买一个,花钱提高自己的工作效率)
提示词参考 (Prompt):
# Role
你是一位资深的数据分析师,精通“因素分解法” (Factor Decomposition / Rate-Mix Analysis)。
# Context
我有一份数据(已上传/见下文),包含:
[维度列名],例如:启动来源/渠道
[分子列名],例如:总时长/总收益
[分母列名],例如:活跃用户数/UV
我想分析的核心指标是:
[指标名称] = [分子] / [分母]。
[周期1] 定义为:2026XXXX – 2026XXXX
[周期2] 定义为:2026XXXX – 2026XXXX
# Task
请对比 [周期1] 和 [周期2] 的数据,分析该指标整体变化的原因,并计算各个维度的贡献权重。
# Analysis Requirements (核心要求)
1. 全局计算:计算两个周期的全局均值及其净变化量。
2. 贡献度计算:请务必使用“结构影响 (Mix Effect)”和“数值影响 (Rate Effect)”的分解公式进行计算。
结构影响 = (本期权重 – 上期权重) × (上期单维度值 – 上期大盘均值) 数值影响 = 本期权重 × (本期单维度值 – 上期单维度值)
3. 归因排行:请列出导致指标 上升(正向) 的 Top 3 驱动因素。 请列出导致指标 下降(负向) 的 Top 3 拖累因素。
4. 深度解读:对于贡献最大的前三个因素,请明确指出它们是因为“自身表现变了”(Rate Effect),还是因为“用户占比变了”(Mix Effect/结构稀释)导致的影响?
# Output Format
请用表格展示 Top 3 正向和 Top 3 负向因素,包含列:
[维度名称] | [总贡献净值] | [结构影响部分] | [数值影响部分] | [对大盘净变化的解释度(%)]
本文由 @NoThing 原创发布于人人都是产品经理。未经作者许可,禁止转载
题图来自Unsplash,基于CC0协议
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。