





warning: 这篇文章距离上次修改已过686天,其中的内容可能已经有所变动。
哔哩哔哩观看历史记录的页面地址是 https://www.bilibili.com/account/history
有时候我想分享最近观看的几个视频给朋友,尤其是在我使用关键字搜索之后的列表,会有好几个条目,一个一个打开并复制出一个干净的标题和干净的视频地址太麻烦了。于是我用js写了一段脚本快速获取页面上的视频标题和URL
源码如下
// 使用 querySelectorAll 选择符合路径的 div
const targetDiv = document.querySelector('#history_list');

// 检查 targetDiv 是否存在
if (targetDiv) {
    // 在 targetDiv 内选择所有的 li 标签
    const liTags = targetDiv.querySelectorAll('li');
    let title_url = '';

    // 遍历每一个 li 标签,获取其内容
    liTags.forEach(liTag => {
        const titleA = liTag.querySelector('a.title'); // 获取 class 名称是 title 的那个 a 标签
        if (titleA) {
            let url = titleA.getAttribute('href'); // 获取链接地址
            let title = titleA.textContent;
            if (url) {
                let originStr = url.trim(); // 原始字符串
                url = `https:${originStr.replace(/\?.*$/, '')}`; // 利用正则格式化,前面拼上 https: 顺便把半角问号和后面的字符串都remove掉
                title_url += '- ' + title + ' ' + url + '\n'; // 拼接英文减号和空格,再拼上视频标题和空格,最后拼上视频地址
            } else {
                title_url += '- No title attribute\n'; // 如果没有 title 属性,添加提示
            }
        }
    });
    console.log(title_url)
} else {
    console.log('无法找到目标 div');
}
使用方法
- 打开历史记录页面,搜索某关键词(搜索是可选项,不搜索也可以,但是js脚本只会收集出页面已加载的内容)
- 按下键盘F12,切换到
Console标签 - 粘贴如上代码后回车即可。如果此网站不允许粘贴,临时在Console中键入
allow pasting回车即可。不过B站的web是允许粘贴的
举例,我使用富士搜索出如下视频
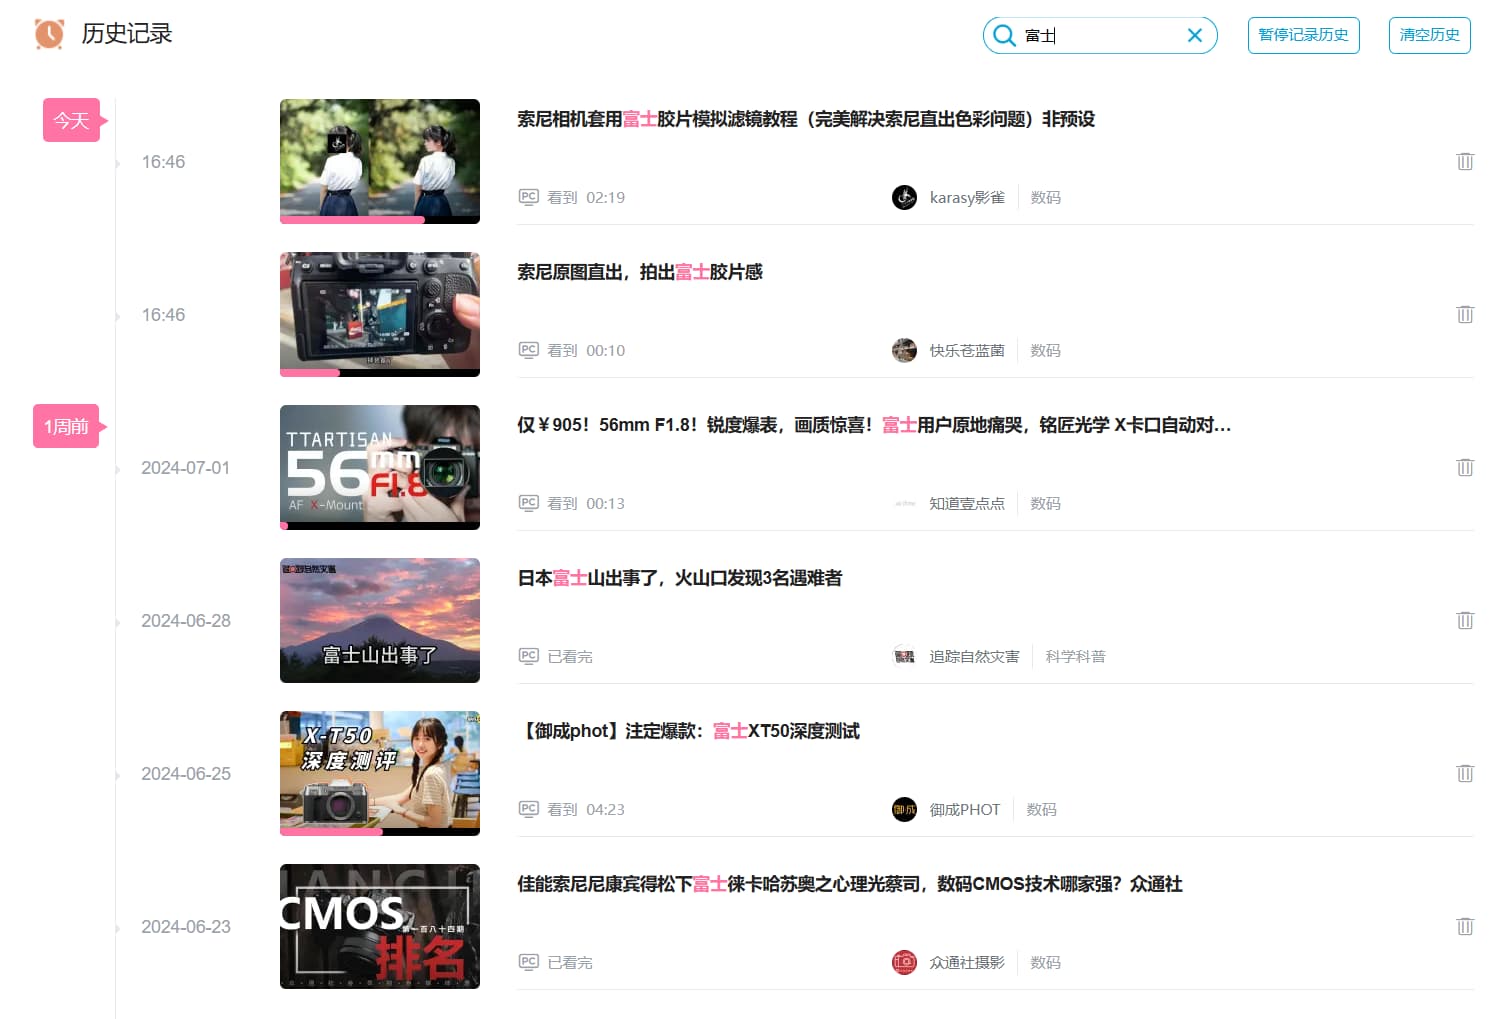
执行js代码之后快速获取了这些视频的标题和URL
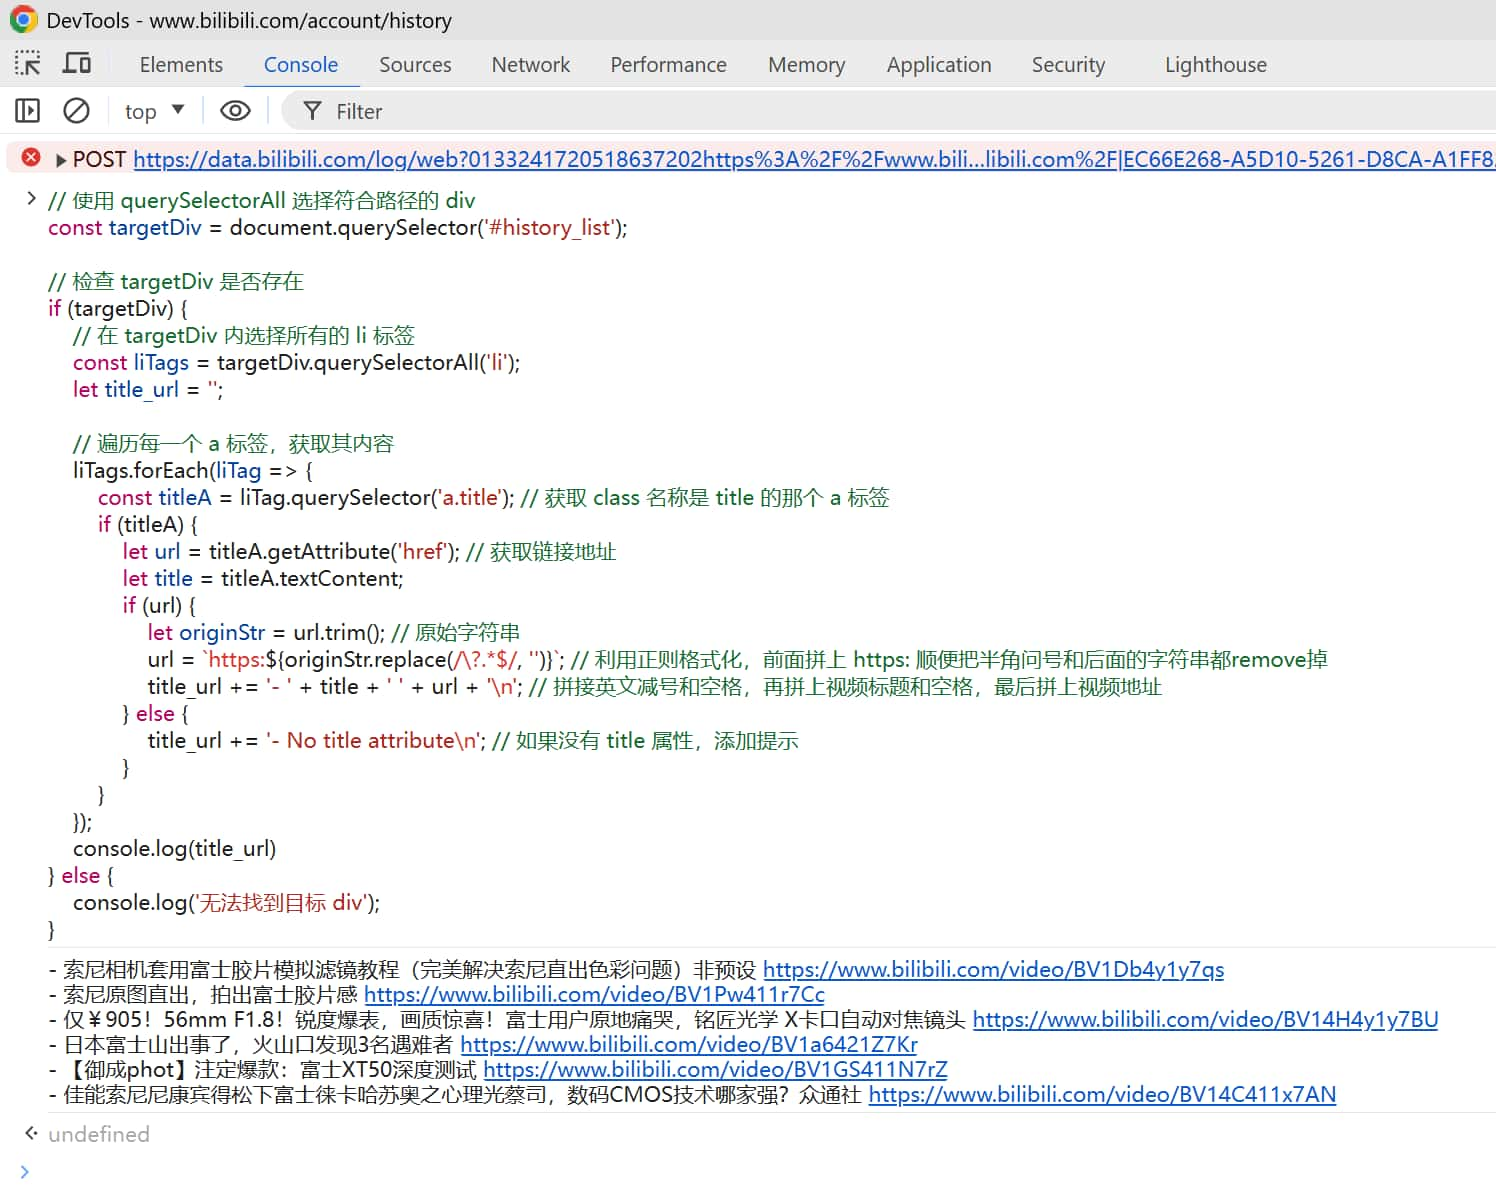
刚好我顺手记录一下这些视频的地址。下面各二级标题就是我使用标题搜出来的结果(基于我最近观看的视频)。不太清楚,B站历史记录的最大条目好像是 1000?(有知道的朋友欢迎留言评论)
富士
- 索尼相机套用富士胶片模拟滤镜教程(完美解决索尼直出色彩问题)非预设 https://www.bilibili.com/video/BV1Db4y1y7qs
- 索尼原图直出,拍出富士胶片感 https://www.bilibili.com/video/BV1Pw411r7Cc
- 仅¥905!56mm F1.8!锐度爆表,画质惊喜!富士用户原地痛哭,铭匠光学 X卡口自动对焦镜头 https://www.bilibili.com/video/BV14H4y1y7BU
- 日本富士山出事了,火山口发现3名遇难者 https://www.bilibili.com/video/BV1a6421Z7Kr
- 【御成phot】注定爆款:富士XT50深度测试 https://www.bilibili.com/video/BV1GS411N7rZ
- 佳能索尼尼康宾得松下富士徕卡哈苏奥之心理光蔡司,数码CMOS技术哪家强?众通社 https://www.bilibili.com/video/BV14C411x7AN
索尼
- 索尼相机套用富士胶片模拟滤镜教程(完美解决索尼直出色彩问题)非预设 https://www.bilibili.com/video/BV1Db4y1y7qs
- 羡慕隔壁的颜色?3分钟教你玩转索尼直出,有手就能学会! https://www.bilibili.com/video/BV18a4y1Z7tB
- 索尼原图直出,拍出富士胶片感 https://www.bilibili.com/video/BV1Pw411r7Cc
- 为什么你的索尼拍照不好看?搞懂直出的秘诀! https://www.bilibili.com/video/BV1CS421d7B3
- 索尼直出也能打?A7M4创意外观全解析! https://www.bilibili.com/video/BV165411U73D
- 索尼相机人像直出设置教程-以ZVE10为例(适用三代机 A6400 M3 R3 R4 A9 ZV1 RX100M5A等) https://www.bilibili.com/video/BV1WM411e7ex
- 【简单教程】索尼菜单太复杂?快来看看我怎么设置A7C2的吧 https://www.bilibili.com/video/BV1Ht421J7Eo
- 把记忆留在那片森林,感动之旅拍摄之终章丨索尼A7C2 & SEL2450G丨拍照姿势教学丨日常感人像拍摄引导丨摄影Vlog丨破碎感情绪片 https://www.bilibili.com/video/BV1Hx4y1t7pz
- 自用,索尼人像直出滤镜参数。一定要会用呀~ https://www.bilibili.com/video/BV1UG411X71j
- 索尼A7m4逆天预设直出 https://www.bilibili.com/video/BV1Hr4y1b7To
- 简单学习|准确且高效!2分钟快速设置一个索尼A7C2的好用对焦模式 https://www.bilibili.com/video/BV1Jz421h7J6
- 我使用最多的索尼镜头:FE35mm F1.8 https://www.bilibili.com/video/BV1MY4y1c7C5
- 开箱vlog|索尼A7C二代和一代有什么区别? https://www.bilibili.com/video/BV1Bu4y1c7Xu
- 索尼S&Q实用教学|三个实际应用技巧 https://www.bilibili.com/video/BV1y841177oy
- 索尼相机用户必看!8个必须了解的设定 https://www.bilibili.com/video/BV1ZE421A7Np
- 索尼USB连接的四种模式的区别:USB流式传输、MSC、MTP、遥控拍摄 https://www.bilibili.com/video/BV1Hc411R7UH
- 索尼A7C2,腾龙28-200,最近天气不错,练手拍照合集,纠结要不要换24-105······ https://www.bilibili.com/video/BV1RAhCeUEyw
- 【第一视角拍妹】索尼a7m4腾龙28200闪光灯人像拍摄,希望对你有帮助! https://www.bilibili.com/video/BV1Db421H79u
- 索尼或发布FE 24-200mm F2.8-4.5 G OSS https://www.bilibili.com/read/cv28071789
- 适马2870mm F2.8,越用越香!| 索尼相机变焦镜头推荐 https://www.bilibili.com/video/BV11T411q7Z7
- 索尼a7c2 适马2870 草原天路 乌兰布统 达达线热阿线 之旅 https://www.bilibili.com/video/BV12J3keJE6o
- 影像狗 | 索尼A7C2镜头怎么选?看完这个视频就够了! https://www.bilibili.com/video/BV1tb421H7V8
- 索尼FE 35mm F1.8有多香? https://www.bilibili.com/video/BV1R441117qp
- 【最强性价比85?】索尼FE口三85测评 https://www.bilibili.com/video/BV1Fo4y1H7L1
- 背刺原厂?永诺85mm F1.8 vs 索尼85mm F1.8 https://www.bilibili.com/video/BV1aW4y127nX
- 【御成索尼】一次看够!8种索尼创意外观直出对比 https://www.bilibili.com/video/BV1Py411a7C4
- 超简单的索尼人像直出设置 https://www.bilibili.com/video/BV1Lo4y1b7aC
- 索尼相机人像直出设置教程-以ZVE10为例(适用三代机 A6400 M3 R3 https://www.bilibili.com/read/cv22042777
- 【御成测评】35 F1.8哪家强?索尼/佳能/尼康35mm定焦横评测试! https://www.bilibili.com/video/BV1dv411M7SR
- 「索尼20-70」那些零零散散的夏天碎片成了夏天最后的镜头 https://www.bilibili.com/video/BV15a4y1D7tn
- 索尼20 70『夏天的味道』你还记得吗? https://www.bilibili.com/video/BV1um42157tW
- 【国内首测】索尼官方样张摄影师为你揭示FE35MM F1.8的秘密。(已重新编辑声音) https://www.bilibili.com/video/BV1hx411f7NQ
- 索尼35mm 1.8上手测试 https://www.bilibili.com/video/BV1us421T7G6
- 索尼20-70 F4 G镜头拍视频画质很好就是光圈有点小! https://www.bilibili.com/video/BV17b4y1A7NX
- 索尼2070镜头3个月挂机体验:优缺点一览,二手掉价的原因揭秘! https://www.bilibili.com/video/BV1bS411P7RY
- 【御成phot】完美的天选打工人:索尼20-70G购买分享 https://www.bilibili.com/video/BV1m4421w7PN
- 索尼镜头多到挑花眼?|新人向|索尼镜头选购指南 https://www.bilibili.com/video/BV13i421e7FV
- 【2024年618摄影选购】索尼篇(镜头+机身超详细解析,保姆级)建议收藏和三连 https://www.bilibili.com/video/BV1Cm421K7au
- 【收藏向】索尼E卡口选购指南必看网站/索尼E卡口镜头排行评测必看 Sony Alpha Blog网站使用指南 https://www.bilibili.com/video/BV19Z421y7X8
- 入坑索尼全画幅微单,5只镜头推荐 https://www.bilibili.com/video/BV15b411c77M
- 【御成索尼】不是GM大师买不起,而是平替更有性价比!5枚索尼E卡口平替镜头推荐 https://www.bilibili.com/video/BV1rc411U79m
- 索尼相机可选这6支性价比高的镜头 https://www.bilibili.com/video/BV1kR4y1o7qL
- 前方预警!索尼E口镜头最不值得买TOP5 https://www.bilibili.com/video/BV1xY411J7mw
- 真便携?光圈够?适合照片还是视频?索尼20-70半年使用体验报告 https://www.bilibili.com/video/BV1FW4y1P7b5
- 【器材指南】索尼A7C2新手快速设置指南 | 自定义按键、波轮设置方案分享 https://www.bilibili.com/video/BV1tz421878x
- 2023最强轻量旗舰?索尼A6700微单上手 https://www.bilibili.com/video/BV1ck4y1N7iw
- 索尼A7C2 小小的 也很可爱捏 https://www.bilibili.com/video/BV11M4m1m72r
- 为什么我要把索尼20-70G换到四年前的腾龙28-200? https://www.bilibili.com/video/BV1Ei42117Eo
- 为啥手机cmos都是索尼造,佳能尼康干啥去了? https://www.bilibili.com/video/BV1vF4m1A7oP
- 佳能索尼尼康宾得松下富士徕卡哈苏奥之心理光蔡司,数码CMOS技术哪家强?众通社 https://www.bilibili.com/video/BV14C411x7AN
- 购物指南|索尼用户爱不释手的摄影配件居然是······! https://www.bilibili.com/video/BV1ar421w7es
- 索尼24-50 F2.8 G,一颗让你上手之后直呼真香的镜头! https://www.bilibili.com/video/BV1jS421o7C4
- 第四期,索尼相机,HDR照片拍与摄制作 https://www.bilibili.com/video/BV1bt4y1H7XX
- 第五期,索尼相机变焦模式的正确设置 https://www.bilibili.com/video/BV17Y411T775
- 第六期,索尼相机视频录制曝光模式的正确设置 https://www.bilibili.com/video/BV1mB4y1q7FX
- 第七期,索尼相机拍摄视频时帧速率、对焦区域还有对焦模式的简单设置 https://www.bilibili.com/video/BV16t4y1t7jr
- 第八期,索尼相机的斑马线设定 https://www.bilibili.com/video/BV18e4y1B7nP
- 索尼相机S-log2,S-log3的对比 https://www.bilibili.com/video/BV1gY41187WF
- 第三期,索尼相机的测光模式设置(下) https://www.bilibili.com/video/BV1X54y1o7na
- 第三期,索尼相机的测光模式设置(上)。测光模式看这一篇就足够了 https://www.bilibili.com/video/BV165411X72f
- 第二期,索尼相机的白平衡设置(下) https://www.bilibili.com/video/BV1Ut4y1W7cZ
- 第二期,索尼相机的白平衡设置(上) https://www.bilibili.com/video/BV1hv4y1N7Sm
- 第一期,索尼相机的对焦模式与对焦区域。 https://www.bilibili.com/video/BV14Z4y1a7y9
- 只知道用直方图看曝光 有用斑马线来看曝光吗 索尼相机斑马线用法 https://www.bilibili.com/video/BV1yr4y1g7ZV
- 2023年索尼全画幅E卡口定焦镜头小盘点之35mm焦段【52】原厂/腾龙/适马,手动/自动,超轻/健身? https://www.bilibili.com/video/BV1oR4y1B73b
- 『索尼35mm F1.8 vs 三阳35mm F1.8』适马35mm F1.2表示我就看看不说话 https://www.bilibili.com/video/BV1V54115716
- 索尼A7M4超好用的斑马线功能,照片过曝克星! https://www.bilibili.com/video/BV1vY411d7Kd
- 【丽江旅拍】如果只用一支35mm的镜头拍摄 | 索尼35GM https://www.bilibili.com/video/BV1Jq4y1B7Cx
- 索尼 FE 35mm F1.8 户外人像 https://www.bilibili.com/video/BV1U54y1s7fk
- 认识相机卡口和法兰距,佳能尼康索尼各品牌卡口讲解,相机知识 https://www.bilibili.com/video/BV1Gr4y1q7Sc
- 寻找地球上最舒服的耳机:AirPods丨开放式耳机丨韶音游泳耳机丨华为耳夹丨索尼LinkBuds丨三星BudsLive https://www.bilibili.com/video/BV1Kr421c75u
- 这个600块的索尼相机震撼了我的思想!超便宜的α微单相机|sony a3000|拍照可放大看细节出片可观|视频能力比预期高! https://www.bilibili.com/video/BV1vZ421s7Ai
- 【索尼相机肩带安装教程】实用美观的相机肩带安装方法 | 索尼a6400 https://www.bilibili.com/video/BV1sT4y1j7oZ
直出
- 羡慕隔壁的颜色?3分钟教你玩转索尼直出,有手就能学会! https://www.bilibili.com/video/BV18a4y1Z7tB
- 索尼相机套用富士胶片模拟滤镜教程(完美解决索尼直出色彩问题)非预设 https://www.bilibili.com/video/BV1Db4y1y7qs
- 索尼原图直出,拍出富士胶片感 https://www.bilibili.com/video/BV1Pw411r7Cc
- 为什么你的索尼拍照不好看?搞懂直出的秘诀! https://www.bilibili.com/video/BV1CS421d7B3
- 索尼直出也能打?A7M4创意外观全解析! https://www.bilibili.com/video/BV165411U73D
- 索尼相机人像直出设置教程-以ZVE10为例(适用三代机 A6400 M3 R3 R4 A9 ZV1 RX100M5A等) https://www.bilibili.com/video/BV1WM411e7ex
- 自用,索尼人像直出滤镜参数。一定要会用呀~ https://www.bilibili.com/video/BV1UG411X71j
- 索尼A7m4逆天预设直出 https://www.bilibili.com/video/BV1Hr4y1b7To
- 【御成索尼】一次看够!8种索尼创意外观直出对比 https://www.bilibili.com/video/BV1Py411a7C4
- 超简单的索尼人像直出设置 https://www.bilibili.com/video/BV1Lo4y1b7aC
- 索尼相机人像直出设置教程-以ZVE10为例(适用三代机 A6400 M3 R3 https://www.bilibili.com/read/cv22042777
创意外观
- 索尼直出也能打?A7M4创意外观全解析! https://www.bilibili.com/video/BV165411U73D
- 【御成索尼】一次看够!8种索尼创意外观直出对比 https://www.bilibili.com/video/BV1Py411a7C4
- 【御成phot】阿索直呼内行:3个创意外观预设分享! https://www.bilibili.com/video/BV111421R7ud
ok, that's all.