💡 站外导读:在AI视觉革命浪潮中,视频内容的深度理解与推理成为突破重点。传统模型难以精准处理复杂的时空关系,导致视频分析准确性不足、可解释性差。北京大学与字节跳动强强联合,开源了Open-o3 Video视频推理模型,直击行业痛点。该模型通过整合显式时空证据与创新的两阶段训练策略,在权威V-STAR基准测试中取得最优成绩,标志着开源视频推理技术迈入新阶段,为内容理解、智能监控等领域带来全新可能。
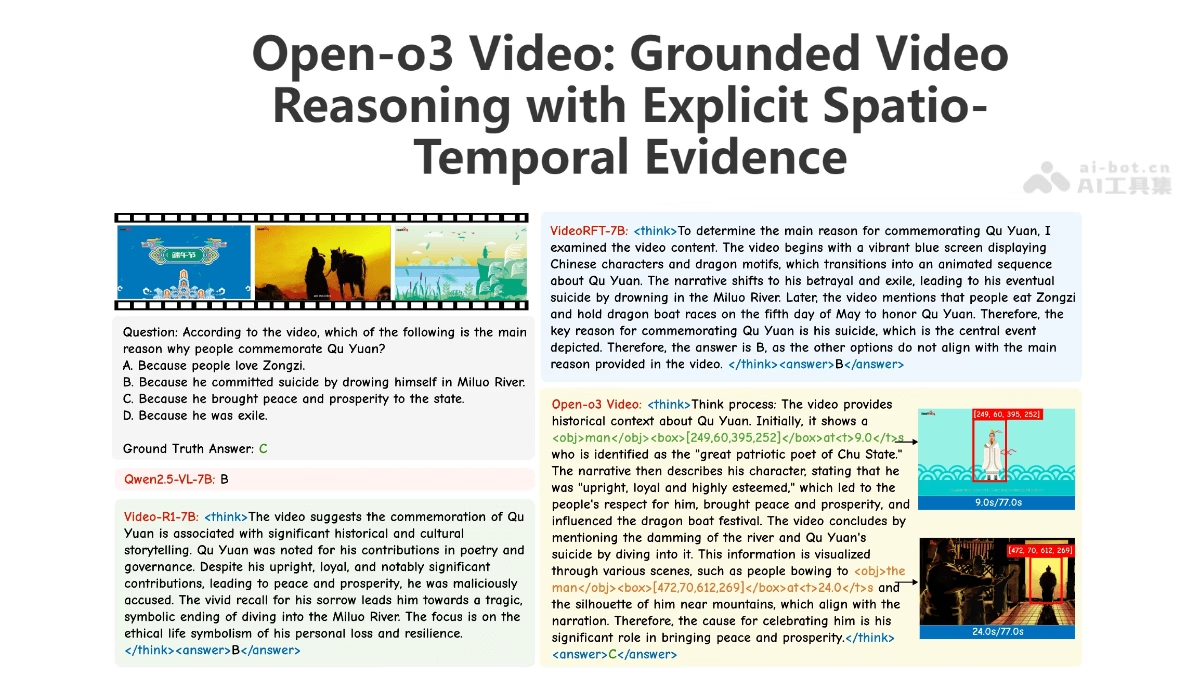
Open-o3 Video 是北京大学和字节跳动联合开发的开源视频推理模型,通过整合显式的时空证据(关键时间戳和边界框)来实现精准的视频推理。通过精心策划的 STGR 数据集和两阶段的 SFT-RL 训练策略,实现了在 V-STAR 基准测试中的最佳性能。非代理框架设计,能高效地处理复杂的时空关系,在视频推理任务中表现出色。训练过程包括冷启动初始化和强化学习两个阶段,通过这种方式,模型能更好地适应不同的视频推理场景。
- Open-o3 Video是什么
- Open-o3 Video的主要功能
- Open-o3 Video的技术原理
- Open-o3 Video的项目地址
- Open-o3 Video的应用场景
- 📝 站长洞察 (Editor’s Insight)
Open-o3 Video的主要功能
- 时空推理:能整合显式的时空证据,包括关键时间戳和边界框,精准地进行视频推理,有效处理视频中的时间和空间关系。
- 数据集策划与训练策略:精心策划了 STGR 数据集,并采用两阶段的 SFT-RL 训练策略,先进行冷启动初始化,再通过强化学习优化模型性能,使其在 V-STAR 基准测试中表现出色。
- 非代理框架设计:采用非代理框架,高效处理复杂的时空关系,提升视频推理的准确性和效率。
- 开源与可扩展性:开源的特性使得研究人员和开发者可以方便地使用和改进该模型,推动视频推理技术的发展,具有良好的可扩展性。
Open-o3 Video的技术原理
- 时空证据整合:通过显式地引入关键时间戳和边界框作为时空证据,将视频推理过程与具体的视觉观察紧密结合,使模型的推理更具可解释性和可靠性。
- 两阶段训练策略:采用冷启动初始化和强化学习相结合的两阶段训练方法。冷启动阶段通过监督学习为模型提供基础的时空推理能力;强化学习阶段则通过多种奖励机制,进一步优化模型的推理性能,提升答案的准确性、时间对齐性和空间精确性。
- 数据集策划:精心策划了 STGR-CoT-30k 和 STGR-RL-36k 两个高质量数据集,为模型训练提供了丰富的时空标注和推理痕迹,解决了现有数据集缺乏统一时空监督的问题。
- 非代理框架设计:基于非代理框架构建模型,能够高效处理复杂的时空关系,避免了代理模型可能带来的信息丢失和推理效率低下的问题,提升了视频推理的整体效率和准确性。
Open-o3 Video的项目地址
- 项目官网:https://marinero4972.github.io/projects/Open-o3-Video/
- Github仓库:https://github.com/marinero4972/Open-o3-Video
- HuggingFace模型库:https://huggingface.co/marinero4972/Open-o3-Video/tree/main
- arXiv技术论文:https://arxiv.org/pdf/2510.20579
Open-o3 Video的应用场景
- 视频内容理解:能精准地理解和分析视频中的关键事件和对象,通过时空证据为视频内容提供详细的推理和解释,帮助用户更好地理解视频的核心信息。
- 视频问答系统:可以作为视频问答系统的核心组件,根据用户的问题,快速定位视频中的相关时空片段,生成准确且具有解释性的答案,提升用户体验。
- 视频编辑与创作:为视频编辑和创作提供辅助,帮助创作者快速找到视频中的关键元素和精彩瞬间,更高效地进行剪辑、特效添加等创作活动。
- 智能监控与分析:在智能监控领域,能实时分析监控视频,快速识别异常事件和关键对象,提供详细的时空证据,助力安防监控的智能化升级。
- 教育与培训:在教育和培训中,可用于分析教学视频,帮助教师和学生更好地理解教学内容,同时为学生提供更具针对性的学习建议和反馈。
- 娱乐与互动:在娱乐领域,如短视频平台、直播等,能够为用户提供更丰富的互动体验,例如通过视频推理生成有趣的问答或挑战,增强用户参与感。
📝 站长洞察 (Editor’s Insight)
Open-o3 Video的发布,绝非仅是又一个开源模型的亮相,它揭示了AI视频理解的范式转移——从隐式黑箱走向显式、可解释的时空推理。其核心创新在于将关键时间戳与边界框作为显式证据注入推理链,结合精心设计的STGR数据集与SFT-RL两阶段训练,大幅提升了复杂视频场景下的定位与推理精度。这背后是字节与北大对‘可解释AI’与‘精准时空建模’两大趋势的深刻洞察。在视频数据爆炸、内容安全与智能分析需求激增的当下,这种高效、准确的非代理框架设计,为短视频平台、安防监控、自动驾驶及教育科技提供了坚实的基座技术。它不仅是性能的刷新,更预示着视频AI将从‘识别’真正迈向‘理解与推理’的新阶段。









