
惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

罗磊的独立博客
Recent Announcements
奇客Solidot–传递最新科技情报
奇客Solidot–传递最新科技情报
有赞技术团队
有赞技术团队
J
Java Code Geeks
T
The Blog of Author Tim Ferriss
MyScale Blog
MyScale Blog
人人都是产品经理
人人都是产品经理
aimingoo的专栏
aimingoo的专栏
U
Unit 42
The GitHub Blog
The GitHub Blog
云风的 BLOG
云风的 BLOG
T
Tailwind CSS Blog
H
Hackread – Cybersecurity News, Data Breaches, AI and More
酷 壳 – CoolShell
酷 壳 – CoolShell
博客园 - 三生石上(FineUI控件)
Apple Machine Learning Research
小众软件
小众软件
Hugging Face - Blog
Hugging Face - Blog
博客园 - 司徒正美
腾讯CDC
I
InfoQ
GbyAI
GbyAI
博客园_首页

Prompt 语宙

kimi-thinking-preview – 月之暗面推出的多模态思考模型 pdf-craft – 开源 PDF 转 Markdown 工具 UltraMem – 字节豆包大模型团队推出的全新超稀疏模型架构 EasyControl – Tiamat AI 联合上海科大等开源的图像生成控制框架 GaussianCity – 南洋理工大学 S-Lab 团队推出的 3D 城市生成框架 X-Prompt – 用于多模态视频目标分割的通用框架 豆包大模型1.5 – 字节跳动推出的最新版大模型 GaussianAnything – 南洋理工 S-Lab 和上海 AI Lab 等推出的 3D 生成框架 Cube 3D – Roblox 推出的 AI 3D 生成模型 OpenMath-Nemotron – 英伟达开源的数学推理系列模型 MAI Transcribe-1.5 – 微软 MAI 推出的语音转文本模型 Seed1.5-Embedding – 字节跳动 Seed 团队推出的向量模型 2026世界杯人机大战引爆!联想携手DeepSeek等顶尖AI大模型,对战亿万球迷预测冠军 高考公平守护战!豆包、文心等主流大模型集体禁用拍题功能 ShotAdapter – Adobe联合UIUC推出的多镜头视频生成框架 Devstral – Mistral AI联合All Hands AI开源的编程专用AI模型 MMaDA – 字节联合普林斯顿大学等推出的多模态扩散模型 Software Copyright Materials Skill – 开源软著资料生成Skill Dulus – 开源的 CLI AI Agent,可驱动多模型工具调用 Reasonix – 专为 DeepSeek 推出的开源终端编程 Agent Mega-ASR – NTU、NUS、上海AI Lab开源的语音识别模型 CodeGraph – 开源代码知识图谱工具,加速代码理解和分析 MiniCPM5-1B – 面壁智能联合清华开源的端侧文本基座模型 Horizon – 开源 AI 信息聚合系统,构建专属新闻雷达 BitCPM-CANN – 面壁智能联合清华开源的端侧大模型 Xiaomi Auto World Model – 小米推出的辅助驾驶世界模型 opera-browser-cli – Opera Neon 开源的命令行工具 omp – 开源的 AI 终端编程智能体,能与 IDE 深度联动 Claude Opus 4.8 – Anthropic 推出的旗舰级大语言模型 Hy-Memory – 腾讯混元推出的 Agent 记忆插件
BabyVision评测集发布:AI视觉能力远逊人类,顶尖模型准确率...
站外新闻 · 2026-06-14 · via Prompt 语宙

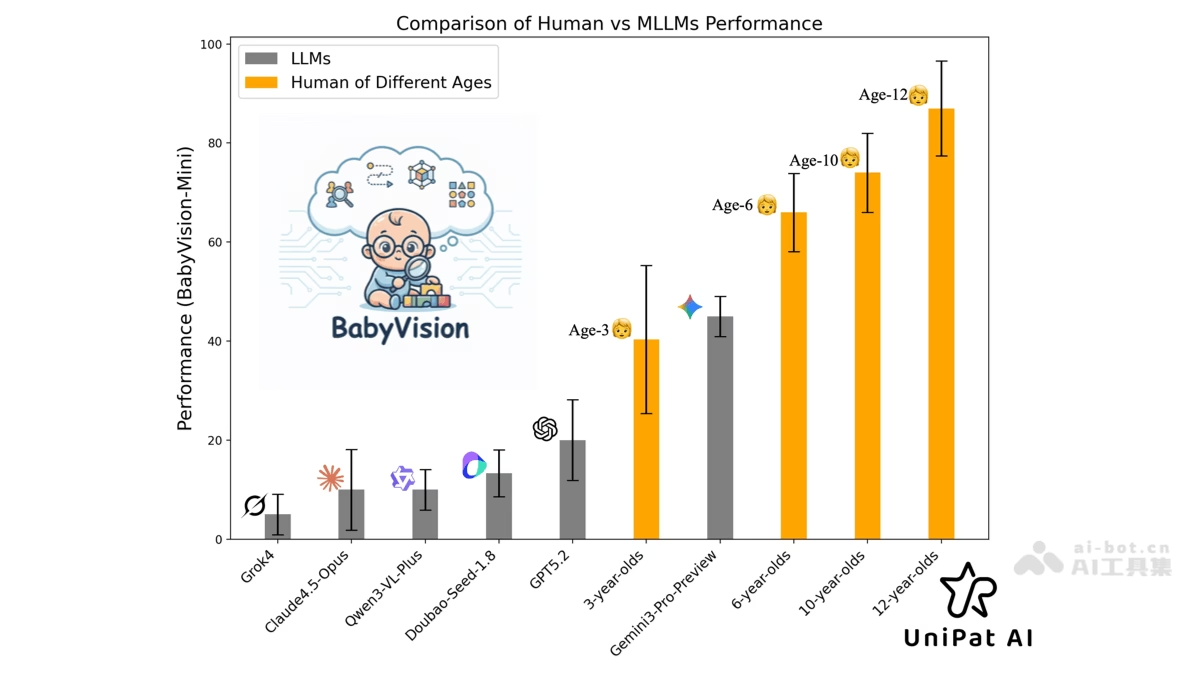
💡 站外导读:当前,多模态大模型在文本能力上狂飙突进,但在最基础的视觉理解上,它们真的及格了吗?UniPat AI团队最新发布的BabyVision评测集,用388道“纯视觉”题目,对主流模型进行了一次残酷的“体检”。结果令人震惊:人类平均正确率高达94.1%,而表现最好的商用模型准确率竟不足50%,开源模型更是集体“挂科”。这暴露了AI在连续追踪、空间想象等基础视觉能力上的系统性短板,这些能力正是自动驾驶、机器人、工业检测等产业落地的核心基石。BabyVision的发布,不仅是一份成绩单,更是吹响了攻克视觉智能底层能力的号角。

BabyVision是 UniPat AI团队推出的多模态理解评测集,评估多模态语言模型(MLLMs)和图像生成模型在视觉推理任务上的表现。包含两个主要赛道:MLLM评估和生成评估。评测集设计了四大视觉能力类别,包括精细辨别、视觉追踪、空间感知和视觉模式识别,共22项子任务,总计388道题目。这些任务严格控制语言依赖,以真实反映模型的视觉理解能力。
  • BabyVision是什么
  • BabyVision的主要功能
  • BabyVision的评测结果
  • BabyVision的项目地址
  • BabyVision的应用场景
      • 📝 站长洞察 (Editor’s Insight)

BabyVision

BabyVision的主要功能

  • 评估多模态模型的视觉推理能力:通过设计严格的视觉任务,测试多模态语言模型(MLLMs)和图像生成模型在纯视觉场景下的表现,揭示模型在视觉理解方面的短板。

  • 提供两个评估赛道:一个是针对多模态语言模型的MLLM评估,另一个是针对图像生成模型的生成评估,全面覆盖不同类型的多模态模型。

  • 涵盖四大视觉能力类别:包括精细辨别、视觉追踪、空间感知和视觉模式识别,通过多样化的任务设计,全面评估模型在不同视觉场景下的推理能力。

  • 严格控制语言依赖:确保任务设计中无法通过语言提示解决,从而真实反映模型的视觉理解能力,避免模型依赖语言提示来完成任务。

  • 提供详细的评测结果和排行榜:通过准确率等指标展示不同模型的表现,并与人类基线进行对比,为研究人员提供直观的参考。

  • 支持快速启动和灵活配置:提供完整的数据集、评估脚本和详细的文档,方便研究人员快速上手,并通过环境变量等方式灵活配置评估参数。

  • 推动多模态技术的发展:通过揭示当前模型的不足,为未来的技术优化和创新提供方向,促进多模态模型在视觉任务上的进一步提升。

BabyVision的评测结果

  • 人类基线表现卓越:人类测试者的平均准确率高达94.1%,展现了人类在视觉推理任务上的强大能力。

  • 闭源模型表现参差不齐:Gemini3-Pro-Preview以49.7%的准确率领先,GPT-5.2为34.4%,Doubao-Seed-1.8为30.2%,但整体仍远低于人类水平。

  • 开源模型差距明显:Qwen3-VL-Plus的准确率仅为19.2%,多数开源模型表现不佳,显著落后于人类基线和部分闭源模型。

  • 模型在视觉任务上存在短板:无论闭源还是开源模型,在需要连续追踪、空间想象和几何归纳等视觉任务上普遍表现不佳,暴露出当前多模态模型在视觉基础能力上的不足。

  • 生成式评估结果不理想:在生成式任务中,虽然部分模型表现出“更像人类”的行为,但整体仍然缺乏稳定达到完全正确解的能力。

  • 评测结果推动技术改进:通过明确指出模型的不足,BabyVision为未来多模态模型的优化和技术创新提供了重要的参考方向。

BabyVision的项目地址

  • Github仓库:https://github.com/UniPat-AI/BabyVision

BabyVision的应用场景

  • 多模态模型评估:用于系统性评估多模态语言模型和图像生成模型在视觉推理任务中的表现,帮助研究人员了解模型的视觉理解能力。

  • 技术研究与开发:为AI研究者提供一个标准化的测试平台,用于开发和优化多模态模型,推动视觉推理技术的进步。

  • 模型性能比较:通过统一的评测标准,对比不同模型在视觉任务上的性能,为模型选择和改进提供参考。

  • 教育与学习工具:为教育工作者和学生提供一个了解多模态AI视觉能力的工具,用于教学和研究活动。

  • 行业应用参考:为需要多模态视觉推理能力的行业(如自动驾驶、医疗影像分析等)提供模型性能的参考,助力行业应用的开发和优化。

  • 学术研究与发表:为学术研究提供数据支持,帮助研究人员发表相关研究成果,推动多模态AI领域的学术发展。

📝 站长洞察 (Editor’s Insight)

BabyVision的发布,标志着AI评测从“语言炫技”迈入“视觉验真”的深水区。当业界沉迷于千亿参数和万亿token的军备竞赛时,这个评测集如同一面镜子,照出了当前多模态模型“重语言、轻视觉”的致命软肋。高达94.1%与不足50%的准确率鸿沟,不仅是技术差距,更是智能范式的代差。它揭示了一个被忽略的趋势:真正的通用智能(AGI),其根基必须建立在扎实的、类人的视觉世界模型之上,而非仅仅是语言符号的统计相关性。这份评测结果,为产业界指明了明确的优化方向——未来的多模态竞争,将围绕“视觉接地”(Visual Grounding)能力展开。对于投资者和开发者而言,关注那些在BabyVision这类“硬核”基准上取得突破的团队,可能比追逐参数规模更具长远价值。BabyVision或许就是那把筛选下一代AI模型的“标尺”。