






💡 站外导读:在多模态AI技术狂飙突进的今天,企业面临一个核心痛点:如何以可控的成本,获得顶尖的多模态理解与生成能力?高昂的训练费用、复现的复杂性以及数据的稀缺性,正成为阻碍技术落地和社区创新的主要壁垒。开源生态的繁荣,正试图打破这一僵局,推动AI从实验室走向千行百业。
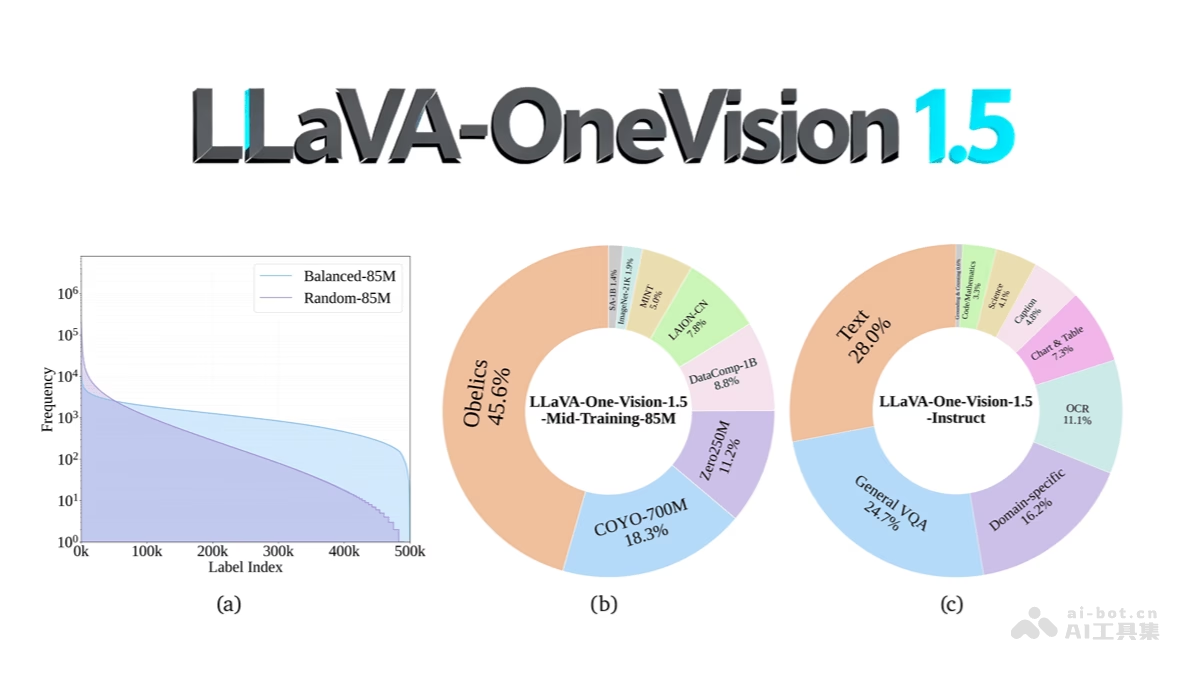
LLaVA-OneVision-1.5 是开源的多模态模型,通过高效训练和高质量数据实现高性能、低成本和强复现性。采用自研的 RICE-ViT 作为视觉编码器,结合 2D 旋转位置编码和区域感知注意力机制,支持可变输入分辨率,增强对象和 OCR 能力。语言模型基于 Qwen3,通过三阶段训练流程(语言–图像对齐、高质量知识中期预训练和视觉指令对齐)进行优化。训练中采用离线并行数据打包和混合并行策略,提升算力和显存效率。数据方面,构建了 85M 预训练数据集,采用“概念均衡”策略,涵盖多种来源;22M 指令数据覆盖八大类别,经过多源聚合和格式统一。LLaVA-OneVision-1.5 在多模态基准上表现出色,成本可控,且全链条透明开放,提供代码、数据和模型资源,助力社区低成本复现和拓展。
多模态理解与生成:能处理和理解图像、文本等多种模态的信息,生成高质量的文本描述、回答问题或进行推理。
视觉问答(VQA):针对图像中的内容回答问题,支持广泛的视觉任务,如物体识别、场景理解等。
图像描述生成:为输入的图像生成准确且富有细节的描述文本,帮助用户更好地理解图像内容。
指令遵循与执行:根据用户提供的指令执行相应的任务,如图像编辑、信息提取等,具有良好的指令泛化能力。
跨模态检索:支持基于文本查询图像或基于图像查询文本,实现跨模态的信息检索。
长尾识别能力:对数据中出现频率较低的类别或概念也能进行有效识别和理解,提升模型的泛化能力。
多语言支持:支持多种语言的输入和输出,具备一定的跨语言理解和生成能力。
知识增强:通过高质量的知识数据进行预训练,使模型具备更丰富的世界知识,更好地处理复杂的多模态任务。
高效训练与复现:采用优化的训练策略和数据打包技术,实现高效的训练过程,提供完整的代码和数据资源,方便社区复现和拓展。
视觉编码器:采用自研的 RICE-ViT(Region-aware Cluster Discrimination Vision Transformer)作为视觉主干,通过区域感知注意力机制和统一的区域簇判别损失,增强对图像中局部区域的语义理解,同时支持可变输入分辨率。
投影器设计:通过多层感知机(MLP)将视觉特征映射到语言模型的文本嵌入空间,实现视觉特征与语言特征的有效对齐。
语言模型:基于 Qwen3 作为语言骨干,提供强大的语言生成和理解能力,支持多模态任务中的文本处理。
三阶段训练流程:包括语言–图像对齐、高质量知识中期预训练和视觉指令对齐,逐步提升模型的多模态对齐能力和任务泛化能力。
离线并行数据打包:通过特征驱动的“概念均衡”策略构建预训练数据集,并采用离线并行数据打包技术,减少 padding 浪费,提高训练效率。
混合并行与长上下文优化:在训练过程中采用混合并行(张量并行、流水并行和序列并行)以及长上下文优化技术,提升算力利用和显存效率。
数据构建与优化:构建了大规模的预训练数据集和指令微调数据集,通过多源聚合、格式统一和安全筛除等手段,确保数据的高质量和多样性。
Github地址:https://github.com/EvolvingLMMs-Lab/LLaVA-OneVision-1.5
HuggingFace模型库:https://huggingface.co/collections/lmms-lab/llava-onevision-15-68d385fe73b50bd22de23713
在线体验Demo:https://huggingface.co/spaces/lmms-lab/LLaVA-OneVision-1.5
智能客服:通过理解用户上传的图像或文本信息,提供自动化的客服支持,解答问题并提供解决方案。
内容创作:帮助创作者生成图像描述、创意文案或故事,提升创作效率和质量。
教育辅助:在教育领域,用于解释图像中的内容,辅助教学,帮助学生更好地理解复杂的视觉信息。
医疗影像分析:辅助医生解读医学影像,提供初步诊断建议或生成影像报告。
智能驾驶:在自动驾驶系统中,用于理解道路场景,辅助决策,提升驾驶安全性。
图像编辑与设计:根据用户指令对图像进行编辑、裁剪、添加特效等操作,提升图像处理的便捷性。
LLaVA-OneVision-1.5的发布,标志着开源多模态模型进入了“高效、透明、普惠”的新阶段。其核心价值远超一个新模型本身:它通过RICE-ViT等自研技术,在架构层面实现了对复杂场景(如OCR、小目标)的精准理解;更关键的是,它公开了完整的85M+22M数据集构建管线和三阶段训练配方,将“如何炼好模型”的方法论系统化、产品化。这解决了过去开源模型‘只给鱼不给渔’的痛点,为社区和企业提供了可复制的工业化流水线。在Sora、GPT-4o引领的多模态浪潮下,此类全栈透明的开源项目,是降低AI创业门槛、激发下游应用创新的关键基础设施。未来,竞争将不仅在于模型单点性能,更在于谁能构建更高效、更开放的生态。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。