💡 站外导读:在人工智能迈向多模态的深水区,模型如何真正听懂、看懂并理解复杂世界,一直是核心挑战。传统模型常面临不同模态信息“各自为政”、语义脱节、时序不同步等问题,导致在真实场景中表现不佳。NVIDIA此次推出的OmniVinci全模态大模型,正是瞄准这些痛点,旨在打通视觉、听觉与语言间的壁垒,实现前所未有的精准跨模态融合与理解,为媒体分析、机器人、医疗等众多行业带来新的可能。
OmniVinci是NVIDIA推出的全模态大语言模型,专门处理视觉、听觉、语言和推理的多模态任务。通过独特的OmnialignNet技术实现跨模态语义对齐,Temporal Embedding Grouping机制解决时序同步问题,采用Constrained Rotary Time Embedding优化时间感知能力。在Dailyomni等基准测试中,性能超越Qwen2.5等模型,尤其在音画同步理解任务上表现突出。模型仅需0.2万亿tokens训练量,效率远高于同类产品,适用于媒体分析、游戏开发等场景。
- OmniVinci是什么
- OmniVinci的主要功能
- OmniVinci的技术原理
- OmniVinci的项目地址
- OmniVinci的应用场景
- 📝 站长洞察 (Editor’s Insight)
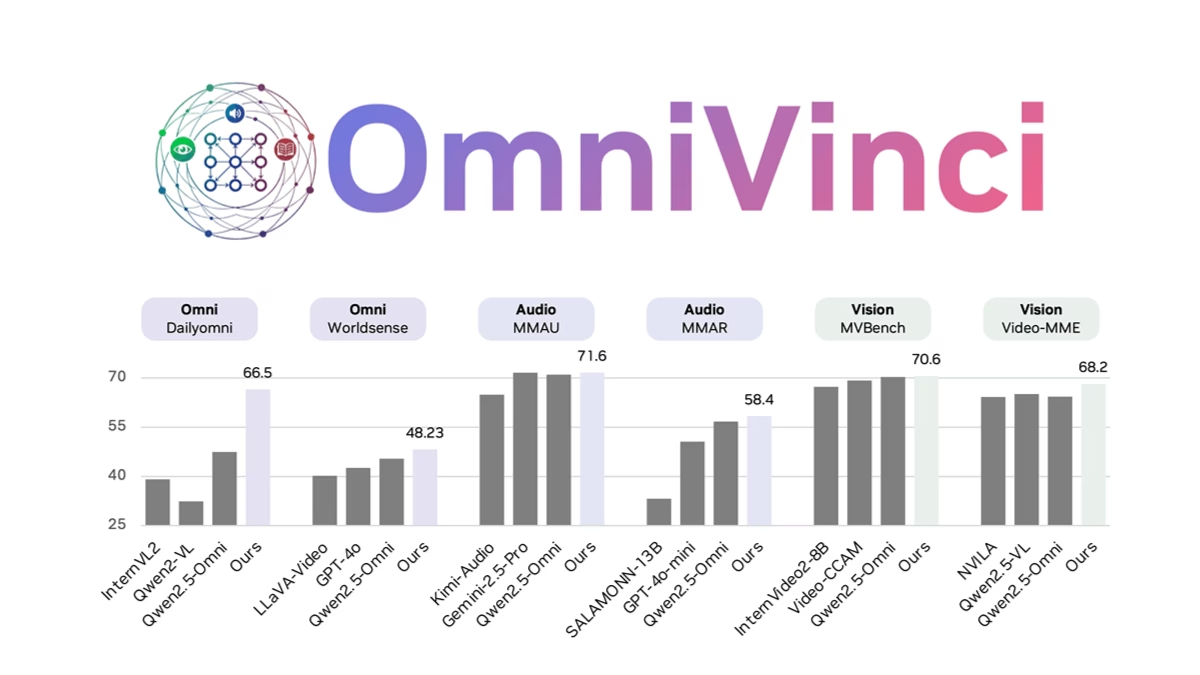
OmniVinci的主要功能
- 多模态理解 OmniVinci能同时处理视觉(图像、视频)、音频和文本信息,实现跨模态的联合理解。可以准确地将不同模态的数据融合在一起,例如在视频中理解人物的动作、语音内容以及场景背景。
- 跨模态对齐 通过OmniAlignNet模块,OmniVinci可以加强视觉和音频嵌入在共享全模态潜在空间中的对齐,解决传统模型中模态语义脱节的问题,提升多模态数据的融合效果。
- 时间信息处理 OmniVinci引入Temporal Embedding Grouping和Constrained Rotary Time Embedding技术,能有效处理视觉和音频信号的时间对齐以及绝对时间信息的编码,适用于需要时间序列分析的场景,如视频监控和音频分析。
- 广泛的应用场景 OmniVinci适用于多种实际应用场景,包括视频内容分析、医疗AI、机器人导航、语音转录与翻译以及工业检测等,能够为不同领域提供强大的多模态解决方案。
- 开源与社区共建 OmniVinci的代码、数据和网页演示均已开源,方便研究人员和开发者使用和改进,促进全模态AI研究社区的发展。
OmniVinci的技术原理
- OmniAlignNet模块 OmniVinci通过OmniAlignNet模块,加强视觉和音频嵌入在共享全模态潜在空间中的对齐,解决传统模型中模态语义脱节的问题,提升多模态数据的融合效果。
- Temporal Embedding Grouping OmniVinci采用Temporal Embedding Grouping技术,用于捕获视觉和音频信号之间的相对时间对齐,有效处理多模态数据中的时间序列信息,提升模型对时序逻辑的理解能力。
- Constrained Rotary Time Embedding OmniVinci引入Constrained Rotary Time Embedding,通过维度敏感的旋转编码,实现绝对时间信息的精准标记,进一步提升模型对时间信息的处理能力,适用于需要时间序列分析的场景。
- 数据优化与合成 OmniVinci通过精心设计的数据合成和优化流程,生成了2400万条单模态和全模态对话样本,其中15%为显式全模态合成数据。通过多模型协同纠错,消除“模态幻觉”,提升数据质量。
- 高效训练策略 OmniVinci仅使用0.2T的训练token,相比其他模型的1.2T,训练成本大幅降低。同时,通过优化训练流程,模型在多模态任务中表现出色,训练效率更高。
- 强化学习增强 OmniVinci在GRPO强化学习框架下进行训练,通过视听结合的方式提升模型的收敛速度和性能表现,使其在多模态任务中表现更出色。
- 模型架构创新 OmniVinci在模型架构上进行了多项创新,包括OmniAlignNet、Temporal Embedding Grouping和Constrained Rotary Time Embedding等模块,这些创新显著提升了模型在多模态任务中的表现。
OmniVinci的项目地址
- 项目官网:https://nvlabs.github.io/OmniVinci/
- Github仓库:https://github.com/NVlabs/OmniVinci
- HuggingFace模型库:https://huggingface.co/nvidia/omnivinci
- arXiv技术论文:https://arxiv.org/pdf/2510.15870
OmniVinci的应用场景
- 视频内容分析 :OmniVinci能详细描述视频中的人物动作、对话内容以及场景细节,适用于视频解说、体育比赛分析、新闻报道等场景,为用户提供更丰富的视频内容理解。
- 医疗AI :结合医生的口头解释和医学影像(如CT、MRI等),OmniVinci可以准确回答高难度问题,帮助医生进行诊断和治疗方案的制定,提升医疗效率和准确性。
- 机器人导航 :通过语音指令控制机器人行动,OmniVinci可以实现更高效的人机交互,适用于家庭服务机器人、工业机器人等场景,提升机器人的智能性和灵活性。
- 语音转录与翻译 :OmniVinci支持语音转录和多语言翻译,适用于实时会议、语音助手、在线教育等场景,帮助用户更好地理解和交流。
- 工业检测 :在工业生产中,OmniVinci可以结合视觉和音频信息,用于半导体器件检测、生产线监控等场景,提升检测精度和效率,降低人工成本。
- 智能安防 :OmniVinci可用于视频监控系统,通过分析视频中的视觉和音频信息,实时检测异常行为和事件,提升安防系统的智能化水平。
📝 站长洞察 (Editor’s Insight)
OmniVinci的发布,标志着多模态AI从“能处理”向“深度融合与精准理解”迈进的关键一步。其核心创新在于不仅追求模态的覆盖,更聚焦于解决跨模态的“语义对齐”与“时序同步”这一根本性难题。OmniAlignNet与Temporal Embedding Grouping等技术的引入,是工程与学术深度结合的典范。尤其值得注意的是,它以仅0.2T tokens的训练代价,实现了超越更大参数量模型的性能,这背后体现了高质量数据合成与训练策略优化的巨大价值,为行业树立了“高效智能”新标杆。长远看,OmniVinci所代表的全模态、高效率、强时序感知的模型范式,将极大加速AIGC、具身智能、虚实融合等前沿领域的落地进程。NVIDIA通过开源生态快速建立标准的策略,也再次巩固了其在AI基础设施领域的规则制定者地位。






