💡 站外导读:随着多模态AI的浪潮席卷而来,视觉理解与推理能力正成为衡量下一代大模型智能的核心标尺。行业亟需能够深度融合文本与视觉信息、解决复杂现实场景任务的强大基座。智谱AI开源的GLM-4.5V模型应运而生,它以106B的庞大参数规模与高效的12B激活设计,在多项权威基准测试中取得领先成绩,直击开发者在前端代码生成、视频内容分析、游戏交互等具体场景中的效率与智能化痛点。
GLM-4.5V是智谱推出的最新一代视觉推理模型。模型基于106B参数规模构建,拥有12B激活能力,是目前领先的视觉语言模型(VLM)。模型在GLM-4.1V-Thinking的基础上升级而来,继承其优秀架构,结合新一代文本基座模型GLM-4.5-Air进行训练。模型在视觉理解、推理能力上表现卓越,适用网页前端复刻、grounding、图寻游戏、视频理解等场景,有望推动多模态应用的进一步发展。为帮助开发者直观体验 GLM-4.5V 的强大能力并打造专属多模态应用,团队开源了一款桌面助手应用,能实时截屏、录屏,借助 GLM-4.5V 模型处理代码辅助、视频分析、游戏解答、文档解读等多种视觉任务。
- GLM-4.5V是什么
- GLM-4.5V的主要功能
- GLM-4.5V的技术原理
- GLM-4.5V的性能表现
- GLM-4.5V的项目地址
- 如何使用GLM-4.5V
- GLM-4.5V的API 调用价格
- GLM-4.5V的应用场景
- 📝 站长洞察 (Editor’s Insight)
GLM-4.5V的主要功能
- 视觉理解与推理:能理解和分析图像、视频等视觉内容,进行复杂的视觉推理任务,例如识别物体、场景、人物关系等。
- 多模态交互:支持文本与视觉内容的融合处理,例如根据文本描述生成图像,或者根据图像生成文本描述。
- 网页前端复刻:根据网页设计图生成前端代码,实现快速的网页开发。
- 图寻游戏:支持基于图像的搜索和匹配任务,例如在复杂场景中找到特定目标。
- 视频理解:支持分析视频内容,提取关键信息,进行视频摘要、事件检测等任务。
- 跨模态生成:支持从视觉内容生成文本,或者从文本生成视觉内容,实现多模态内容的无缝转换。
GLM-4.5V的技术原理
- 大规模预训练:模型基于106B参数的预训练架构,用海量的文本和视觉数据进行训练,学习语言和视觉的联合表示。
- 视觉语言融合:采用Transformer架构,将文本和视觉特征进行融合,基于交叉注意力机制实现文本与视觉信息的交互。
- 激活机制:模型设计12B激活参数,用在推理过程中动态激活相关的参数子集,提高计算效率和推理性能。
- 结构继承与优化:继承GLM-4.1V-Thinking的优秀结构,结合新一代文本基座模型GLM-4.5-Air进行训练,进一步提升性能。
- 多模态任务适配:基于微调和优化,模型能适应多种多模态任务,例如视觉问答、图像描述生成、视频理解等。
GLM-4.5V的性能表现
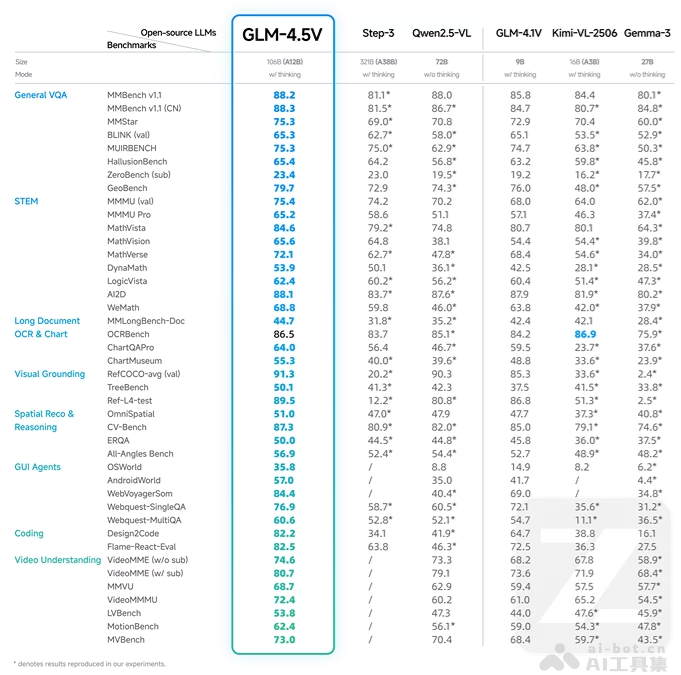
- General VQA:GLM-4.5V在通用视觉问答任务中表现最佳,尤其在MMBench v1.1基准测试中得分高达88.2。
- STEM:GLM-4.5V在科学、技术、工程和数学相关任务中同样领先,例如在MathVista测试中获得84.6的高分。
- Long Document OCR & Chart:在处理长文档和图表的OCRBench测试中,GLM-4.5V以86.5分展现卓越的性能。
- Visual Grounding:GLM-4.5V在视觉定位任务上表现突出,RefCOCO+loc (val)测试得分为91.3。
- Spatial Reasoning:在空间推理能力方面,GLM-4.5V在CV-Bench测试中取得87.3分的优异成绩。
- Coding:在编程任务中,GLM-4.5V在Design2Code基准测试中得分82.2,显示其在代码生成和理解方面的能力。
- Video Understanding:GLM-4.5V在视频理解方面同样表现出色,在VideoMME (w/o sub)测试中得分74.6。
![GLM-4.5V]()
GLM-4.5V的项目地址
- GitHub仓库:https://github.com/zai-org/GLM-V/
- HuggingFace模型库:https://huggingface.co/collections/zai-org/glm-45v-68999032ddf8ecf7dcdbc102
- 技术论文:https://github.com/zai-org/GLM-V/tree/main/resources/GLM-4.5V_technical_report.pdf
- 桌面助手应用:https://huggingface.co/spaces/zai-org/GLM-4.5V-Demo-App
如何使用GLM-4.5V
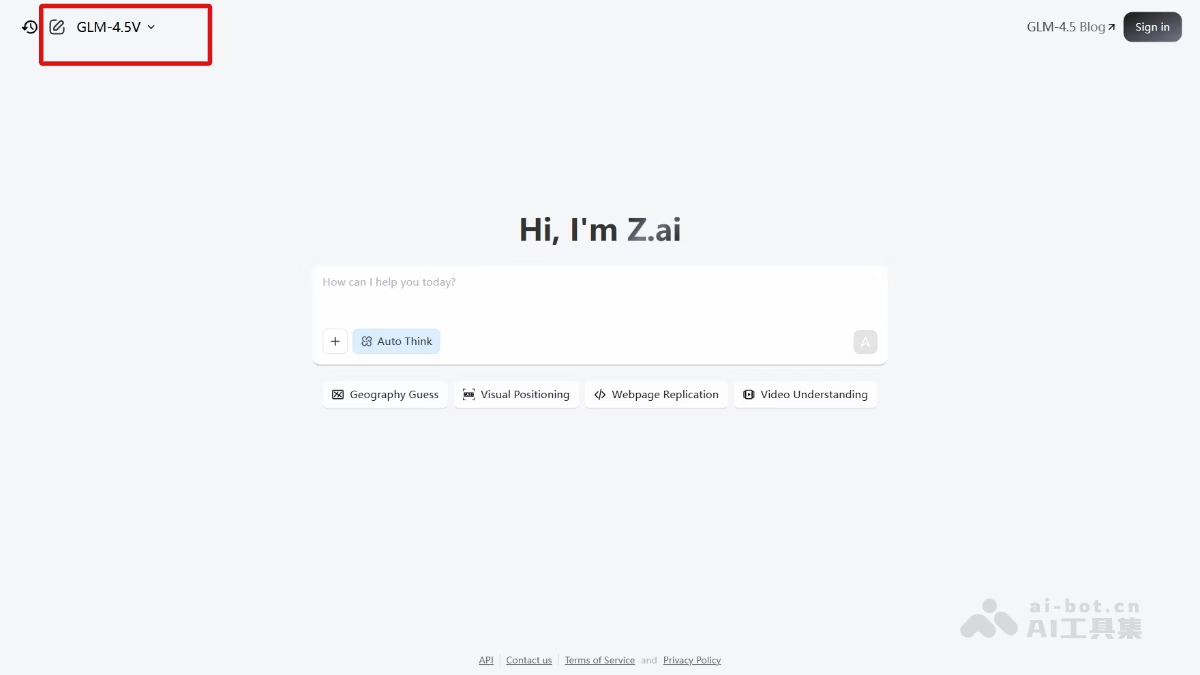
- 注册与登录:访问 Z.ai 官网,用邮箱注册账号。完成注册后,登录账号。
- 选择模型:在登录后,在模型选择下拉框中选择GLM-4.5V。
- 体验功能:
- 网页前端复刻:上传网页设计图,模型将自动生成前端代码。
- 视觉推理:上传图像或视频,模型将进行视觉理解、物体识别、场景分析等任务。
- 图寻游戏:上传目标图像,模型将在复杂场景中找到匹配的图像。
- 视频理解:上传视频文件,模型将提取关键信息,生成视频摘要或事件检测结果。
GLM-4.5V的API 调用价格
-
输入:2 元/M tokens
-
输出:6 元/M tokens
- 响应速度:达到 60-80 tokens/s
GLM-4.5V的应用场景
- 网页前端复刻:上传网页设计图,模型快速生成前端代码,助力开发者高效实现网页开发。
- 视觉问答:用户上传图像并提问,模型根据图像内容生成准确答案,可用在教育、智能客服等领域。
- 图寻游戏:在复杂场景中快速找到目标图像,适用于安防监控、智能零售及娱乐游戏开发。
- 视频理解:分析视频内容,提取关键信息生成摘要或检测事件,优化视频推荐、编辑及监控。
- 图像描述生成:为上传的图像生成精准描述文本,辅助视障人士理解图像,提升社交媒体分享体验。
📝 站长洞察 (Editor’s Insight)
智谱开源GLM-4.5V,绝非一次简单的模型迭代,而是国产多模态大模型向‘全能视觉推理工具’演进的关键一步。其12B的激活参数设计,巧妙地在性能与效率间取得了平衡,预示着‘大参数、小激活’将成为未来模型部署的主流范式之一。更值得关注的是,其在Coding(Design2Code)和Long Document OCR等任务上的强势表现,表明多模态能力正从‘感知’层向复杂的‘执行与生成’层深度渗透,这将直接赋能前端开发自动化、智能办公等垂直领域的生产力革命。配套桌面助手的开源,更是降低体验门槛、构建开发者生态的聪明之举。在GPT-4o、Gemini等国际巨头环伺下,GLM-4.5V以全栈开源、性能对标、场景落地的组合拳,展现了中国AI力量在核心模型层的快速追赶与创新自信。