
惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

WordPress大学
WordPress大学
G
Google Developers Blog
小众软件
小众软件
V
V2EX
月光博客
月光博客
腾讯CDC
aimingoo的专栏
aimingoo的专栏
J
Java Code Geeks
Y
Y Combinator Blog
人人都是产品经理
人人都是产品经理
B
Blog RSS Feed
奇客Solidot–传递最新科技情报
奇客Solidot–传递最新科技情报
Microsoft Azure Blog
博客园 - 【当耐特】
D
Docker
M
MIT News - Artificial intelligence
Google DeepMind News
N
Netflix TechBlog - Medium
Cyber Security Advisories - MS-ISAC
钛媒体:引领未来商业与生活新知
钛媒体:引领未来商业与生活新知
I
InfoQ
MongoDB | Blog
MongoDB | Blog
Apple Machine Learning Research
Jina AI
Jina AI

噜啦 - 爬虫

爬虫爬取图片 - 噜啦 爬虫爬取图片 - 噜啦 使用爬虫爬取新闻网站标题 - 噜啦 使用爬虫爬取新闻网站标题 - 噜啦 结合正则表达式爬取网页 - 噜啦
结合正则表达式爬取网页 - 噜啦
博主: 噜啦 · 2019-10-09 · via 噜啦 - 爬虫

结合正则表达式爬取网页

  • 发布时间:
  • 1658 次浏览
  • 159字数
  • 分类: Python笔记本
  1. 首页
  2. 正文  

第一个爬虫哈哈哈哈哈

代码

import requests
import re

content = requests.get('http://www.cnu.cc/discoveryPage/hot-0').text
pattern = re.compile(r'<a href="(.*?)".*?title">(.*?)</d.*?author">(.*?)</di.*?src="(.*?)"', re.S)
results = re.findall(pattern, content)
print(results)

for result in results:
    url, name, author, ads = result
    print(url, re.sub('\s', '', name), re.sub('\s', '', author), ads)

运行
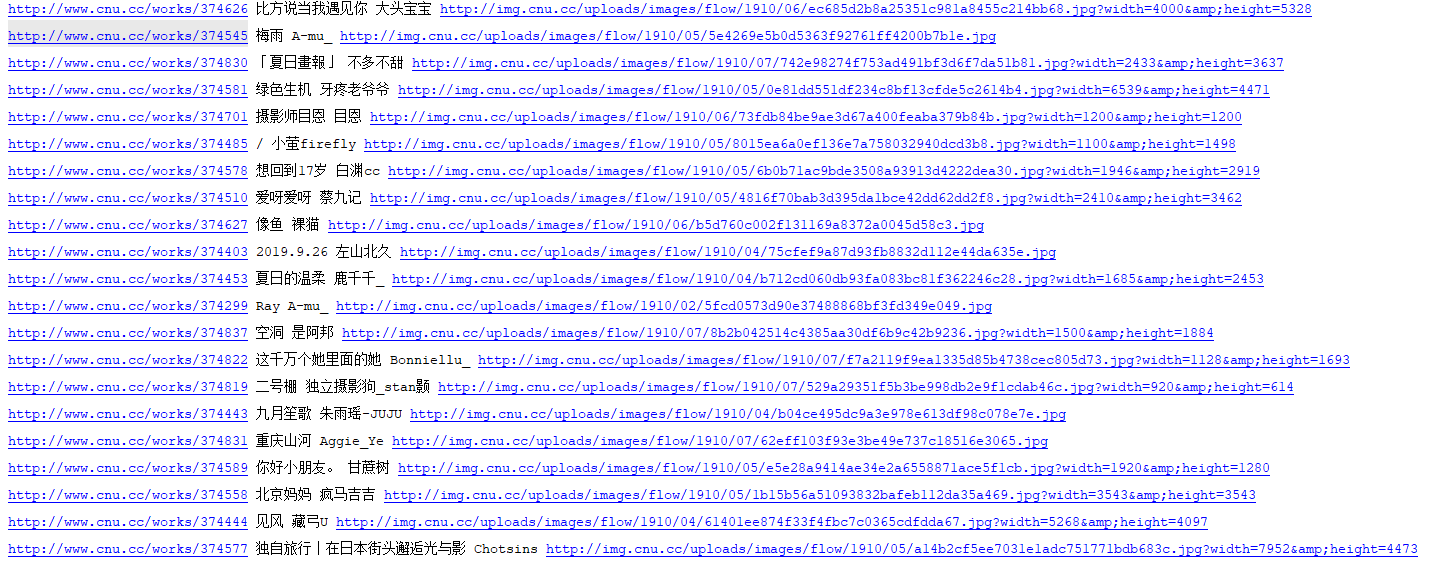

附上小姐姐图片地址

赞赏作者

如果觉得我的文章对你有用,请随意赞赏

结合正则表达式爬取网页

 •