







1. 什么是 Ops 工具
https://www.chenshaowen.com/ops/ 是我日常运维最频繁使用的工具之一。
运维机器,我可以复用之前的脚本,批量进行操作。
运维集群,我可以复用之前的脚本,不用登录节点也可以操作机器。
如果遇到新的运维问题,我会马上编写 Task Yaml 对操作进行固化,方便下一次复用。
Ops 的核心操作是脚本执行和文件分发,核心对象是主机、Kubernetes 集群。主机和集群都需要实现 Ops 的两种核心操作,最上层是 Task 编排,沉淀运维场景。
2. 为什么要写 Copilot
尝试开发基于大模型的应用。大模型提供了一种全新的使用和设计思路,代表着先进的生产方式。对于人类来说,重复、繁琐、机械的事情,只要有足够的数据积累,都可以交给大模型来完成。应用会朝着基于大模型的方向演进,我也希望自己在这个方向上多思考落地的可能。
弥补 Ops 工具场景不足的问题。Ops 可以实现有限的运维核心能力,对接有限的基础设施。但无法满足无限的运维场景,开放式的场景需要一个类似大模型这样的智能体,对场景进行肢解,转换为按照一定逻辑执行的 Ops 已经实现的核心能力。这种开发场景到有限核心能力的转换,是基于大模型的应用需要重点考虑的一个问题。
写 Copilot 比想象中简单,但需要一个使用的场景,促进思考与迭代。前段时间,一直在折腾大模型推理,这周正好有时间开发 Ops。从有想法,到开始写,再到有点效果,不到半周时间,真正写代码的时间不到一天。
能提高我的工作效率。Ops 目前有三个组件,Opscli、OpsServer、OpsController。Opscli 是命令行工具,形态上很类似一个大模型的前端,同时 Opscli 也是我高频使用的组件,在 Opscli 上集成 Copliot 有助于节省我排查故障、变更配置所需的时间。
3. 聊聊我的思路
3.1 处理流程
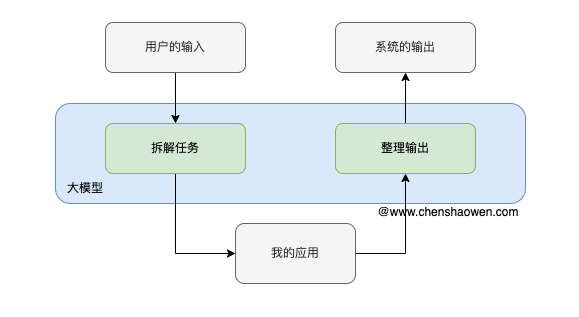
如上图:
- 用户的输入,可能是一条文本,一个点击,当然也可以是一个事件
- 大模型需要针对这个输入,将其转换为系统内部的若干步骤
- 我的应用执行这一系列的任务
- 大模型整理这些任务的执行结果,给出一个输出。这个输出可能是一个提示,一个弹框,一个文本,一个事件。
3.2 拆解任务
在上面处理流程中,第一个难点就是如何拆分任务。
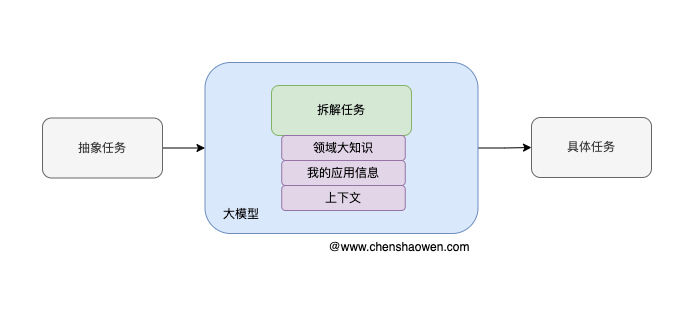
如上图:
人的思维是方向性的,人的描述是抽象的。
比如,人饿的时候说,”我饿了“,”我要吃饭“。但这种表述,对于机器来说,是无法理解的。你得说,“我在半个小时之后,在家里,吃饭,一碗米饭,一个番茄炒鸡蛋,一个炒青菜”,这样才是机器能够理解,并且可以得以执行的。
这种抽象的任务转换为具体任务 TodoList 的过程,就是 Copilot 需要完成的核心功能之一。
在拆解任务的过程中,除了需要大模型本身的智能外,还需要:
- 领域大知识,大模型掌握的是泛泛的知识,比如文化习惯、语言习惯、行为习惯等,但是对于具体的、最新的领域知识,大模型是来不及学习的,也没有足够的语料来学习。如果能通过动态加载 lora 微调的方式、向量知识库,来加载领域知识,会是一个很好的方式。
- 我的应用相关的信息。我的应用对于大模型来说,是一个黑盒,全新、陌生、不了解的新事物。只有让大模型理解我的应用,才能更好的拆解任务。
- 上下文。每次事件的响应,都需要考虑上下文。哪一个用户,哪一个数据库,哪一个集群,哪一个操作系统等,这些组成了上下文信息。
有了这些补充,大模型就可以将抽象的任务转换为具体的任务,以供我的应用执行。
3.3 对大模型暴露应用信息
这又是一个我需要继续优化 Ops 工具的地方。
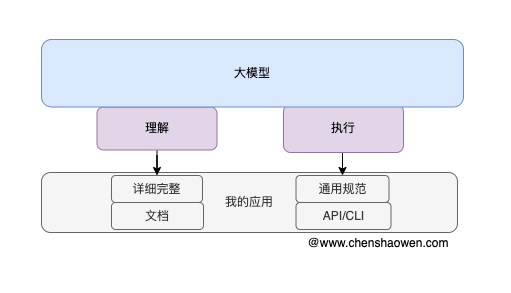
如上图:
为了让大模型更好理解我的应用,我需要将应用详细完整的文档提交给大模型。但提交全部的文档给大模型,不具备可行性。你不仅要克服大模型处理的最长文本限制,还需要考虑因长文本导致的中间段信息丢失的问题。因此,最好的办法就是提交一个 Schema,提交你的设计思路,而不是提交你的设计实现。
同理的还有 API\CLI 的实现,不要将一个一个接口 URL、参数、返回值都提交给大模型,而是要告诉大模型,你的 API\CLI 的设计思路是什么。
但这对应用的设计者提出了非常高的要求,我们不能再人云亦云、到处抄袭,而是要让产品有简单、自洽、统一的设计。
4. 现在啥进度、未来啥计划
目前 Ops 的 Copilot 还处于非常初级的阶段,实现了类似 open-interpreter 的功能。
opscli copilot 能够根据用户的输入,在本地执行脚本,输出结果,完成类似,打开浏览器、查询 Kubernetes 集群各种信息、关闭微信应用等任务。
如果开发顺利,我希望 opscli copilot 能演化为一个单独的服务 OpsCopilot,对接 OpsCli、OpsServer、OpsController。
同时,Copilot 也不会依赖任何 GPT-3.5、GPT-4 等模型专有的一些功能特性,比如 function call 等,保持 Copilot 的通用性,而不是兼容性。