1. Etcd 基本介绍
Etcd 是一个分布式 Key/Value 的存储系统,通过分布式锁、leader 选举、写屏障(write barriers) 实现了分布式协作,提供高可用、持久化数据存储和检索服务。
每个 Etcd 节点都存储了一份完整的数据,任意时刻至多存在一个主节点。主节点处理所有来自客户端的写请求,并且通过 Raft 协议同步到其他节点。
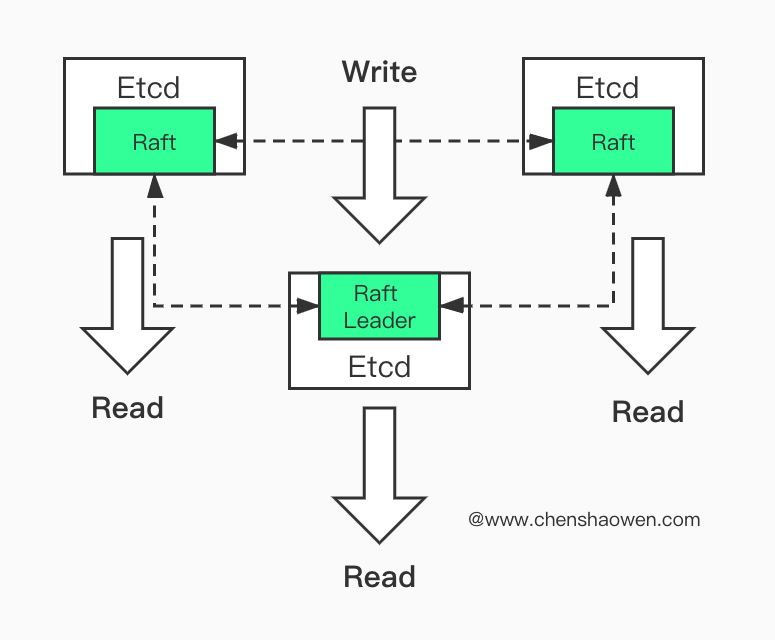
Etcd 数据持久化使用 WAL (write ahead log,预写式日志) 格式,在提交之前先写入 WAL,默认每 1W 条记录,做完快照之后,WAL 文件会被删除。
Etcd 在内存中,以 B 树对 Key 值建立索引,在磁盘中,以 B+ 树对 Value 进行存储记录历史版本。
2. Etcd 节点数要求
Etcd 节点越多,容错能力越强,写性能越差。官方推荐的 etcd 集群节点数量为 3,5,7。Etcd 集群最少需要 [N/2] + 1 个节点工作,才能保证集群正常。下面是集群节点数和最大容错节点数量对应表:
奇数个节点与偶数个节点,具有相同的容错能力。
3. 硬件环境要求
3.1 限制 Etcd 性能的因素
Etcd 对内存和 CPU 消耗并不高,足够就行。
一次 Etcd 请求的最小时间 = 成员节点之间的网络往返时延 + 收到数据之后进行持久化的时延。因此,Etcd 的性能主要受两方面的约束:
多节点的 Etcd 集群成员节点应该尽量部署在同一个数据中心,减少网络时延。同一数据中心内,不同节点的网络情况通常是非常好的,如果需要测试可以使用 ping 或 tcpdump 命令进行分析。下面主要讨论看看推荐的配置和硬盘 IO 测试方法。
3.2 CPU、内存建议配置
| Cluster Node | Data Size | vCPUs | Memory (GB) | Max concurrent IOPS | Disk bandwidth (MB/s) |
|---|
| 50 | no more than 100 MB | 2 | 8 | 3600 | 56.25 |
| 250 | no more than 500 MB | 4 | 16 | 6000 | 93.75 |
| 1000 | no more than 1 GB | 8 | 32 | 8000 | 125 |
| 3000 | more than 1 GB | 16 | 64 | 16,000 | 250 |
3.3 硬盘 IOPS 测试方法
Etcd 对磁盘写入延时非常敏感,通常要求达到 50 IOPS 以上,对于高负载的集群应该达到 500 IOPS 。常用的磁盘基准测试工具 diskbench 、 fio 。这里以 CentOS 上使用 fio 为例:
1
2
3
4
5
| fdisk -l
Disk /dev/vda: 107.4 GB, 107374182400
...
Disk /dev/vdb: 34.4 GB, 34359738368
|
1
2
3
| fio -filename=/dev/vda -direct=1 -iodepth 64 -thread -rw=randwrite -ioengine=libaio -bs=4K -numjobs=8 -runtime=120 -group_reporting -name=test1
write: IOPS=1288, BW=5153KiB/s (5277kB/s)(605MiB/120206msec)
|
1
2
3
| fio -filename=/dev/vda -direct=1 -iodepth 64 -thread -rw=write -ioengine=libaio -bs=512K -numjobs=8 -runtime=120 -group_reporting -name=test2
write: IOPS=102, BW=51.1MiB/s (53.6MB/s)(2453MiB/48023msec)
|
其中,filename 为测试设备,更多参数可以查看上面的 GitHub 链接。这里得到 IOPS 为 1288,磁盘带宽为 53.6 MB/s 。
4. 安装 Etcdctl
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
| export ETCD_VER=v3.4.10
export ETCD_DIR=etcd-download
export DOWNLOAD_URL=https://github.com/coreos/etcd/releases/download
mkdir ${ETCD_DIR}
cd ${ETCD_DIR}
wget ${DOWNLOAD_URL}/${ETCD_VER}/etcd-${ETCD_VER}-linux-amd64.tar.gz
tar -xzvf etcd-${ETCD_VER}-linux-amd64.tar.gz
cp etcd-${ETCD_VER}-linux-amd64/etcdctl /usr/local/bin/
|
在使用 Etcdctl 过程中,需要节点证书。有两种方式提供证书:
- 在命令行中
1
| ETCDCTL_API=3 etcdctl --cacert=/etc/ssl/etcd/ssl/ca.pem --cert=/etc/ssl/etcd/ssl/node-node1.pem --key=/etc/ssl/etcd/ssl/node-node1-key.pem endpoint health
|
或者
1
2
3
4
5
| ETCDCTL_API=3 etcdctl \
--cacert=/etc/kubernetes/pki/etcd/ca.crt \
--cert=/etc/kubernetes/pki/etcd/server.crt \
--key=/etc/kubernetes/pki/etcd/server.key \
endpoint health
|
这样就要求,每条 Ectdctl 命令都需要加上证书和版本相关参数。
- 通过环境变量注入
1
2
3
4
| export ETCDCTL_API=3
export ETCDCTL_CACERT=/etc/ssl/etcd/ssl/ca.pem
export ETCDCTL_CERT=/etc/ssl/etcd/ssl/node-node1.pem
export ETCDCTL_KEY=/etc/ssl/etcd/ssl/node-node1-key.pem
|
或者
1
2
3
4
| export ETCDCTL_API=3
export ETCDCTL_CACERT=/etc/kubernetes/pki/etcd/ca.crt
export ETCDCTL_CERT=/etc/kubernetes/pki/etcd/server.crt
export ETCDCTL_KEY=/etc/kubernetes/pki/etcd/server.key
|
可以将这些环境变量设置在 /etc/profile 中,然后 source /etc/profile ,就可以直接使用下面的命令进行操作。
1
| etcdctl endpoint health
|
5. Etcdctl 常见运维操作
1
| curl http://127.0.0.1:2381/metrics |grep etcd_server_is_leader
|
尽量先操作 slave 节点,避免影响集群的正常工作。
1
| etcdctl endpoint status --write-out=table
|
1
| etcdctl member list --write-out=table
|
1
2
3
| rev=$(etcdctl endpoint status --write-out="json" | egrep -o '"revision":[0-9]*' | egrep -o '[0-9].*')
echo $rev
etcdctl compact $rev
|
增加节点
1
| etcdctl member add etcd-member-node http://192.168.11.102:2383
|
删除节点
1
| etcdctl member remove 9855cd41eff59e2b
|
备份
1
| etcdctl snapshot save snapshot-xxx.db
|
恢复时,需要停止全部 apiserver、etcd 实例,删除当前的 etcd 数据,然后拷贝备份数据到每个 etcd 节点上,执行命令
1
| etcdctl snapshot restore snapshot-xxx.db
|
1
| etcdctl endpoint health
|
1
| etcdctl endpoint status --write-out=json | jq -r '.[] | "\(.endpoint) \(.Status.header.revision)"'
|
1
| vim /etc/kubernetes/manifests/etcd.yaml
|
添加一下参数,默认是 2GB 调整为 8GB。
1
| - --quota-backend-bytes=8589934592
|
建议也顺便调整下监控的地址
1
| - --listen-metrics-urls=http://0.0.0.0:2381
|
重启 etcd
1
2
| mv /etc/kubernetes/manifests/etcd.yaml ./
mv ./etcd.yaml /etc/kubernetes/manifests/
|
- 扩容 etcd DB 存储大小(Systemd 版)
添加一下参数,默认是 2GB 调整为 8GB。
1
| ETCD_QUOTA_BACKEND_BYTES=8589934592
|
建议也顺便调整下监控的地址,监听在 0.0.0.0 上。
1
| ETCD_LISTEN_METRICS_URLS=http://0.0.0.0:2381
|
重启 etcd
1
2
3
| systemctl daemon-reload
systemctl restart etcd
systemctl status etcd
|
如果 etcd 发生了异常,可能会触发报警,可以通过下面的命令清理报警后恢复使用
具体某个 Key
1
| etcdctl get /registry/namespaces/default
|
根据前缀查询
1
| etcdctl get / --prefix --keys-only
|
增加/修改
1
| etcdctl put key newVaule
|
6. 查看 Etcd 证书
1
2
3
4
5
6
7
| ETCD_CERT_DIR="/etc/kubernetes/pki/etcd"
for cert in "$ETCD_CERT_DIR"/*.crt; do
echo "===== $cert ====="
openssl x509 -in "$cert" -noout -dates -text | grep -E 'DNS|IP|notAfter|notBefore'
echo
done
|
7. 更新 etcd 证书
有次遇到报错 {“level”:“warn”,“ts”:“2025-12-15T01:37:34.735Z”,“caller”:“embed/config_logging.go:160”,“msg”:“rejected connection”,“remote-addr”:“10.10.101.131:28508”,“server-name”:"",“ip-addresses”:[“10.10.101.196”,“127.0.0.1”,"::1"],“dns-names”:[“mycluster-master-01”,“localhost”],“error”:“tls: "10.10.101.131" does not match any of DNSNames ["mycluster-master-01" "localhost"]”}, 更新证书后解决了这个问题。
需要在每个节点上操作。
1
2
3
| cp -a /etc/kubernetes/pki/etcd /etc/kubernetes/pki/etcd.bak.$(date +%F)
ls -l /etc/kubernetes/pki/etcd.bak.*
|
1
| rm -rf /etc/kubernetes/pki/etcd/{healthcheck-client.key,peer.key,server.key,healthcheck-client.crt,peer.crt,server.crt}
|
每个节点的 InitConfiguration 不同,而 ClusterConfiguration 相同。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
| cat > /root/kubeadm-etcd-cert.yaml <<EOF
apiVersion: kubeadm.k8s.io/v1beta3
kind: InitConfiguration
nodeRegistration:
name: mycluster-worker-03
localAPIEndpoint:
advertiseAddress: 10.10.10.19
---
apiVersion: kubeadm.k8s.io/v1beta3
kind: ClusterConfiguration
etcd:
local:
serverCertSANs:
- 127.0.0.1
- localhost
- 10.10.10.196
- 10.10.10.131
- 10.10.10.48
- mycluster-master-01
- mycluster-master-02
- mycluster-master-03
- mycluster-worker-03
- 10.10.10.19
peerCertSANs:
- 127.0.0.1
- localhost
- 10.10.10.196
- 10.10.10.131
- 10.10.10.48
- mycluster-master-01
- mycluster-master-02
- mycluster-master-03
- mycluster-worker-03
- 10.10.10.19
EOF
|
etcd 实例的只需要共用 ca.crt 和 ca.key,其它证书每个节点的 SANs 都不一样。这里使用相同的 ClusterConfiguration 配置不是最佳实践。
1
2
3
4
| kubeadm init phase certs etcd-server --config=/root/kubeadm-etcd-cert.yaml
kubeadm init phase certs etcd-peer --config=/root/kubeadm-etcd-cert.yaml
kubeadm init phase certs etcd-healthcheck-client
kubeadm init phase certs apiserver-etcd-client
|
这样生成的证书有效期是一年。
1
2
| mv /etc/kubernetes/manifests/etcd.yaml /etc/kubernetes/etcd.yaml
mv /etc/kubernetes/etcd.yaml /etc/kubernetes/manifests/etcd.yaml
|
1
| systemctl restart kubelet
|
不重启 kubelet 可能无法更新 etcd 静态 Pod,有时需要强制删除之前的 etcd Pod 才能更新。
1
2
3
4
5
6
| ETCDCTL_API=3 etcdctl \
--endpoints=https://127.0.0.1:2379 \
--cacert=/etc/kubernetes/pki/etcd/ca.crt \
--cert=/etc/kubernetes/pki/etcd/healthcheck-client.crt \
--key=/etc/kubernetes/pki/etcd/healthcheck-client.key \
endpoint health
|
8. 添加新 etcd 节点
1
2
| export ETCD_NODE_NAME="mycluster-worker-03"
export ETCD_NODE_IP="10.10.10.19"
|
1
| rsync -avz /etc/kubernetes/pki/ root@${ETCD_NODE_NAME}:/etc/kubernetes/pki/
|
1
| scp /etc/kubernetes/manifests/etcd.yaml ${ETCD_NODE_NAME}:/etc/kubernetes/manifests/
|
在新节点上修改 etcd.yaml 文件,加入新节点的 IP 和 节点名。
1
| vim /etc/kubernetes/manifests/etcd.yaml
|
1
2
3
4
5
6
7
8
| - etcd
- --advertise-client-urls=https://10.10.10.19:2379
- --initial-advertise-peer-urls=https://10.10.10.19:2380
- --listen-client-urls=https://127.0.0.1:2379,https://10.10.10.19:2379
- --listen-peer-urls=https://10.10.10.19:2380
- --name=mycluster-worker-03
- --initial-cluster-state=existing
- --initial-cluster=节点名称=https://节点IP:2380,....
|
这里需要将拷贝过来的节点名称和 IP 修改为新节点的信息,同时在 initial-cluster 中加入新节点的信息。
1
| ETCDCTL_API=3 etcdctl member add ${ETCD_NODE_NAME} --peer-urls=https://${ETCD_NODE_IP}:2380
|
1
| etcdctl member list --write-out=table
|
1
2
3
4
5
6
7
8
| +------------------+---------+------------------------------+---------------------------+---------------------------+------------+
| ID | STATUS | NAME | PEER ADDRS | CLIENT ADDRS | IS LEARNER |
+------------------+---------+------------------------------+---------------------------+---------------------------+------------+
| 1dedee291bb2dbf4 | started | mycluster-master-01 | https://10.10.10.196:2380 | https://10.10.10.196:2379 | false |
| 3fc9d9f2f70c4eb1 | started | mycluster-master-03 | https://10.10.10.48:2380 | https://10.10.10.48:2379 | false |
| 4e5bde4408acfe80 | started | mycluster-master-02 | https://10.10.10.131:2380 | https://10.10.10.131:2379 | false |
| f81188de9fede0d3 | started | mycluster-worker-03 | https://10.10.10.19:2380 | https://10.10.10.19:2379 | false |
+------------------+---------+------------------------------+---------------------------+---------------------------+------------+
|
9. 安装 etcdhelper
Etcdctl 不能直接查看数据内容,需要借助 Etcdhelper 工具。
1
2
3
4
5
| git clone https://github.com/openshift/origin.git
cd origin
go env -w GOPROXY=https://mirrors.aliyun.com/goproxy/,direct
go build tools/etcdhelper/etcdhelper.go
mv etcdhelper /usr/local/bin/
|
1
| etcdhelper -cacert /etc/kubernetes/pki/etcd/ca.crt -key /etc/kubernetes/pki/etcd/server.key -cert /etc/kubernetes/pki/etcd/server.crt get /registry/pods/xxx/xxx
|
得到 Etcd 中的 JSON 格式数据。
10. 参考



