1. 解耦引擎释放流水线能力
在设计系统时,我们常面临两难。是内敛复杂度,对外提供单一易用的功能;还是释放复杂度,将灵活归还用户。这非常考验产品能力。
设计 CICD 系统时,我们可以直接将 Jenkinsfile、PipelineRun 等概念直接抛给用户,让用户自己学习相关领域的知识,再来使用产品。当然,也可以继续抽象,在人与系统之间建立模型,实现意识与指令的转换。我们想要更加易用的产品,因此选择屏蔽底层概念,继续抽象、建模。
从 Jenkins 、GitLab CI,再到 GitHub Actions、Tekton,新的基础设施总会有各种各样的基础组件涌现。我们想减少这种切换的成本,在各种引擎之间能够切换。技术在不断地更替,但我们想对用户保持一致。
虽然流水线相关技术在快速演进,但执行这件事的终究是人。人的知识是有传承的,无论技术怎样变化,做流水线引擎的社区是相对稳定的,都是有交集的一群人。这给解耦引擎,设计通用流水线提供了可能。
2. 流水线的数据模型
在很多 CICD 引擎中,能够找到相似的概念。
流水线包含很多个 Stage,而 Stage 中的 steps 包含多个串行执行的脚本。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
| pipeline {
agent any
stages {
stage('Build') {
steps {
echo 'Building-1..'
echo 'Building-2..'
}
}
stage('Test') {
steps {
echo 'Testing..'
}
}
stage('Deploy') {
steps {
echo 'Deploying....'
}
}
}
}
|
流水线包含 build、test 两个 串行的 Stage,每个 Stage 包含若干并行执行的 Job 。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
| stages:
- build
- test
build-code-job:
stage: build
script:
- echo "Check the ruby version, then build some Ruby project files:"
- ruby -v
- rake
test-code-job1:
stage: test
script:
- echo "If the files are built successfully, test some files with one command:"
- rake test1
test-code-job2:
stage: test
script:
- echo "If the files are built successfully, test other files with a different command:"
- rake test2
|
流水线由 jobs 定义,一个流水线有很多个可能的 job(示例中的 build 构成),每个 job 又包含很多串行的 steps。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
| name: Octo Organization CI
on:
push:
branches: [$default-branch]
pull_request:
branches: [$default-branch]
jobs:
build:
runs-on: ubuntu-latest
steps:
- uses: actions/checkout@v2
- name: Run a one-line script
run: echo Hello from Octo Organization
|
基于以上的示例,我们对 Pipeline 进行抽象。
1
2
3
4
5
6
7
| - pipeline
- stage-1
- step-1-1
- step-1-2
- stage-2
- step-2-1
- ...
|
如下图,一个流水线包含若干个 Stage, Stage 可以并行或者串行。Stage 中包含若干个串行的 Step 执行脚本。而在 Tekton 中,Stage 对应着 Task 。
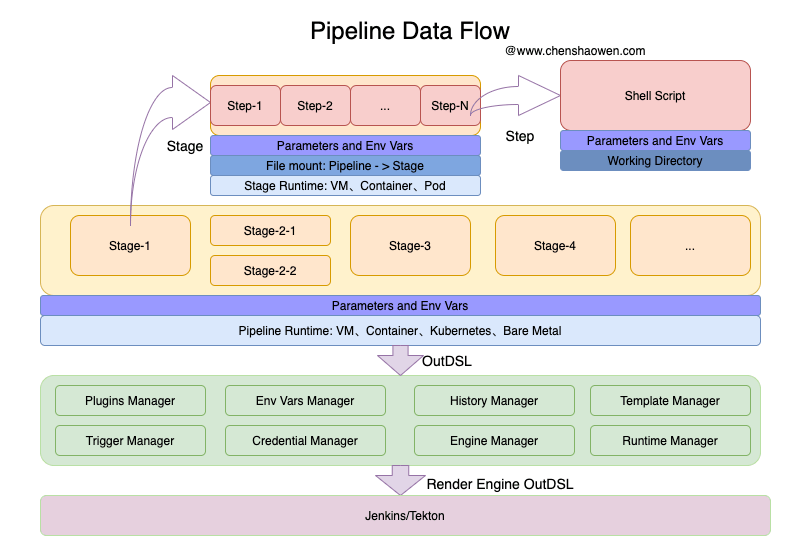
一个流水线的运行时,可以是一个 Kubernetes 集群、一个物理机、一个 Container 环境等。
一个 Stage 的运行时,可能是一个 Pod、一个物理机、一个 Container 环境等。
一个 Step 有一个工作空间,然后执行 Shell Script。
流水线并不需要复杂的定义,即使几个简单的脚本,也可以编排复杂的逻辑。但是对流水线进行抽象和建模,有利于插件(Step)扩展,流水线产品本身的开发和维护。
流水线会经过一系列的 Manager 处理,与特定的运行时、执行引擎、凭证等关联起来。最终渲染出引擎接受的流水线描述,例如 Jenkins 的 Jenkinsfile、Tekton 的 Yaml。
3. 代码层的数据模型
下面给出核心数据结构的主要字段:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
| // 定义运行时
type Runtime struct {
Name string
Provider interface{}
}
// 定义引擎
type Engine string
// 定义作用域,分为三个层级。
type Scope string
const (
ScopePipeline Scope = "Pipeline"
ScopeStage Scope = "Stage"
ScopeStep Scope = "Step"
)
// 定义参数结构
type ParamSpec struct {
Name string `json:"name"`
Scope ParamType `json:"type,omitempty"`
Default interface{} `json:"default,omitempty"`
}
// 定义插件模板
type Step struct {
Name string `json:"name"`
Params []ParamSpec `json:"params,omitempty"`
Script string `json:"script,omitempty"`
Engine string `json:"engine"`
Workspace string `json:"workspace,omitempty"`
}
// 定义组装流水线之后,插件(Step)相关字段
type PipelineStep struct {
Name string `json:"name,omitempty"`
StepRef string `json:"StageRef,omitempty"`
Params []Param `json:"params,omitempty"`
Status string `json:"status,omitempty"`
Workspace string `json:"workspace,omitempty"`
}
// 定义 Stage ,主要是一系列的 Steps
type Stage struct {
ObjectMeta `json:"metadata"`
Spec StageSpec `json:"spec"`
}
type StageSpec struct {
Description string `json:"description,omitempty"`
Params []ParamSpec `json:"params,omitempty"`
Steps []PipelineStep `json:"steps,omitempty"`
Workspace string `json:"workspace,omitempty"`
}
// 定义组装流水线之后,阶段(Stage)相关字段
type PipelineStage struct {
Name string `json:"name,omitempty"`
StageRef Stage `json:"stageRef,omitempty"`
Params []Param `json:"params,omitempty"`
Workspace string `json:"workspace,omitempty"`
Status string `json:"status,omitempty"`
Runtime *Runtime
}
// 定义流水线的结构
type Pipeline struct {
ObjectMeta `json:"metadata"`
Spec PipelineSpec `json:"spec"`
}
type PipelineSpec struct {
Params []ParamSpec `json:"params,omitempty"`
Stages []PipelineStage `json:"stages,omitempty"`
Workspace string `json:"workspace,omitempty"`
}
// 定义运行一条流水线相关的字段
type PipelineRun struct {
ObjectMeta `json:"metadata,omitempty"`
Spec PipelineRunSpec `json:"spec,omitempty"`
Status string `json:"status,omitempty"`
}
type PipelineRunSpec struct {
PipelineRef string `json:"pipelineRef,omitempty"`
Params []Param `json:"params,omitempty"`
Runtime *Runtime
}
|
在代码层面,需要注意两点:
- 模板与实例。模板是系统内置的引擎相关的框架或片段,例如 Step、Stage、Pipeline ;而实例是填充个性化参数之后的模板或片段,PipelienStep、PipelineStage、PipelineRun 。
- 作用范围。参数中有一个字段 Scope ,用于表示参数在什么范围可见。实际上,真正使用参数的是 Step,但是组装之后 Stage 作用域的参数会被提升到 Stage 中。同理,Pipeline 作用域的参数会被提升到 Pipeline 中。参数在不同的层级会有不同的用处,从内向外抽取,从外向内注入。
4. 流水线运行时的数据与交互
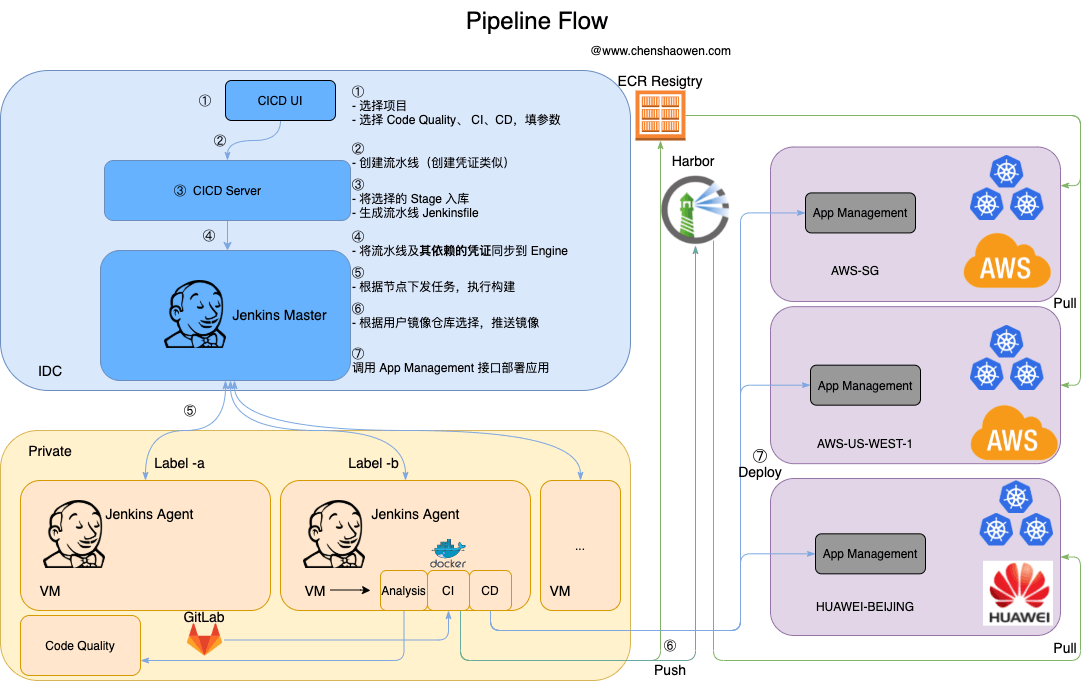
上面是一个流水线的执行流程,可以对照着每个步骤查看,这里不再重复。下面主要以不同角色的视角描述流水线的运行。
4.1 系统内置 Step 插件模板
首先需要在系统中内置一些常用的插件 Script。
例如,Jenkins 的 Git Clone 插件
1
| git(url: '${param.git_repo}', credentialsId: '${param.ssh-key}', branch: '${param.branch}', changelog: true, poll: false)
|
Jenkins 的构建并推送镜像。
1
2
3
4
5
| withCredentials([usernamePassword(passwordVariable : 'DOCKER_PASSWORD' ,usernameVariable : 'DOCKER_USERNAME' ,credentialsId : "${param.credential_id}" ,)]) {
sh 'echo "$DOCKER_PASSWORD" | docker login ${param.registry_server} -u "$DOCKER_USERNAME" --password-stdin'
sh 'docker push ${param.image_name}'
sh 'docker logout'
}
|
Jenkins 执行脚本。
1
| sh '${param.script_content}'
|
当然也可以是其他引擎的插件片段,但主要是脚本片段 + 参数注入,因此不再列举。
4.2 创建流水线时,用户视角
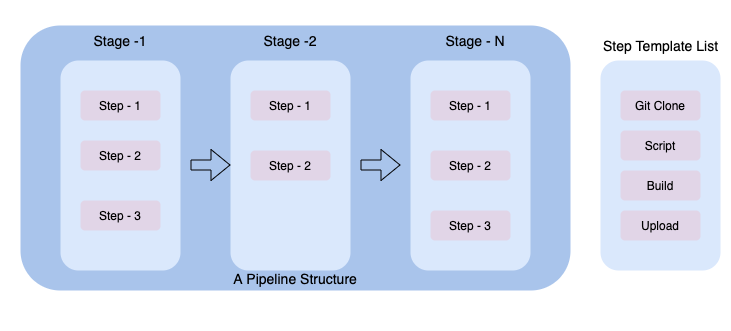
如上图,用户首先会根据用户选择的引擎,得到一个 Step 模板列表。然后通过编排,将 Step 组装成一个流水线。
其中,Step-1、2、3 表示的是选择一个模板 Step 并初始化参数的实例。然后组装出 Pipeline 的数据结构保存在后端。
如果是使用模板进行创建,那么只需要提前帮用户初始化 Pipeline 数据结构即可。
4.3 创建流水线,开发人员视角
请求 Step 模板列表之后,根据用户输入的实例化参数,组装 Pipeline 结构。
将用户的 Pipeline 数据保存之后,根据 Step 模板信息,将 Pipeline 渲染成引擎需要的流水线描述。例如,生成 Jenkinsfile 文件,同步到 Jenkins 创建流水线。
4.4 运行时,数据流向及交互
前端调用后端接口,获取 Pipeline 的定义,将 Pipeline 级别的参数弹框,让用户输入相关的参数。点击确认后,创建 PipelineRun 对象。
后端根据 PipelineRun 对象,触发引擎的执行接口,将 PipelineRun 中定制化的参数传入流水线执行。
PipelineRun 即为流水线的执行历史,需要从引擎中查询流水线的状态,并写入 PipelineRun 对象。
在 PipelineRun 中记录有某次执行的全部记录,包括参数、Pipeline 定义。因此,只要引擎支持上述功能,都可以实现。



