惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

雷峰网
雷峰网
博客园 - 聂微东
酷 壳 – CoolShell
酷 壳 – CoolShell
宝玉的分享
宝玉的分享
奇客Solidot–传递最新科技情报
奇客Solidot–传递最新科技情报
罗磊的独立博客
Hugging Face - Blog
Hugging Face - Blog
T
Tailwind CSS Blog
OSCHINA 社区最新新闻
OSCHINA 社区最新新闻
IT之家
IT之家
博客园_首页
博客园 - 三生石上(FineUI控件)
博客园 - 叶小钗
Apple Machine Learning Research
freeCodeCamp Programming Tutorials: Python, JavaScript, Git & More
量子位
钛媒体:引领未来商业与生活新知
钛媒体:引领未来商业与生活新知
人人都是产品经理
人人都是产品经理
美团技术团队
小众软件
小众软件
Jina AI
Jina AI
S
SegmentFault 最新的问题
博客园 - Franky
让小产品的独立变现更简单 - ezindie.com

陈少文的网站

巨变与机遇的未来十年 Kubernetes 平台管理软件压力测试方案 使用镜像部署 Hexo 静态页面 终于等到你 - GitHub 镜像仓库服务(ghcr.io) 一起来学 Go --(6)Interface 一起来学 Go --(5)Goroutine 和 Channel 什么是函数式编程 如何在 Kubernetes 集群集成 Kata 柯里化与偏函数 使用 PyGithub 自动创建 Label 软件产品是团队能力的输出 Helm 2 、Helm 3 比较 IoT 变现 Kubernetes 中的 DNS 服务 国内的 Helm 镜像源 Harbor 使用自签证书支持 Https 访问 DevOps 工具链之 Prow 如何使用 kfctl 安装 Kubeflow VS Code 无法下载 Go 插件的工具包 工程师更应具有服务精神 你不知道的 Docker 使用技巧 使用 Docker 运行 Tensorflow 论中国 什么是左移 如何清空 Git 仓库全部历史记录 一禅小和尚 有风吹过厨房 时间的玫瑰 如何在 CentOS 安装 GPU 驱动 开发 Tips(19)
高频 IO 的 POD 并不适合设置 Limit
微信公众号 · 2024-06-04 · via 陈少文的网站

Please enable Javascript to view the contents

1. 现象

基于 Kubernetes 的 Elasticsearch 频繁重启,导致服务几乎不可用。

  1. 在导入数据过程中,Pod 的内存使用持续增长
  2. Pod 内存使用接近 Limit 之后,继续导入就会触发 Pod 异常退出,错误日志 ERROR: Elasticsearch exited unexpectedly
  3. Pod 内存使用率并不会下降,而是维持在 Limit 附近,不久又异常退出

Elasticsearch Pod 内存限制在 64GB,而 JVM 内存限制是 32GB。

2. 查看运行环境

由于 Elasticsearch Pod 频繁出现 Crash、OOMkilled 状态,我对运行环境进行了一次检测。

  • 集群及内核版本
1
2
3
kubectl get nodes -o wide

ascend-910b-1     Ready    node                   11d    v1.25.6   x.x.x.x   <none>        Ubuntu 22.04.2 LTS   5.15.0-60-generic   docker://20.10.7

系统内核版本、集群版本都挺高。

  • 查看节点负载
1
2
3
4
5
6
7
8
9
kubectl top node

NAME               CPU(cores)   CPU%   MEMORY(bytes)   MEMORY%
ascend-910b-01     19964m       11%    592344Mi        28%
ascend-910b-02     12921m       7%     273261Mi        13%
ascend-910b-03     16192m       9%     767870Mi        37%
ascend-910b-04     15930m       9%     615426Mi        29%
ascend-910b-05     13048m       7%     278558Mi        13%
ascend-910b-06     13258m       7%     637063Mi        30%

每个节点的 CPU、内存使用率都很低,没有超过 50%。每个节点都配备有 176C 处理核心、2.0TB 内存。

  • 节点内存使用
1
2
3
4
free  -h
               total        used        free      shared  buff/cache   available
Mem:           2.0Ti       232Gi        13Gi        52Gi       1.7Ti       1.7Ti
Swap:             0B          0B          0B

大量的 Cache 使用引起了我的注意。

3. 原因

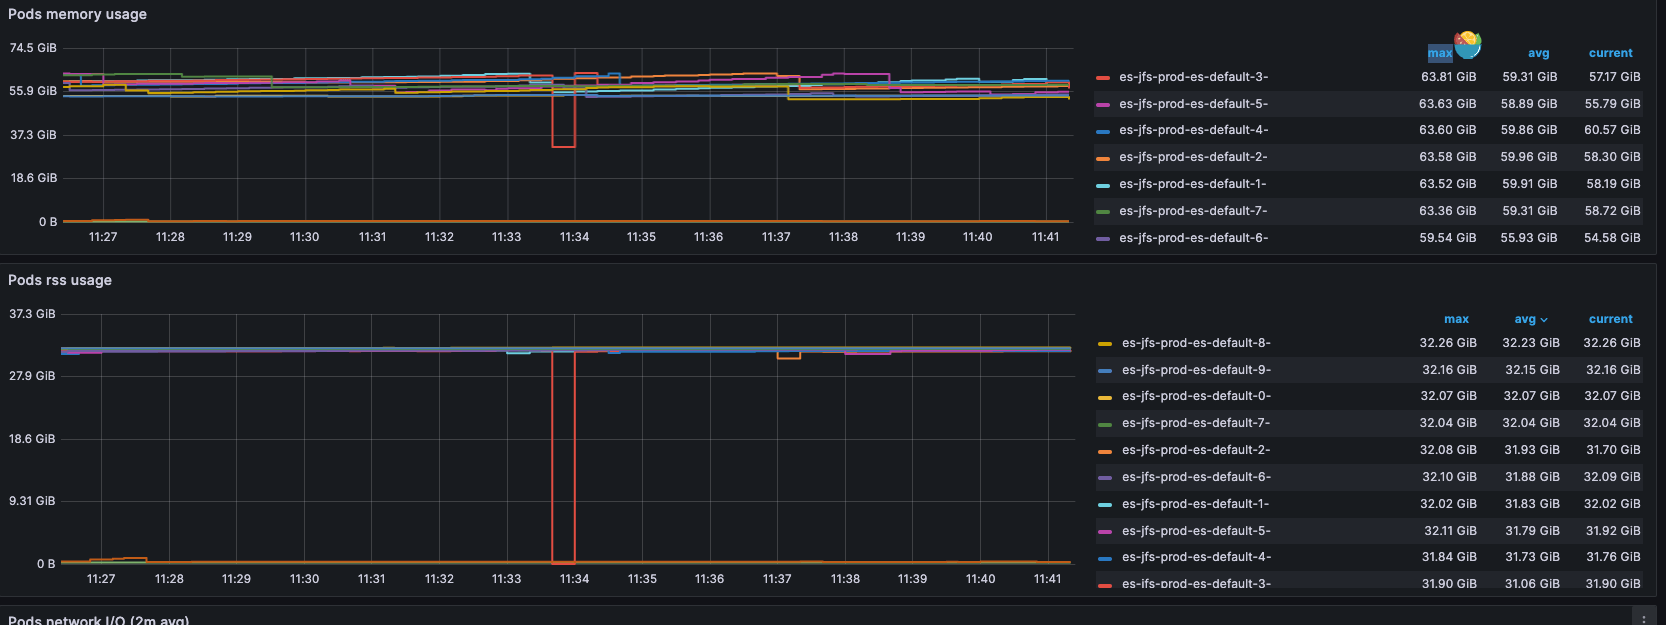
容器 Memory OOM 的触发指标是 container_memory_working_set_bytes,其实际组成为 RSS + Cache。

RSS 是指进程当前在物理内存中所占用的空间大小,包括代码、数据和堆栈等。

Cache 是指操作系统用于缓存最近访问过的文件数据的一部分内存。这些数据通常是从磁盘读取的文件内容,被缓存在物理内存中系统中的 Cache 高时,表示系统中有大量的内存被用于缓存最近访问过的文件数据,即大量 IO 操作带来的 Cache 压力。

从上面的监控可以看到 Elasticsearch 的 RSS 使用量一直维持在 32GB,只能是 Cache 不断在增长了。

接着不设置 Limit 观测 Elasticsearch Pod 内存使用情况。
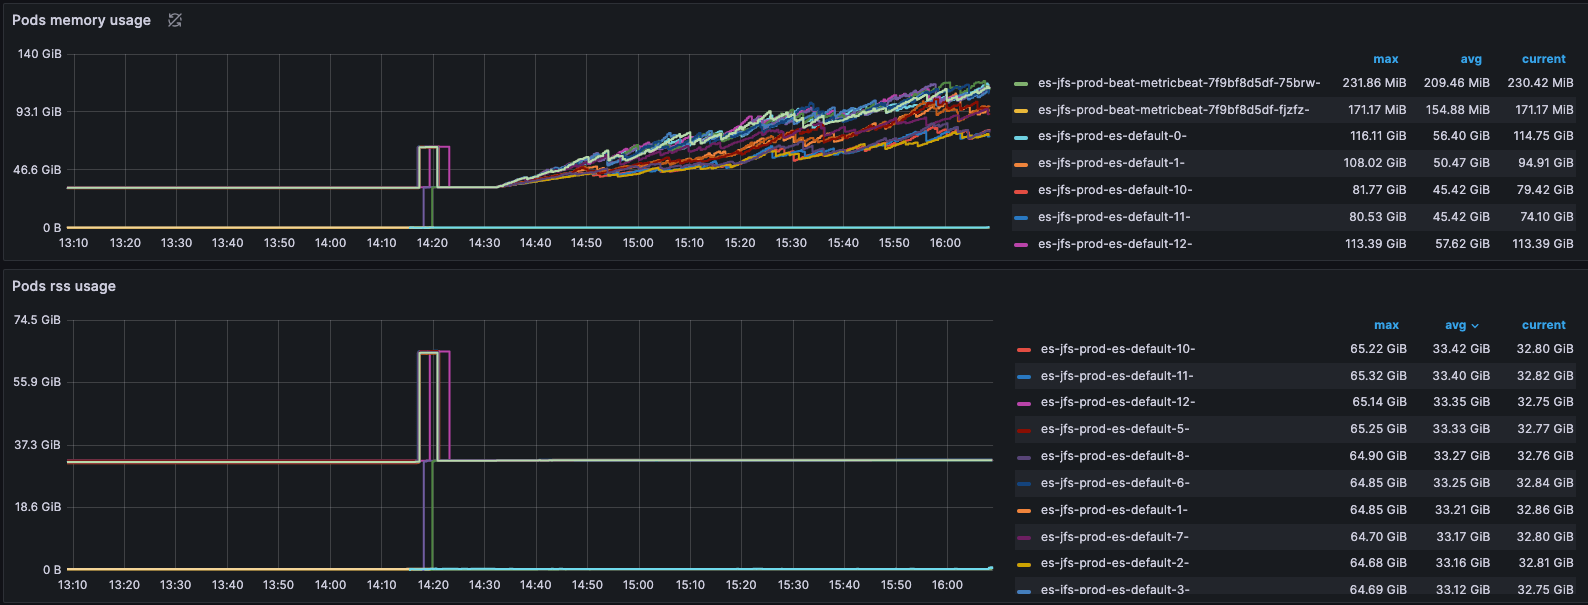
如上图,一直导入数据,Pod 的 Page Cache 使用量持续增长。
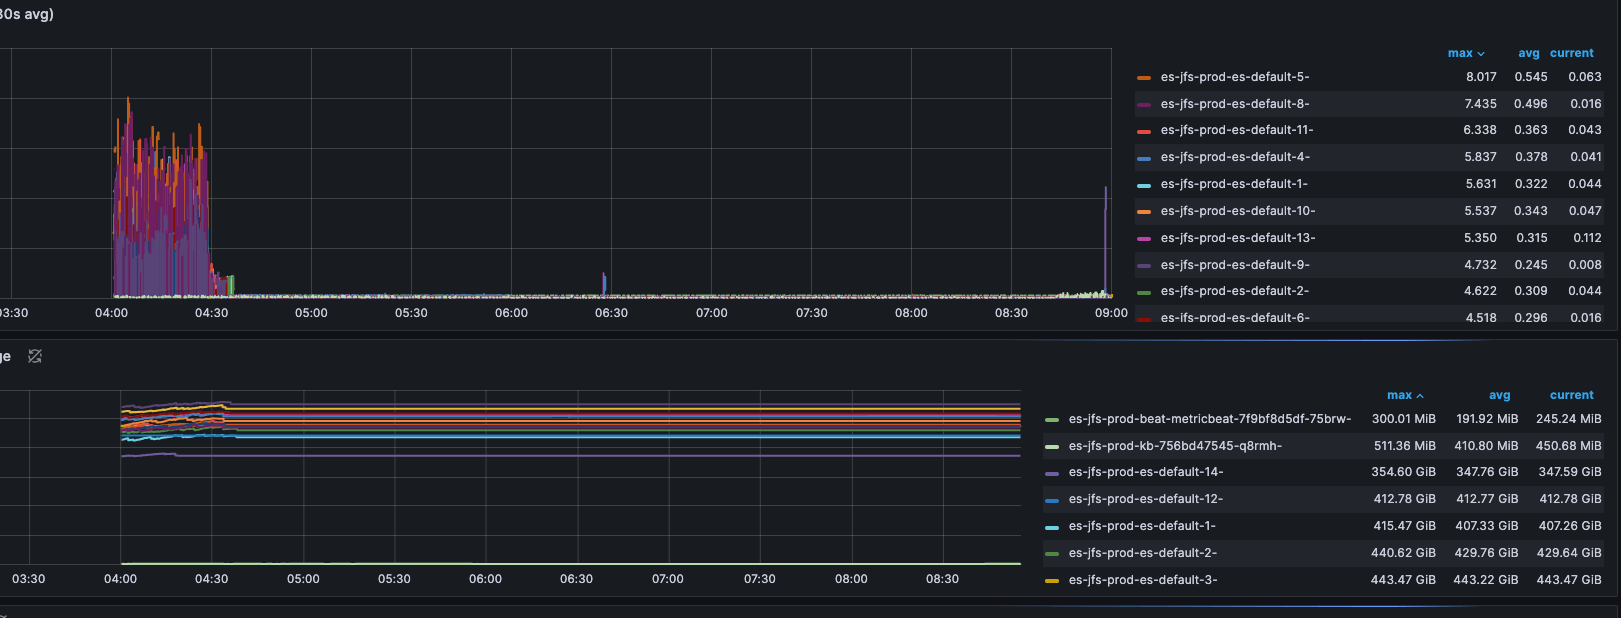
如上图,直到导入数据停止之后,Page Cache 的使用量不再增长,但也并没有立即释放。

4. 解决方案

清理 Cache 是一个解决方案。但无法按照应用的维度来清理 Cache,在主机上清理全部 Cache 会影响其他应用; 同时,从上面的 free 命令输出,可以看到 Cache 太大了,执行 sync && echo 3 > /proc/sys/vm/drop_caches 需要等待很长时间。

另外一个不直接清理 Cache 的原因是,集群上运行的是训练任务,如果训练任务使用了相同的数据集,清理 Cache 会导致缓存失效,增加了训练时间。

只能重启应用了:
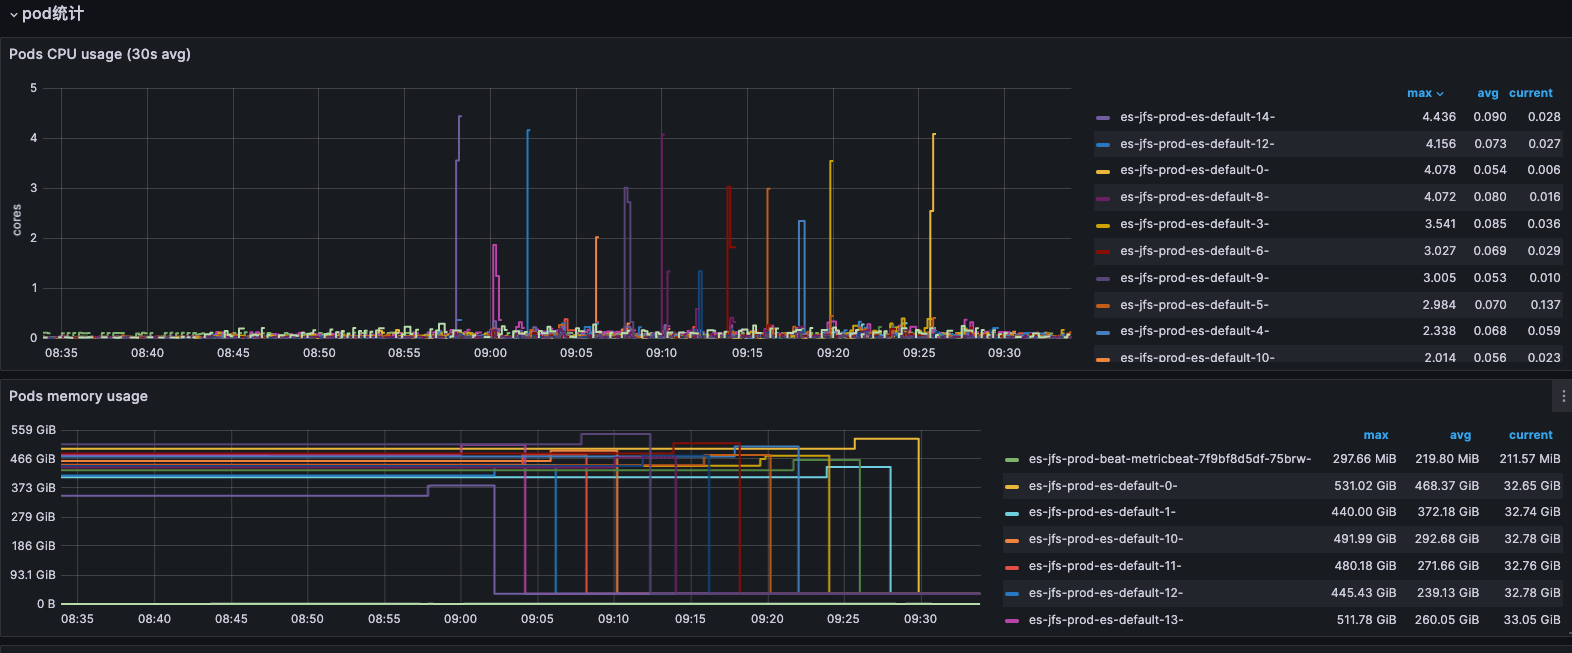
如上图是重启应用之后的内存使用监控,Cache 缓存被释放掉。

这里需要关注的是,怎么样重启应用,有三种方式:

  • Delete Pod
  • Restart StatefulSet
  • ECK Operator Restart

这里推荐修改 ECK 的 Request 配置值来触发重启应用,其他方式容易导致新 Pod 被识别为新的 Elasticsearch Node 触发索引重建。具体什么情况触发、什么情况能够直接复用,我还不能确定。


微信公众号