惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

D
Docker
B
Blog RSS Feed
Microsoft Security Blog
Y
Y Combinator Blog
N
Netflix TechBlog - Medium
M
MIT News - Artificial intelligence
奇客Solidot–传递最新科技情报
奇客Solidot–传递最新科技情报
B
Blog
钛媒体:引领未来商业与生活新知
钛媒体:引领未来商业与生活新知
C
Check Point Blog
The GitHub Blog
The GitHub Blog
让小产品的独立变现更简单 - ezindie.com
P
Proofpoint News Feed
Martin Fowler
Martin Fowler
大猫的无限游戏
大猫的无限游戏
GbyAI
GbyAI
博客园_首页
A
About on SuperTechFans
Blog — PlanetScale
Blog — PlanetScale
人人都是产品经理
人人都是产品经理
T
Tailwind CSS Blog
aimingoo的专栏
aimingoo的专栏
T
The Blog of Author Tim Ferriss
The Cloudflare Blog

陈少文的网站

巨变与机遇的未来十年 Kubernetes 平台管理软件压力测试方案 使用镜像部署 Hexo 静态页面 终于等到你 - GitHub 镜像仓库服务(ghcr.io) 一起来学 Go --(6)Interface 一起来学 Go --(5)Goroutine 和 Channel 什么是函数式编程 如何在 Kubernetes 集群集成 Kata 柯里化与偏函数 使用 PyGithub 自动创建 Label 软件产品是团队能力的输出 Helm 2 、Helm 3 比较 IoT 变现 Kubernetes 中的 DNS 服务 国内的 Helm 镜像源 Harbor 使用自签证书支持 Https 访问 DevOps 工具链之 Prow 如何使用 kfctl 安装 Kubeflow VS Code 无法下载 Go 插件的工具包 工程师更应具有服务精神 你不知道的 Docker 使用技巧 使用 Docker 运行 Tensorflow 论中国 什么是左移 如何清空 Git 仓库全部历史记录 一禅小和尚 有风吹过厨房 时间的玫瑰 如何在 CentOS 安装 GPU 驱动 开发 Tips(19)
Kubernetes Job 创建了近 3W Pod,差点导致严重事故
微信公众号 · 2022-08-17 · via 陈少文的网站

1. 相关背景

早上 10:00 因同事需求,我通过工具在集群上创建 Kubernetes Job 执行任务。

工具创建 Job 时,会拿到集群上的全部节点,然后逐个绑定节点创建 Job。例如,如下集群:

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
kubectl get node

NAME    STATUS                           ROLES                         AGE   VERSION
node2   Ready                            control-plane,master,worker   64d   v1.16.11
node3   Ready                            control-plane,master,worker   64d   v1.16.11
node4   Ready                            control-plane,master,worker   64d   v1.16.11
node5   Ready                            worker                        64d   v1.16.11
node6   Ready                            worker                        64d   v1.16.11
node7   NotReady,SchedulingDisabled      worker                        64d   v1.16.11
node8   NotReady,SchedulingDisabled      worker                        64d   v1.16.11

那么工具会创建 7 个 Job。由于有些集群中,master 节点是不允许调度的,在 Job 中容忍设置了 TaintEffectNoSchedule 容忍不可调度的节点。

这里的 node7、node8 节点实际上已经关机。

2. 事故时间线

按照预期,执行完工具的 Job 创建命令,应该就完事了。但是故事才刚刚开始:

  • 10:31:02 告警系统提示,节点 CPU 5分钟负载过高

通过 top 命令,很快就发现是 kube-controller-manager 占用了太多 CPU。联想到 10:00 的变更,很快我就发现莫名创建了很多 Pod,怀疑是 Pod 太多导致 kube-controller-manager 压力过大。

  • 10:39:00 开始清理 Pod

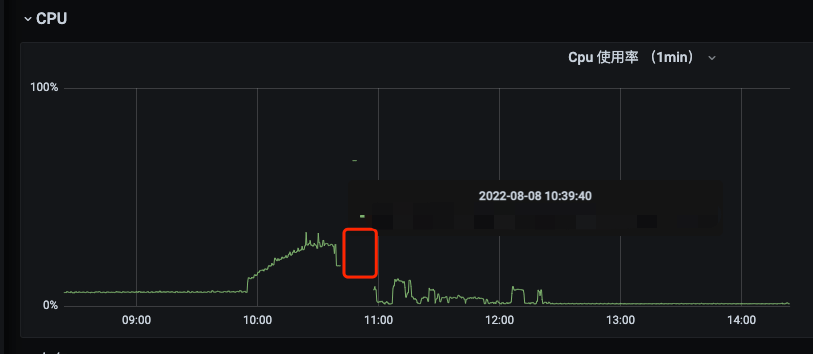
这一步才是噩梦的开始。从监控数据看,在事故前半个小时,机器的 CPU 负载是缓慢上升,当开始清理 Pod 时,机器完全失去了响应。

原因是,使用了 kubectl delete pod 清理 Pod。由于 kubectl 是通过 kube-apiserver 修改 etcd,然后 kube-controller-manager 异步完成删除任务。

但问题的关键在于,有近 3W Pod,而 master 节点只有 2C4G 的配置。瞬间删除 3W Pod 引发 kube-controller-managerEtcd 高负载直接让节点失去了响应。从监控图的 CPU 使用率看就是这样:

CPU 使用率表示的是对 CPU 的利用率,而 CPU 负载表征的是 CPU 的繁忙程度。比如,很多低计算密度的任务,就可能会导致 CPU 使用率低,CPU 负载很高。这里 CPU 使用率的监控数据直接就没了,说明 Prometheus 从主机的 exporter 已经拉取不到数据。

  • 11:05:00 开始陆续扩容 master 节点

集群上有 3 台 master, kube-controller-manager 会进行选主,每台 master 上都部署了 etcd,因此全部 master 节点都需要升配置,直接拉到云厂允许的最高配置。

需要注意的是,不要三台同时升级,等一台就绪之后再升级另外一台,因为集群上还有很多负载。

  • 11:18:00 升配完成,但依然报错

kube-controller-managerEtcd 持续报错,但没有影响工作负载。

  • 12:24:00 直接操作 etcd 清理 Pod 恢复集群

由于忽略了 Pod 的数量级,采用 kubectl 删除 Pod、Namespaces 一直不成功,kube-controller-managerEtcd 持续报错。虽然 master 节点的配置已经升级至很高,但依然不能解决问题。在此,停留排查了很久,没有思路。最后想起来,完全失去响应是在开始删 Pod,才找到思路,直接删除 Etcd 数据。之前写的一篇文档里面有 Etcd 相关的一些操作配置: Etcd、Etcdctl 应用实践

执行一下命令,批量删除 xxx 命名空间下的 Pod 就解决了问题:

1
2
etcdctl del /registry/namespaces/xxx
etcdctl del /registry/pods/xxx --prefix

3. 反省

  • 清理环境

线上的运维操作要谨慎,不仅要保障结果的准确性,还要尽量消除变更之后的影响。

这里疏忽的点是,没有清理 Job。如果清理了 Job,可能就不会有问题。

  • Kubernetes Job 需要设置 backoffLimit

实际上在 Kubernetes 1.16、master 代码分支上,都能看到默认的 backoffLimit 是 6,也就在会 Job 会重试 6 次,最多执行 7 次。工具在创建 Job 时,遗漏了这个参数:

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
apiVersion: batch/v1
kind: Job
metadata:
  name: error-ret
spec:
  template:
    spec:
      containers:
        - name: error-ret
          image: alpine
          command: ["sh"]
          args: ["-c", "exit 1"]
      restartPolicy: Never
      tolerations:
        - key: "node.kubernetes.io/not-ready"
          operator: "Exists"
          effect: "NoSchedule"
      nodeName: node7
  # backoffLimit: 4

但在关机的节点上,默认的 backoffLimit 并未生效,而是以极快的速度不停创建 Pod,一个多小时两个 Job 重试共达到近 3W 次。

  • 有待复现继续跟踪

场景不太好复现,Kubernetes 1.16、多 Master 节点、Worker 节点关机、Job 不设置 backoffLimit、Job 直接设置 nodeName,还在实验中,后续继续跟进。