1,接上一回,共享存储优化海外镜像的拉取
在基于 Harbor 和 Registry 的镜像管理分发方案的基础上,最近又做了一个优化。
之前的方案是,在每个区域,使用一台低配大磁盘的机器,部署一个 Mirror Cache 缓存镜像。这样带来一个问题,就是每个区域都需要拉取一个镜像,如果有 N 个区域,那么发布一个应用,得拉取 N 次,同时发布时专线带宽占用得乘以 N 。
这里被忽略的是,海外云厂的网速一般都非常快。我们可以将海外的区域,根据连通质量进行划片,每个片区部署 Mirror Cache。
另外一个运维问题是部署 Mirror Cache 的主机,怎么进行磁盘扩容和镜像清理。虽然 Registry 可以设置缓存周期,但社区反馈设置并不生效;而磁盘扩容上限是 1T,之后就需要迁移到数据盘。因此这里采用了另一种方案,多个 Mirror Cache 之间共享后端存储。如下图所示:
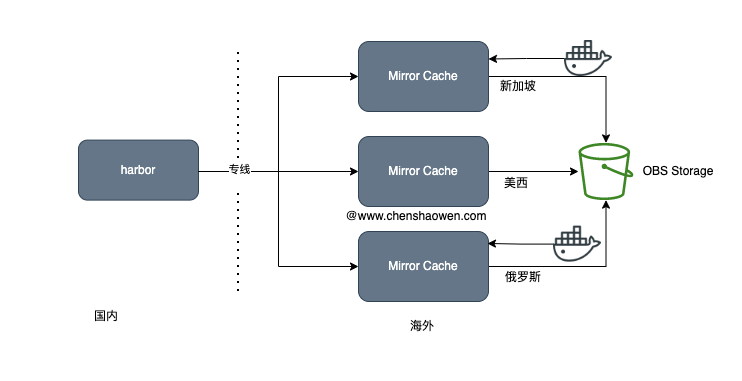
使用同一个 OBS 后端存储的优势在于:
- 发布多区应用,只需要拉取一次,而不用每个区拉取一次
- 使用 OBS、S3 等对象存储的扩展性、稳定性比本地磁盘好
- 即使没有 CDN 加速,大厂的对象存储服务在全球的速度都不差
- 对象存储能设置生命周期管理,可以用于自动清理镜像数据
由于镜像的全部数据都缓存在 OBS 对象存储,因此 Mirrir Cache 实际上是一个无状态的服务。更进一步,我们可以将其合并为一个,放置在连通各区质量好的区域。
下面进入本文主题,一次大镜像拉取失败的经历。
2,拉取大镜像时失败
镜像的大小在 10G 左右。拉取链路如下:
Docker Client -> Docker Daemon -> Mirror Cache -> LB -> Harbor
各个组件,具体报错如下:
- 拉取镜像时 Docker Client 不停重试大的单层镜像
1
| 2a57ddc33014: Downloading [=======================> ] 646.6MB/1.378GB
|
在进度条达到接近 70%-80% 时,这一层镜像重新开始拉取:
1
| 2a57ddc33014: Retrying in 2 seconds
|
1
2
3
| Sep 08 01:12:08 x.x.x.x dockerd[8434]: time="2022-09-08T01:12:08.681917626Z" level=info msg="Download failed, retrying (2/5): expected HTTP 206 from byte range request"
Sep 08 01:19:17 x.x.x.x dockerd[8434]: time="2022-09-08T01:19:17.196665587Z" level=info msg="Download failed, retrying (3/5): unexpected EOF"
Sep 08 01:19:20 x.x.x.x dockerd[8434]: time="2022-09-08T01:19:20.197654060Z" level=error msg="Not continuing with pull after error: context canceled"
|
- 镜像缓存服务 Mirror Cache 的错误日志
1
2
3
| linux arch/amd64 UpstreamClient(Docker-Client/20.10.13 \\(linux\\))"
time="2022-09-08T02:30:50.580118978Z" level=error msg="Error committing to storage: stream error: stream ID 17; INTERNAL_ERROR; received from peer" auth.user.name=x go.version=go1.16.15 http.request.host=harbor.chenshaowen.com http.request.id=d51a853a-447a-44bf-9e0e-f015fb4c9bd8 http.request.method=GET http.request.remoteaddr=x.x.x.x http.request.uri="/v2/x/x/blobs/sha256:2c618d17e28be23c5c38b084bfb3f288371bbed89181e57f7cf43f535261e354" http.request.useragent="docker/18.09.7 go/go1.10.8 git-commit/2d0083d kernel/3.10.0-1160.53.1.el7.x86_64 os/linux arch/amd64 UpstreamClient(Docker-Client/20.10.13 \(linux\))" vars.digest="sha256:2c618d17e28be23c5c38b084bfb3f288371bbed89181e57f7cf43f535261e354" vars.name="x/x"
time="2022-09-08T02:30:50.580404499Z" level=error msg="response completed with error" auth.user.name=x err.code=unknown err.detail="stream error: stream ID 15; INTERNAL_ERROR; received from peer" err.message="unknown error" go.version=go1.16.15 http.request.host=x http.request.id=d51a853a-447a-44bf-9e0e-f015fb4c9bd8 http.request.method=GET http.request.remoteaddr=x.x.x.x http.request.uri="/v2/x/x/blobs/sha256:2c618d17e28be23c5c38b084bfb3f288371bbed89181e57f7cf43f535261e354" http.request.useragent="docker/18.09.7 go/go1.10.8 git-commit/2d0083d kernel/3.10.0-1160.53.1.el7.x86_64 os/linux arch/amd64 UpstreamClient(Docker-Client/20.10.13 \(linux\))" http.response.contenttype="application/json; charset=utf-8" http.response.duration=3m30.111855949s http.response.status=500 http.response.written=1091061683 vars.digest="sha256:2c618d17e28be23c5c38b084bfb3f288371bbed89181e57f7cf43f535261e354" vars.name="x/x"
|
1
| (104: Connection reset by peer) while reading upstream
|
大镜像无法拉取的特征:
- 较小的镜像层可以拉取成功,只有少量大的单层镜像失败
- 大镜像层拉取不断重试
- 其他小镜像可以拉取成功
结合上面的日志,我的判断是受某个组件设置的超时影响,导致拉取一段时间就会断开连接。而 LB 的报错日志在网上有大量的文章描述,解决 (104: Connection reset by peer) 的方式,就是增加 buffer 或者 timeout 时间。
这里的 timeout 时间正好和此判断相吻合。而 LB 设置的 proxy_connect_timeout、proxy_send_timeout、proxy_read_timeout 都是 60s,但苦于 LB 服务因为各种原因无法修改这些参数,只能另寻他法。如果你遇到类似的情况,可以试试修改 LB 的这些参数值试试。
最终,我直接跳过了 LB,将 Mirror Cache 直接连上了 Habror。拉取链路如下:
Docker Client -> Docker Daemon -> Mirror Cache -> Harbor
这样不用 LB 转发,不仅节省了相关费用,简化了架构,还减轻了运维成本。更关键的是,大镜像也可以拉取,再也没有不停重试的情况出现。
3. 参考



