为什么 NFS Over RDMA 比 NFS 的 FIO 大块读性能好很多
微信公众号
·
2025-03-30
·
via 陈少文的网站
Please enable Javascript to view the contents
1. 背景
在测试 NFS Over RDMA 的性能时,发现 4M 的文件的读取性能竟然能达到 45GB/s。
1
2
3
| fio -numjobs=128 -fallocate=none -iodepth=2 -ioengine=libaio -direct=1 -rw=read -bs=4M --group_reporting -size=100m -time_based -runtime=30 -name=fio-test -directory=/data1/nfs
READ: bw=42.3GiB/s (45.4GB/s), 42.3GiB/s-42.3GiB/s (45.4GB/s-45.4GB/s), io=1269GiB (1363GB), run=30019-30019msec
|
而磁盘的 4M 多线程读取性能只有 6 GB/s
1
2
3
| fio -numjobs=128 -fallocate=none -iodepth=2 -ioengine=libaio -direct=1 -rw=read -bs=4M --group_reporting -size=100m -time_based -runtime=30 -name=fio-test -directory=/data1/host
READ: bw=6190MiB/s (6491MB/s), 6190MiB/s-6190MiB/s (6491MB/s-6491MB/s), io=182GiB (196GB), run=30152-30152msec
|
2. NFS Over RDMA VS NFS
3. 数据拷贝路径比较
3.1 NFS
传输路径:
磁盘 -> 内核页缓存 -> 用户态内存 (read) -> 内核态网络缓冲区 (send) -> 协议栈处理 -> 网卡 -> 网络 -> 网卡 -> 协议栈处理 -> 内核态网络缓冲区 (receive) -> 用户态内存 (write) -> 磁盘
3.2 NFS Over RDMA
传输路径:
磁盘 -> 内核页缓存 -> RDMA 网卡 -> 网络 -> RDMA 网卡 -> 内核页缓存(绕过内核网络协议栈)-> 用户态内存 (write) -> 磁盘
3.3 比较
| 对比项 | NFS (基于 TCP/IP) | NFS Over RDMA |
|---|
| 数据拷贝 | 需要多次拷贝(用户态 ↔ 内核态,网络缓冲区等) | 采用 RDMA 直接访问内存,减少拷贝 |
| CPU 占用 | 高,CPU 需处理协议栈和数据拷贝 | 低,RDMA 硬件卸载传输,减少 CPU 负担 |
| 延迟 | 较高,TCP/IP 处理增加开销 | 低,绕过协议栈,直接 DMA 访问 |
| 吞吐量 | 受限于 TCP/IP 和 CPU 处理能力 | 高,RDMA 提供更高的带宽 |
| 网络协议 | 依赖 TCP/UDP 传输协议 | 使用 RDMA 直接访问远程内存 |
| 适用场景 | 适用于一般网络环境,对低成本存储共享适用 | 适用于高性能计算(HPC)、大规模分布式存储 |
| 部署复杂度 | 易于部署,适用于标准以太网 | 需支持 RDMA(RoCE 或 InfiniBand),部署较复杂 |
| 硬件依赖 | 只需要标准网卡 | 需要 RDMA 兼容网卡(如 RoCE、InfiniBand) |
4. 传输路径逐步分析
FIO 测试的传输路径:
内核页缓存 -> RDMA 网卡 -> 网络 -> RDMA 网卡 -> 内核页缓存(绕过内核网络协议栈)-> FIO 用户态内存
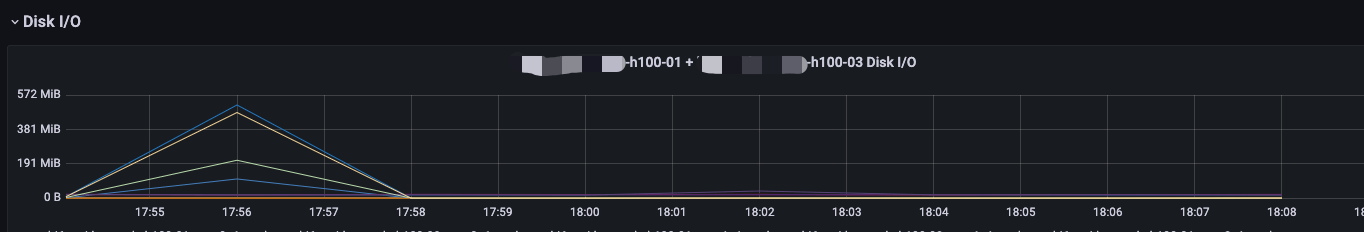
从监控中,可以看到,在测试期间只有前一次测试的磁盘操作,后面就都没有经过磁盘。fio 的 direct=1 参数只能控制客户端是否使用缓存,不能控制 NFS 服务端。
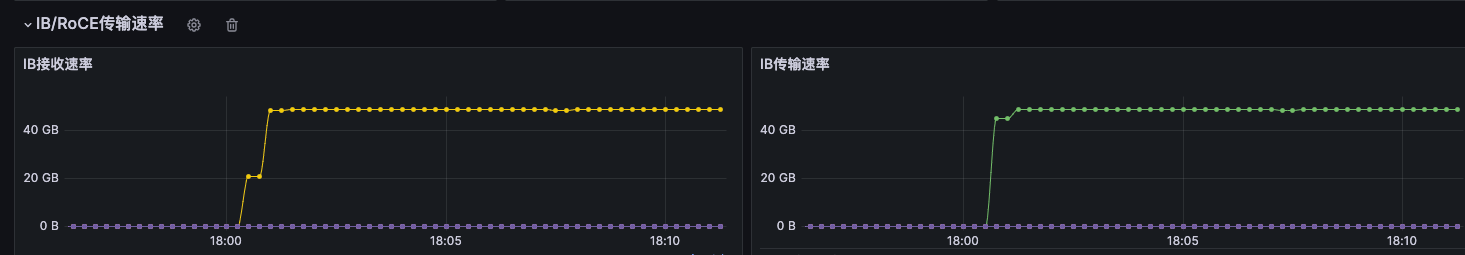
但 RDMA 的速度跑满了,能达到 45 GB/s。
测试一下内存的读写速度:
1
2
3
| fio -numjobs=128 -iodepth=2 -ioengine=sync -rw=read -bs=4M --group_reporting -size=100m -time_based -runtime=30 -name=fio-test -directory=/dev/shm
READ: bw=135GiB/s (145GB/s), 135GiB/s-135GiB/s (145GB/s-145GB/s), io=4057GiB (4356GB), run=30004-30004msec
|
1
2
3
| fio -numjobs=128 -iodepth=2 -ioengine=sync -rw=write -bs=4M --group_reporting -size=100m -time_based -runtime=30 -name=fio-test -directory=/dev/shm
WRITE: bw=74.4GiB/s (79.9GB/s), 74.4GiB/s-74.4GiB/s (79.9GB/s-79.9GB/s), io=2233GiB (2398GB), run=30008-30008msec
|
内存的读写速度分别达到 145 GB/s 和 79.9 GB/s,远高于单个 RDMA 网卡的 45 GB/s。
这样看,fio 测试大文件读取时的瓶颈,确实就是 RDMA 网络传输速度。

此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。






