






1. 本地容器运行
- 启动 LLM
| |
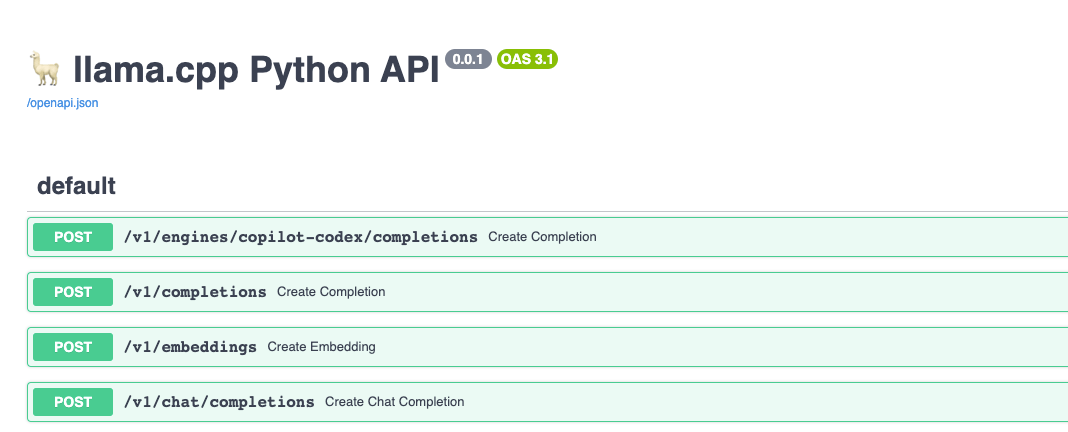
在 http://localhost:8000/docs 页面即可看到接口文档,如下图:
- 部署一个简单的 Chat UI
这里需要注意的是 OPENAI_API_HOST 参数,需要设置为你的宿主机 IP 地址,而不是 localhost 127.0.0.1,否则无法访问。
| |
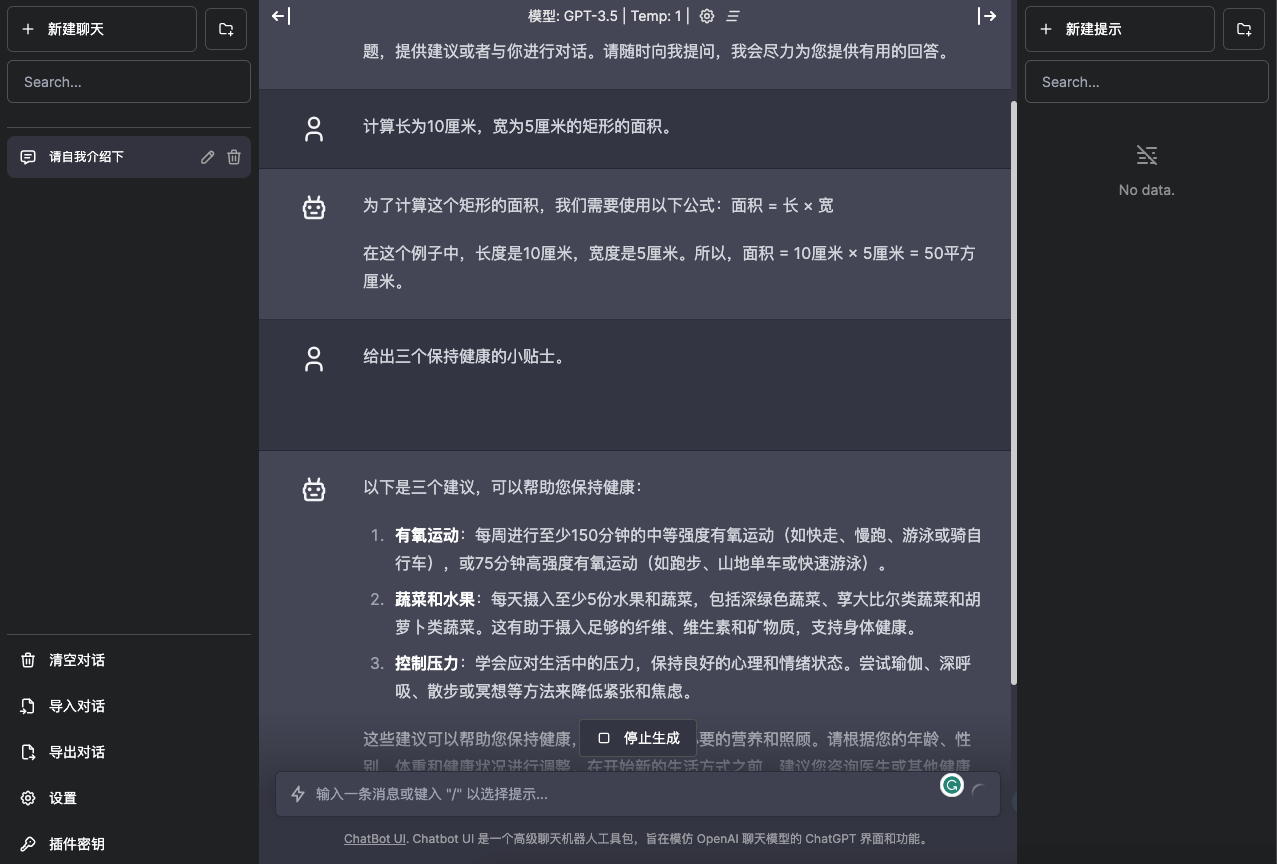
页面效果如下:
2. K8s 快速部署
- 部署 LLM 应用
kubectl create deploy vicuna --image=shaowenchen/vicuna-33b-v1.3-gguf:full
kubectl expose deploy vicuna  --port 8000 --target-port=8000 --type=NodePort
这里也可以不暴露端口,只创建一个 service,然后在其他容器中使用 vicuna 作为域名访问。
- 部署 Chat UI
| |
- 获取访问地址
| |
3. 测试与使用
提问:
请自我介绍下
回复:
你好,我是ChatGPT,一个基于OpenAI推理生成模型的大规模语言模型。借助 billions of words of internet text,我学习了很多关于语言、文化和知识的信息。我可以回答问题,提供建议或者与你进行对话。请随时向我提问,我会尽力为您提供有用的回答。
提问:
计算长为10厘米,宽为5厘米的矩形的面积。
回复:
为了计算这个矩形的面积,我们需要使用以下公式:面积 = 长 × 宽

在这个例子中,长度是10厘米,宽度是5厘米。所以,面积 = 10厘米 × 5厘米 = 50平方厘米。
提问:
给出三个保持健康的小贴士。
回复:
以下是三个建议,可以帮助您保持健康:

有氧运动:每周进行至少150分钟的中等强度有氧运动(如快走、慢跑、游泳或骑自行车),或75分钟高强度有氧运动(如跑步、山地单车或快速游泳)。
蔬菜和水果:每天摄入至少5份水果和蔬菜,包括深绿色蔬菜、莩大比尔类蔬菜和胡萝卜类蔬菜。这有助于摄入足够的纤维、维生素和矿物质,支持身体健康。
控制压力:学会应对生活中的压力,保持良好的心理和情绪状态。尝试瑜伽、深呼吸、散步或冥想等方法来降低紧张和焦虑。
这些建议可以帮助您保持健康,并为身体提供必要的营养和照顾。请根据您的年龄、性别、体重和健康状况进行调整。在开始新的生活方式之前,建议您咨询医生或其他健康专业人士。
看起来回答得还行,无论是 33b 的模型,还是 7b 的模型,都能给出合理的回答。当然,我只是使用了 HuggingFace 的 alpaca-data-gpt4-chinese 数据集进行了少量人工测试。
4. 性能问题
性能其实是我真正关心的一个问题,因为只有推理需要的资源与现有的资源相匹配,才能够在生产环境中快速部署与使用,否则将会面临高昂的采购成本。
4.1 CPU、IO 拉满,Mem 使用率低
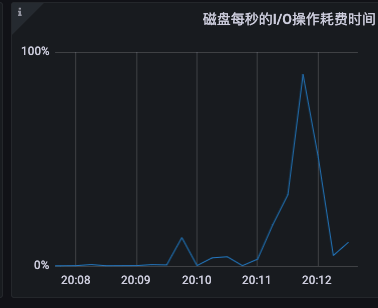
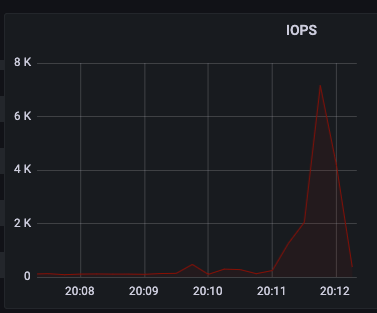
直接看监控
- IO 拉满
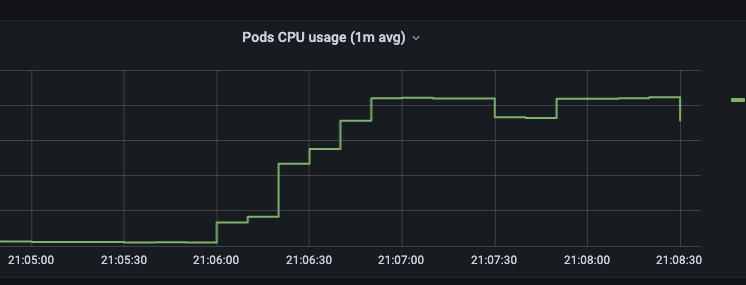
- CPU 拉满
值得注意的是物理机器的 CPU 是 40 核的,但最多只能使用 20 核。在 Issues 中看到过调优的一个建议是,CPU 设置为机器的核心数的一半。目前观测到的情况,可能与这个建议有关。
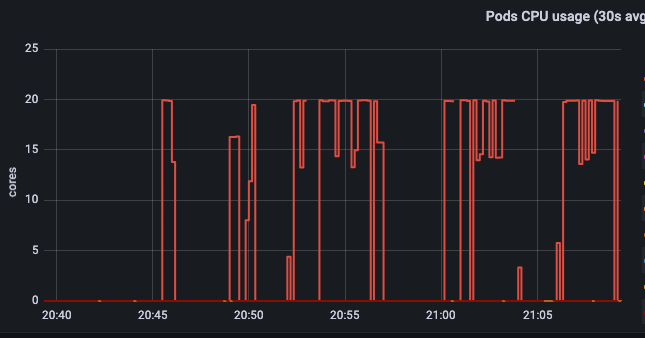
在 40 核的机器上,推理使用的 CPU 维持在 20 核,无法继续提升。
- Mem 使用率低
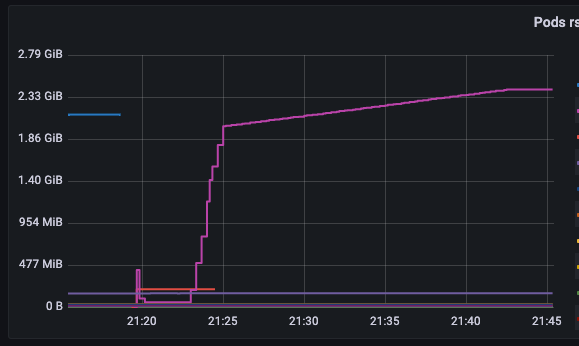
内存使用率让人很意外,CPU、IO、Mem 使用也太不均衡了,竟然只用了不到 3GB。
4.1 将内存挂载到文件系统
由于 IO 拉满,我猜测磁盘有瓶颈,约束了推理效率。于是将容器中的模型文件挂载到内存中,再次进行测试。
| |
很可惜的是,推理效率并没有显著提升。那么,磁盘 IO 到底是在干什么呢?推理过程难道只要不到 3GB 的内存吗?如何加速推理过程,是我下一步需要关注的问题。
5. 一些已经打包好的模型镜像
- chinese-alpaca-2-7b-16k
| Name | Quant method | Size |
|---|---|---|
| shaowenchen/chinese-alpaca-2-7b-16k-gguf:Q2_K | Q2_K | 3.68 GB |
| shaowenchen/chinese-alpaca-2-7b-16k-gguf:Q3_K | Q3_K | 4.16 GB |
| shaowenchen/chinese-alpaca-2-7b-16k-gguf:Q3_K_L | Q3_K_L | 4.46 GB |
| shaowenchen/chinese-alpaca-2-7b-16k-gguf:Q3_K_S | Q3_K_S | 3.81 GB |
| shaowenchen/chinese-alpaca-2-7b-16k-gguf:Q4_0 | Q4_0 | 4.7 GB |
| shaowenchen/chinese-alpaca-2-7b-16k-gguf:Q4_K | Q4_K | 4.95 GB |
| shaowenchen/chinese-alpaca-2-7b-16k-gguf:Q4_K_S | Q4_K_S | 4.73 GB |
- vicuna-33b-v1.3
| Name | Quant method | Compressed Size |
|---|---|---|
| shaowenchen/vicuna-33b-v1.3-gguf:Q2_K | Q2_K | 12.78 GB |
| shaowenchen/vicuna-33b-v1.3-gguf:Q3_K | Q3_K | 14.81 GB |
| shaowenchen/vicuna-33b-v1.3-gguf:Q4_K | Q4_K | 18.24 GB |
| shaowenchen/vicuna-33b-v1.3-gguf:Q5_K | Q5_K | 21.72 GB |
| shaowenchen/vicuna-33b-v1.3-gguf:Q6_K | Q6_K | 25.05 GB |
| shaowenchen/vicuna-33b-v1.3-gguf:Q8_0 | Q8_0 | 31.34 GB |
| shaowenchen/vicuna-33b-v1.3-gguf:full | full | 56.07 GB |
- baichuan2-7b-chat
| Name | Quant method | Size |
|---|---|---|
| shaowenchen/baichuan2-7b-chat-gguf:Q2_K | Q2_K | 7.59 GB |
| shaowenchen/baichuan2-7b-chat-gguf:Q3_K | Q3_K | 8.61 GB |
| shaowenchen/baichuan2-7b-chat-gguf:Q3_K_L | Q3_K_L | 9.23 GB |
| shaowenchen/baichuan2-7b-chat-gguf:Q3_K_S | Q3_K_S | 7.93 GB |
| shaowenchen/baichuan2-7b-chat-gguf:Q4_0 | Q4_0 | 9.6 GB |
- llama-2-13b-langchain-chat
| Name | Quant method | Size |
|---|---|---|
| shaowenchen/llama-2-13b-langchain-chat-gguf:Q4_K | Q4_K | 16.7 GB |
| shaowenchen/llama-2-13b-langchain-chat-gguf:Q5_K | Q5_K | 19.5 GB |
在这些模型中,除了 vicuna-33b,其他模型在 20 核 CPU 上都可以流畅推理,即使是 4 位量化也有不错的效果。如果需要量化精度更高的模型,可以去 HuggingFace 下载。
6. 总结
模型能力会逐步成为维持 IT 系统运作的基础能力。这件事正在发生,也在快速发生,重新构建上层应用迫在眉睫。本篇主要是研究如何在无 GPU 机器上推理大模型的部分笔记,主要内容如下:
- 本地容器运行 LLM
- K8s 快速部署 LLM
- 测试与使用,Q4 量化就有不错的效果
- 在推理过程中,IO 拉满,CPU 拉满,Mem 使用率低。Mem 的使用率低和请求并发数量有关。