








除了购买各种订阅和api服务,还有一种选择就是本地运行模型,但是这个一般来讲还是只能运行一些参数量比较小的,
随着开源权重模型的发展,这个方向也在慢慢的改变,当然差距肯定是有的,只是本地我们可以用来做些辅助工作
之前很多情况下一般都只是能作为玩具,并且由于ollama和lm studio还是有一些性能损耗
之前有了解到llama.cpp这个开源项目,貌似很多lm studio等都是基于它构建的,那么直接用它是不是可以更充分的压榨我的渣渣显卡性能
首先可以在llama.cpp的github地址下载已经构建好的包
比如我是windows下,然后是在笔记本上的3060(6g)显卡,
cuda版本可以通过nvidia-smi查看,我的是12版本的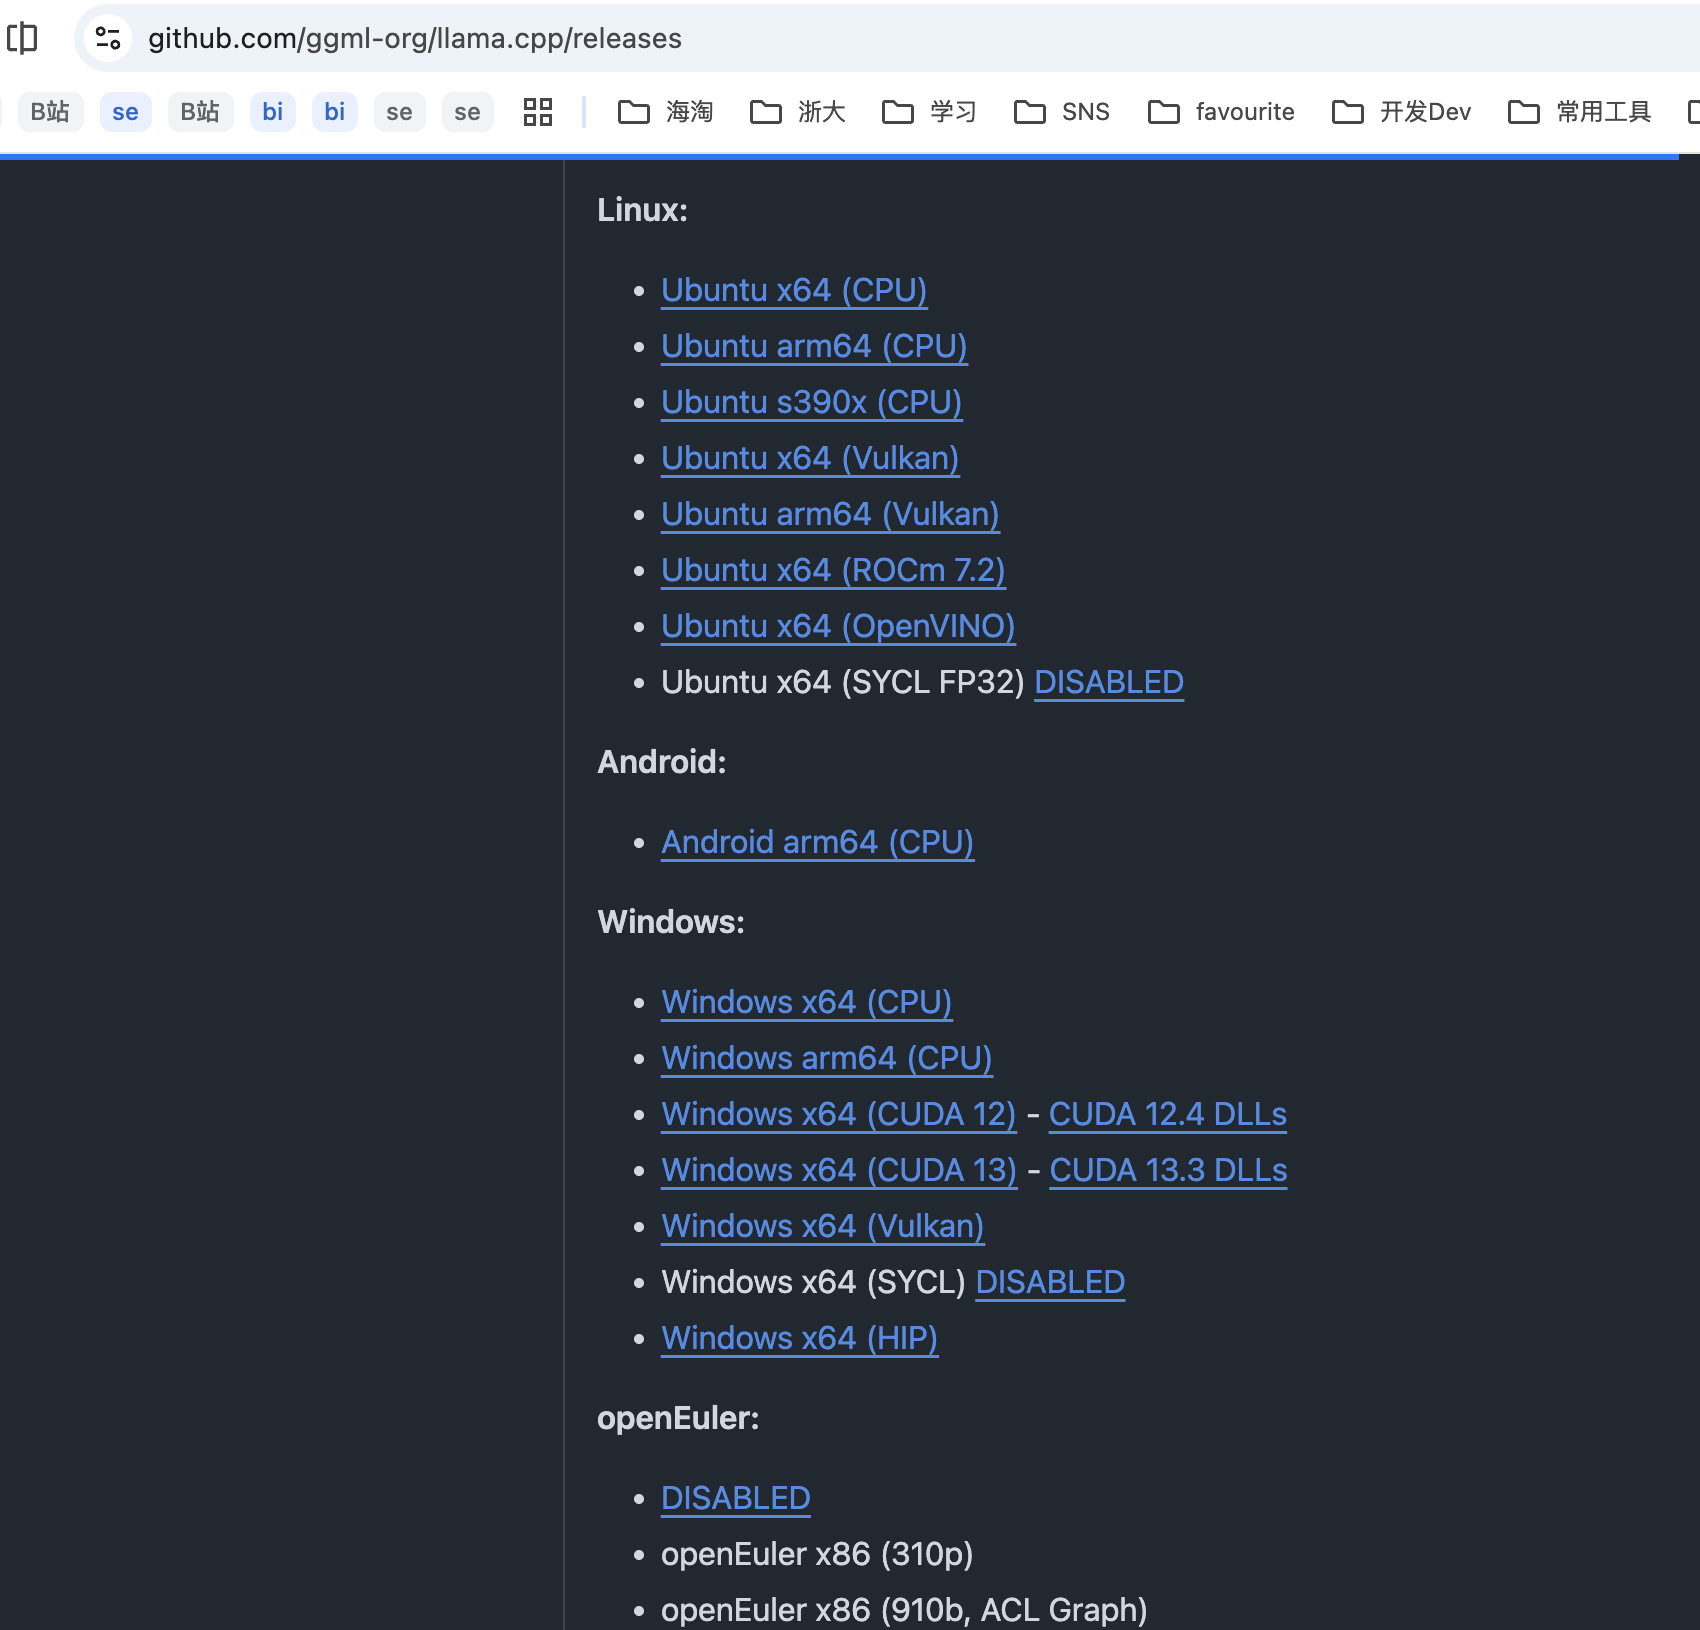
注意这里要下载两个包,一个是llama的主包,还有是后面跟着的[CUDA 12.4 DLLs]也是得下载的,不然会当成cpu模式在运行
后面的包解压后也放在前面主包解压的目录里,
这里主要是看下怎么设置参数,因为像之前说的,我有在本地运行hermes agent,它最低需要64k的上下文,那么我就是想试试哪个模型可以
看了下模型体积,只能上9B参数量左右的模型,否则都是直接爆显存
所以就试下qwen3.6 的 9B模型,可以在hugging face下载模型
1 | .\llama-cli.exe -m F:\models\Qwen3.5-9B-Q4_K_M.gguf --ctx-size 65536 --flash-attn on --cache-type-k q4_0 --cache-type-v q4_0 --n-gpu-layers 28 --parallel 1 |
用的是 Q4_K_M 量化的,还是相对折中的,--ctx-size 65536 代表上下文是64k,符合爱马仕的要求--flash-attn on 是开启 Flash Attention,也是为了降低 attention 计算的显存占用--cache-type-k q4_0 --cache-type-v q4_0 是设置了kv cache的量化大小,也是进行适当降低,防止显卡扛不住--n-gpu-layers 26 是加载到显存26层,因为本身64k的上下文已经很占显存,所以只能加载26层,否则就会报显存oom这种--parallel 1 表示并行度是1,因为我就单个会话使用llama-cli.exe 和 llama-server.exe 的差别是你就在运行的窗口对话还是需要提供对话服务给Open WebUI、Cherry Studio 这些使用
当然也可以是爱马仕
直接cli运行的话,我测了下,能有6.6token/s, 勉强还可以使用的感觉,这样是占了5.2g的显存,并且如果模型用来做一些简单任务的话,还是比较可用的
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。