








这是简易数据分析系列的第 8 篇文章。
原文首发于博客园:简易数据分析 08。
我们在Web Scraper 翻页——控制链接批量抓取数据一文中,介绍了控制网页链接批量抓取数据的办法。
但是你在预览一些网站时,会发现随着网页的下拉,你需要点击类似于「加载更多」的按钮去获取数据,而网页链接一直没有变化。
所以控制链接批量抓去数据的方案失效了,所以我们需要模拟点击「加载更多」按钮,去抓取更多的数据。
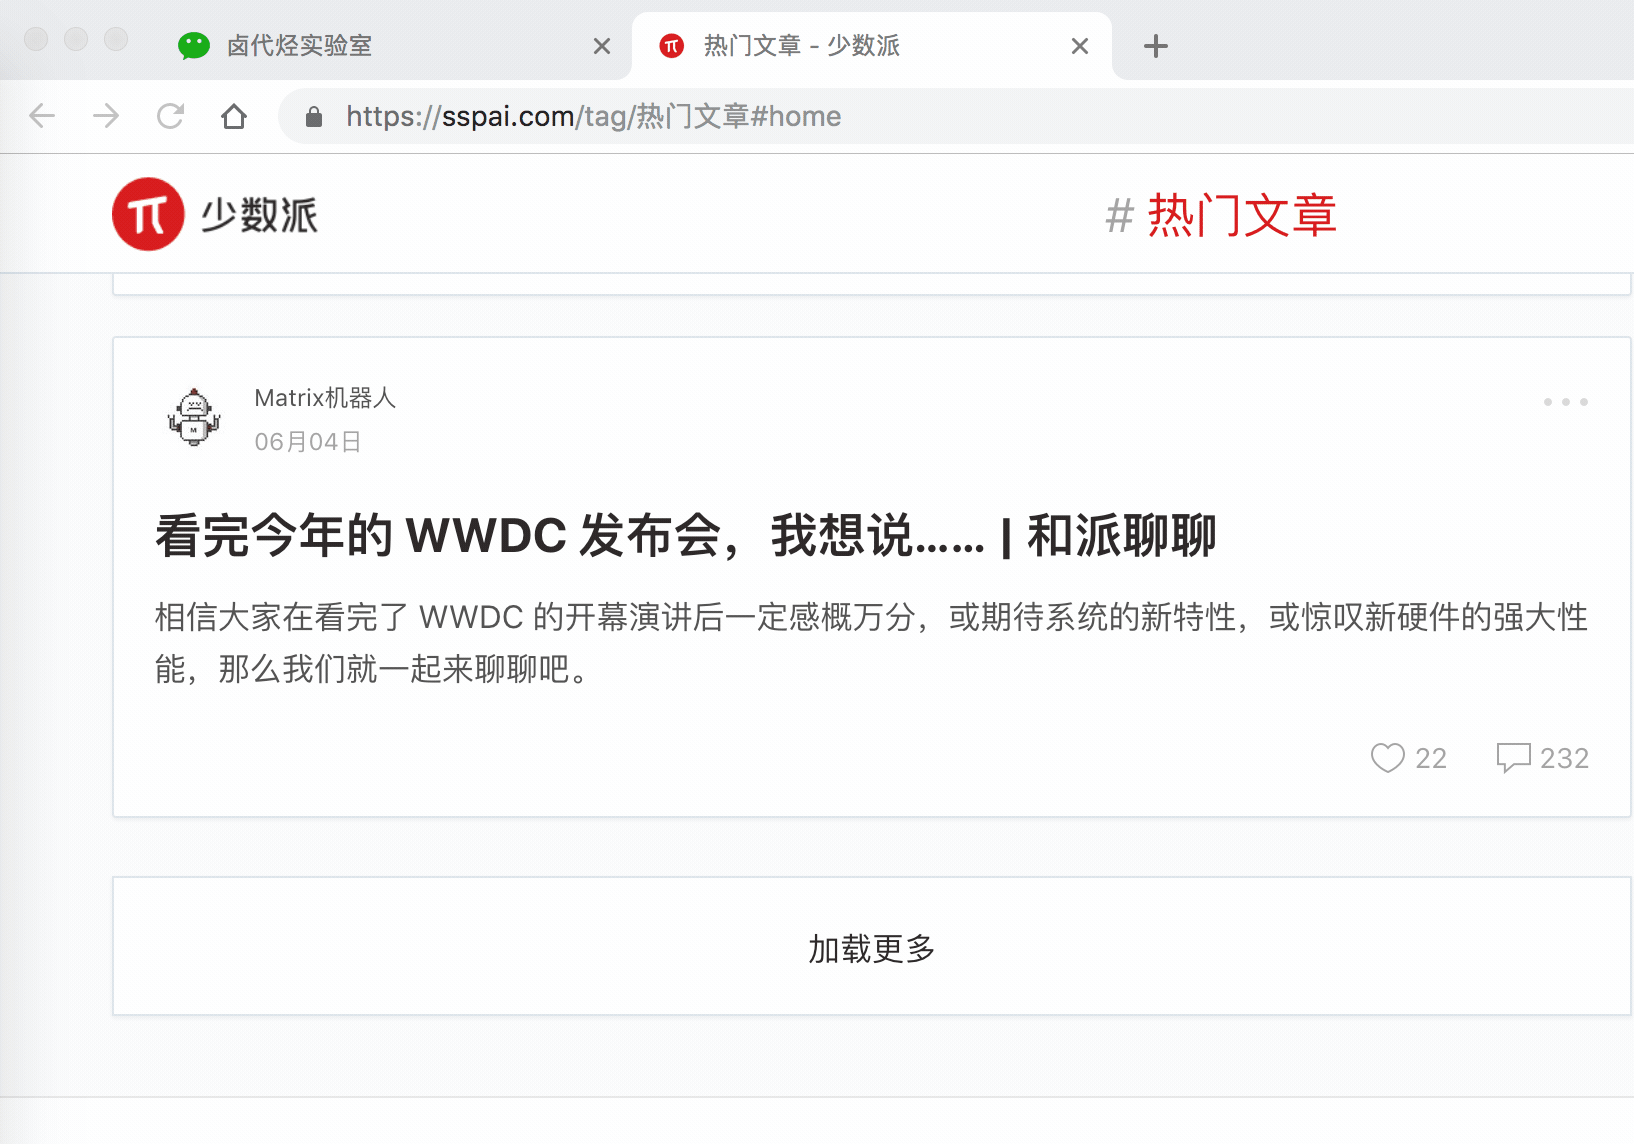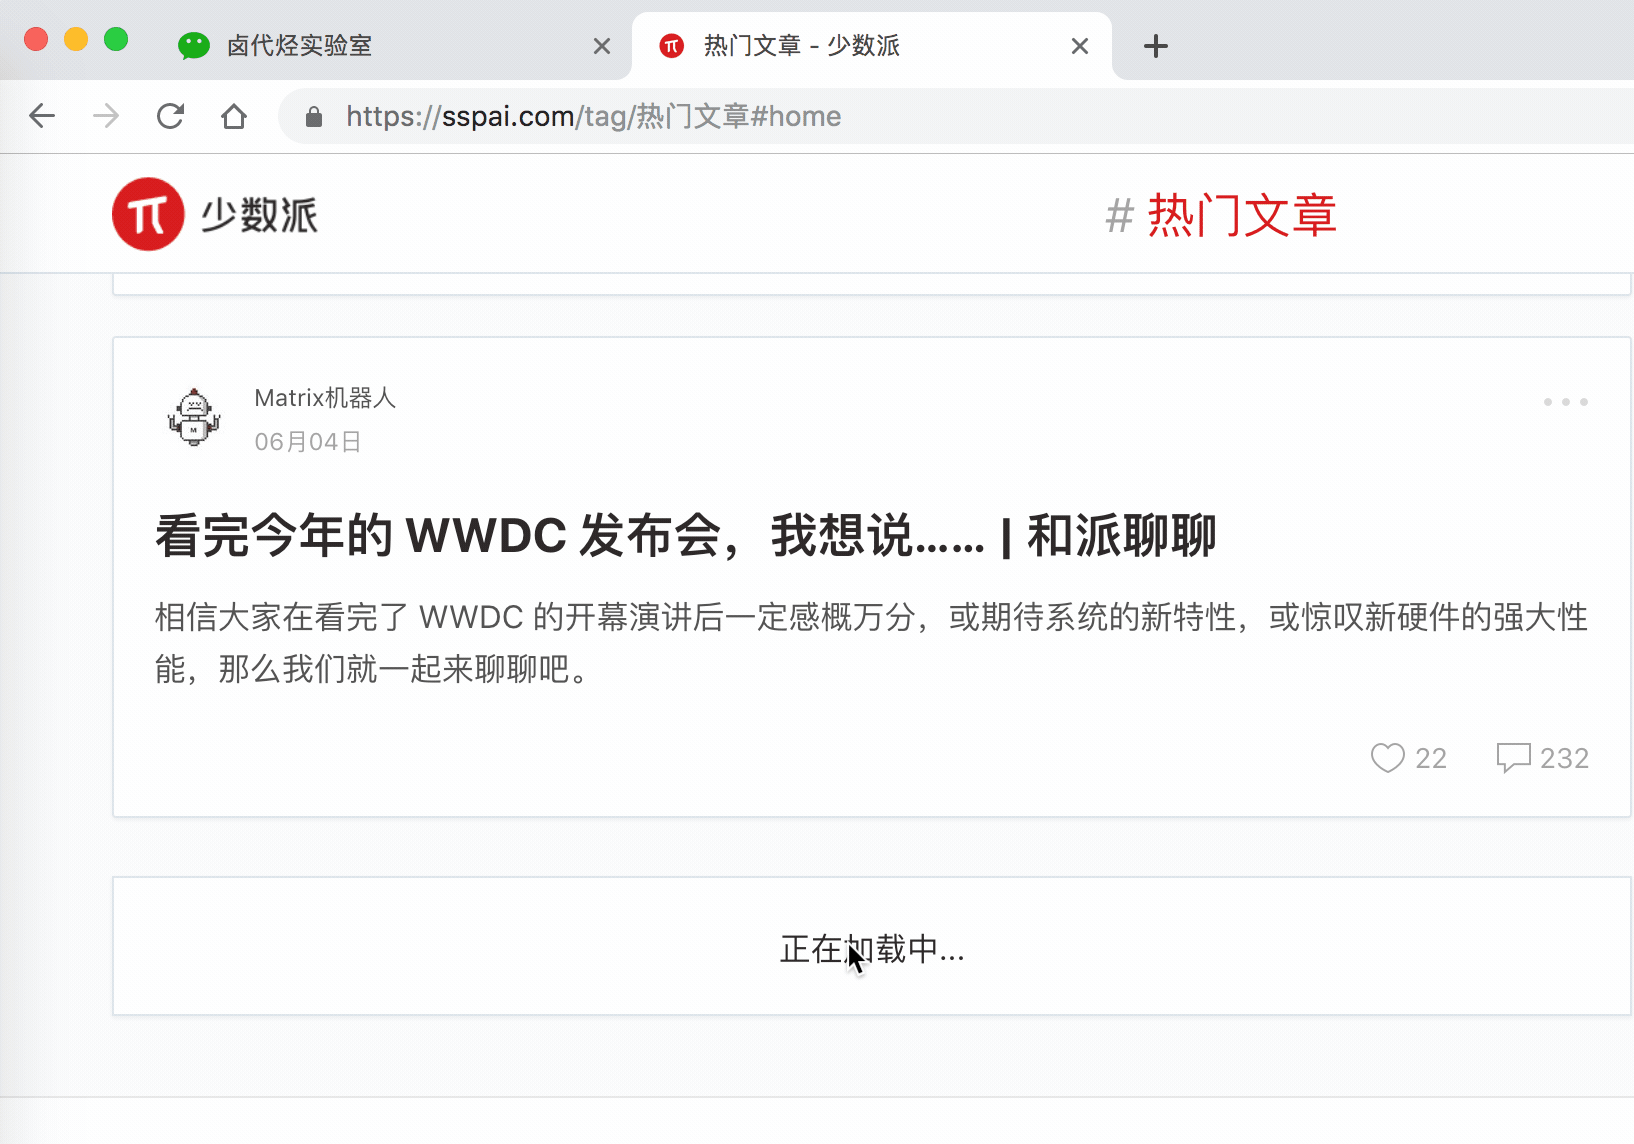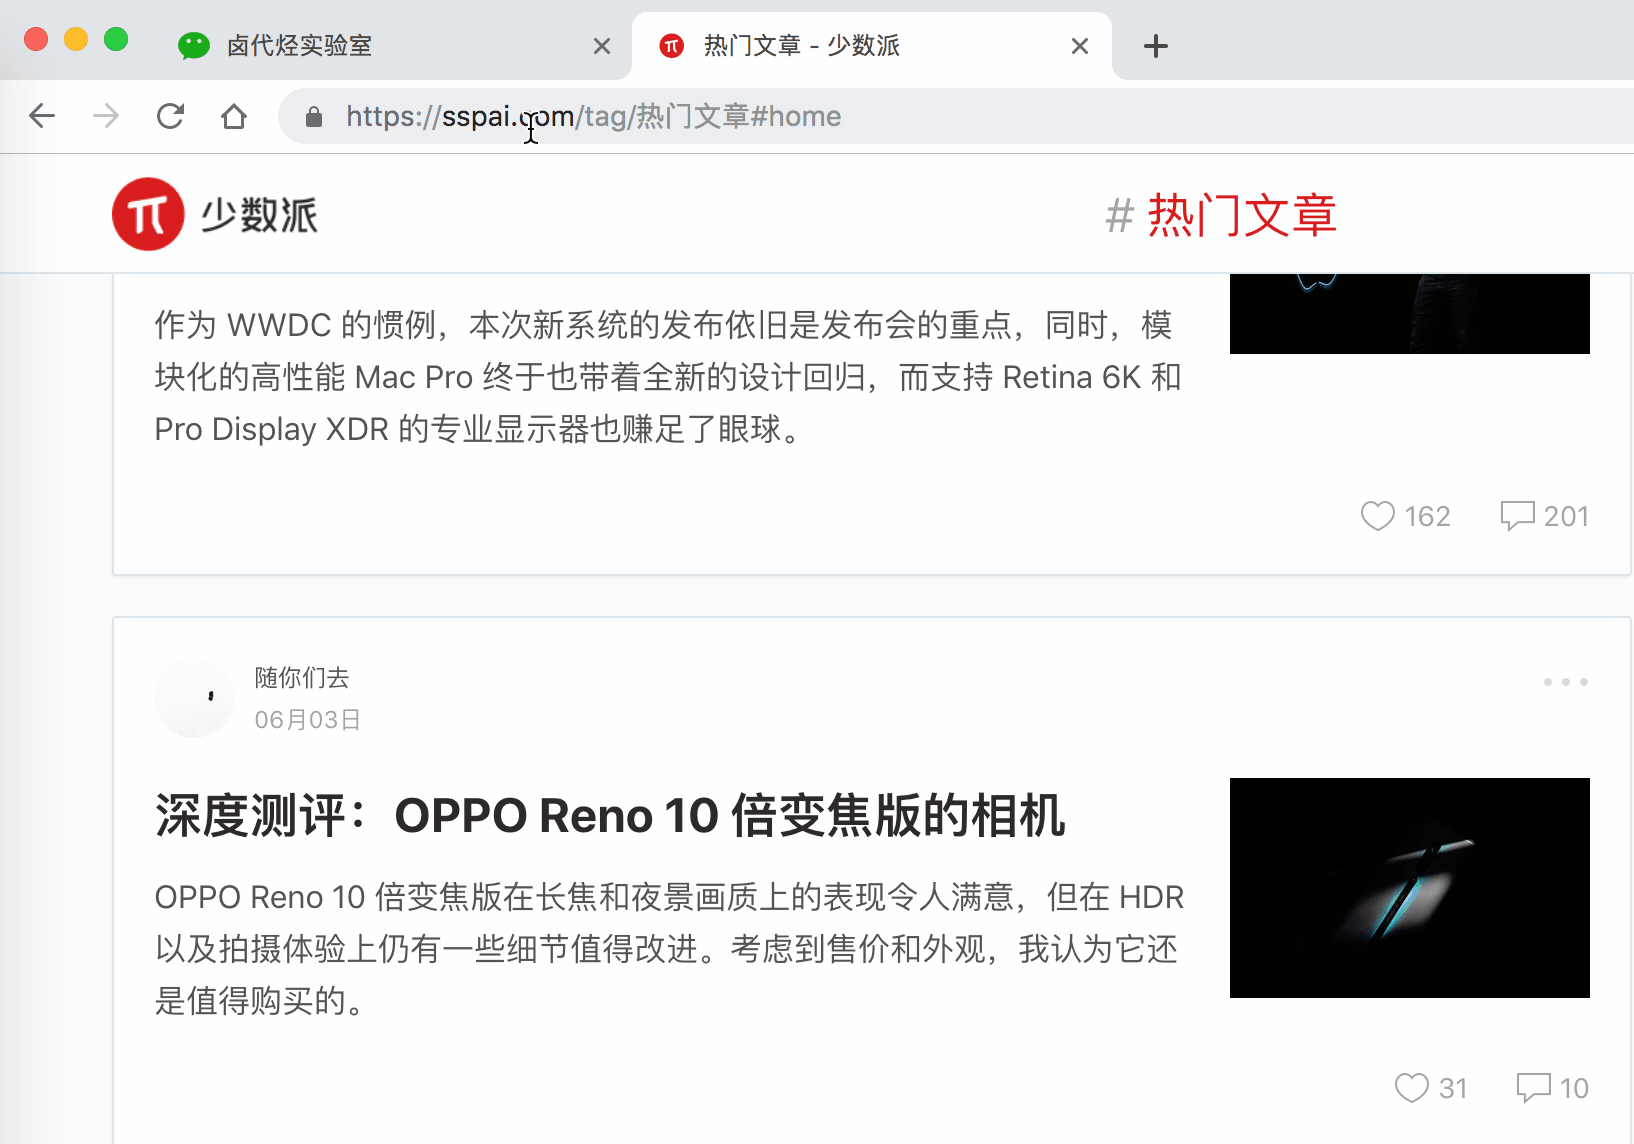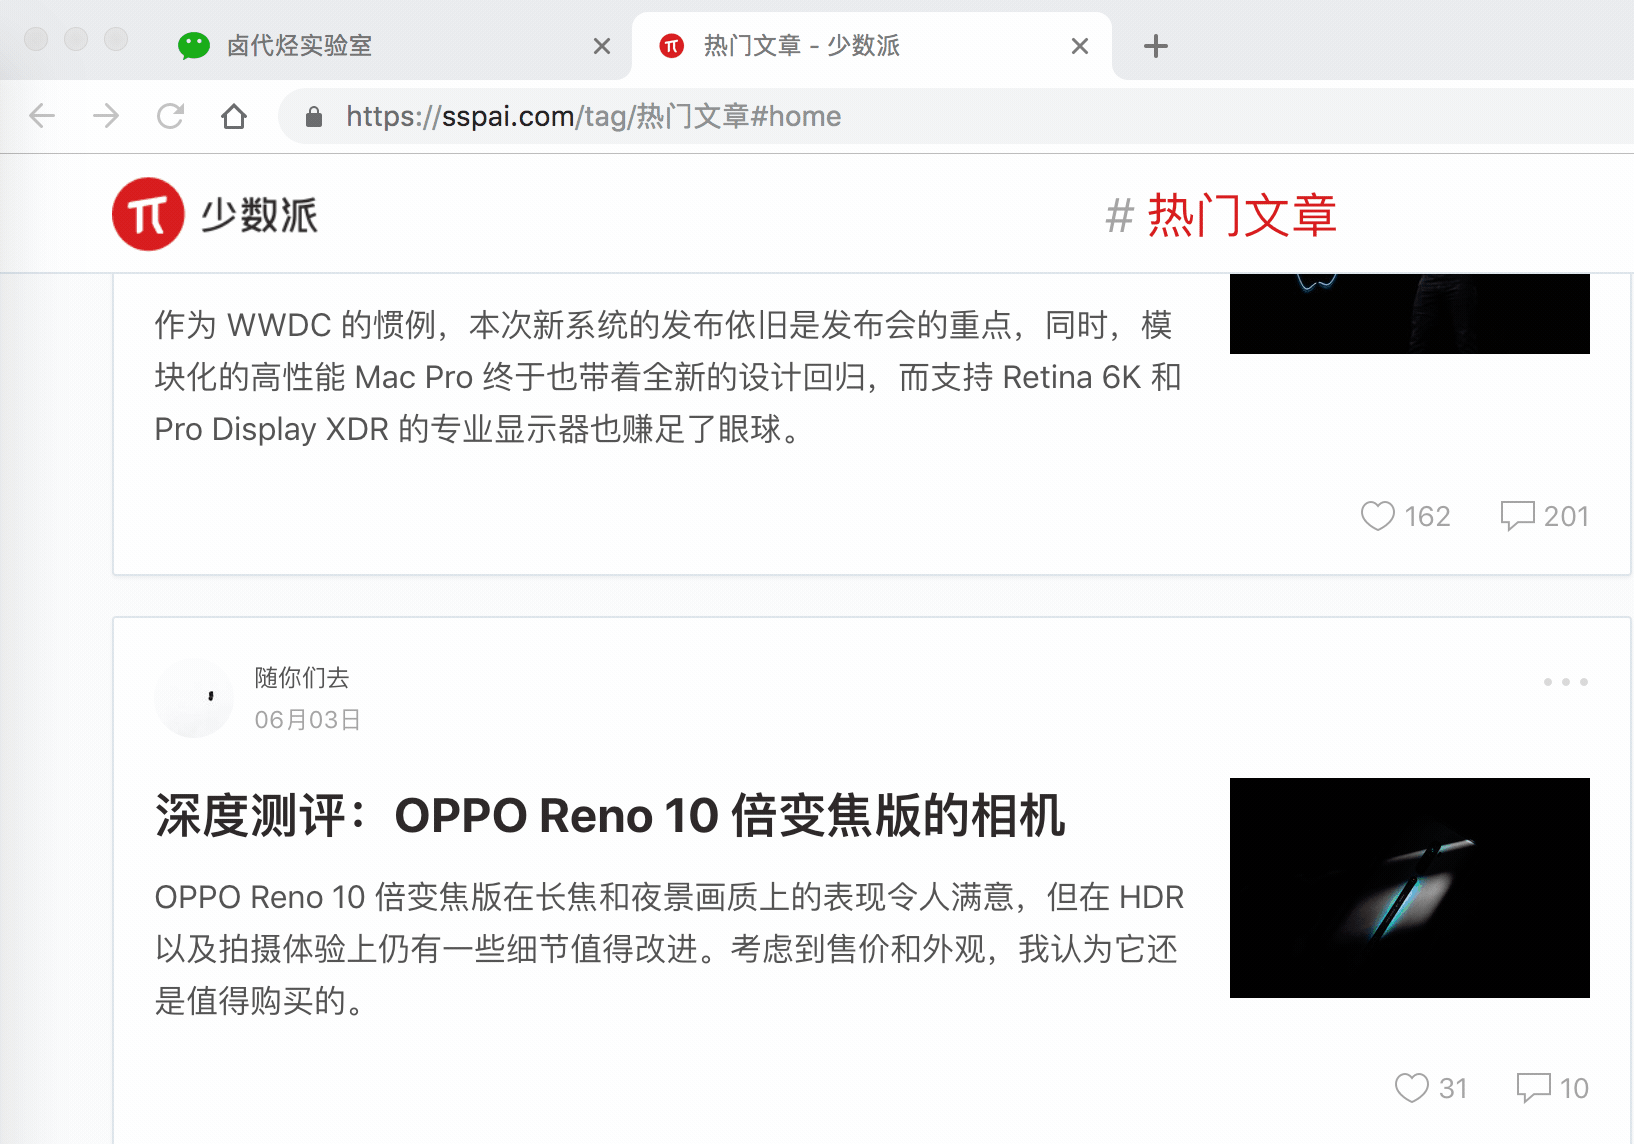
今天我们讲的,就是利用 web scraper 里的 Element click 模拟点击「加载更多」,去加载更多的数据。
这次的练习网站,我们拿少数派网站的热门文章作为我们的练习对象,对应的网址链接是:
https://sspai.com/tag/%E7%83%AD%E9%97%A8%E6%96%87%E7%AB%A0#home
为了复习上一个小节的内容,这次我们模拟点击翻页的同时,还要抓取多条内容,包括作者、标题、点赞数和评论数。

下面开始我们的数据采集之路。
2019-12-22 补充:
少数派官网改版,和我当初写教程的时抓取的网站有些许不同,主要改动有以下几点:
- 「加载更多」按钮改为「更多」按钮,而且在网页全屏的情况下改为下拉自动加载,网页宽度半屏的情况下为点击「更多」按钮翻页,建议大家在半屏的情况下练习
- 只能抓取作者、标题和点赞数这 3 个数据,无法抓取评论数
- 网页 UI 样式有些许改动,但逻辑都是相通的,不影响教程学习和数据抓取
老规矩,第一步我们先创建一个少数派的 sitmap,取名为 sspai_hot,起始链接为 https://sspai.com/tag/%E7%83%AD%E9%97%A8%E6%96%87%E7%AB%A0#home。

通过上一节的内容,我们知道想在 web scraper 里想抓取多种类型的数据,必须先创建一个容器(container),这个容器包含多种类型的数据,所以我们第二步就是要创建容器的 selector。
要注意的是,这个 selector 的 Type 类型选为 Element click,翻译成中文就是模拟点击元素,意如其名,我们可以利用这种类型模拟点击「加载更多」按钮。

这种类型的 selector,会多出几个选项,第一个就是 Click selector,这个就是选择「加载更多」按钮的,具体操作可见下图的动图。
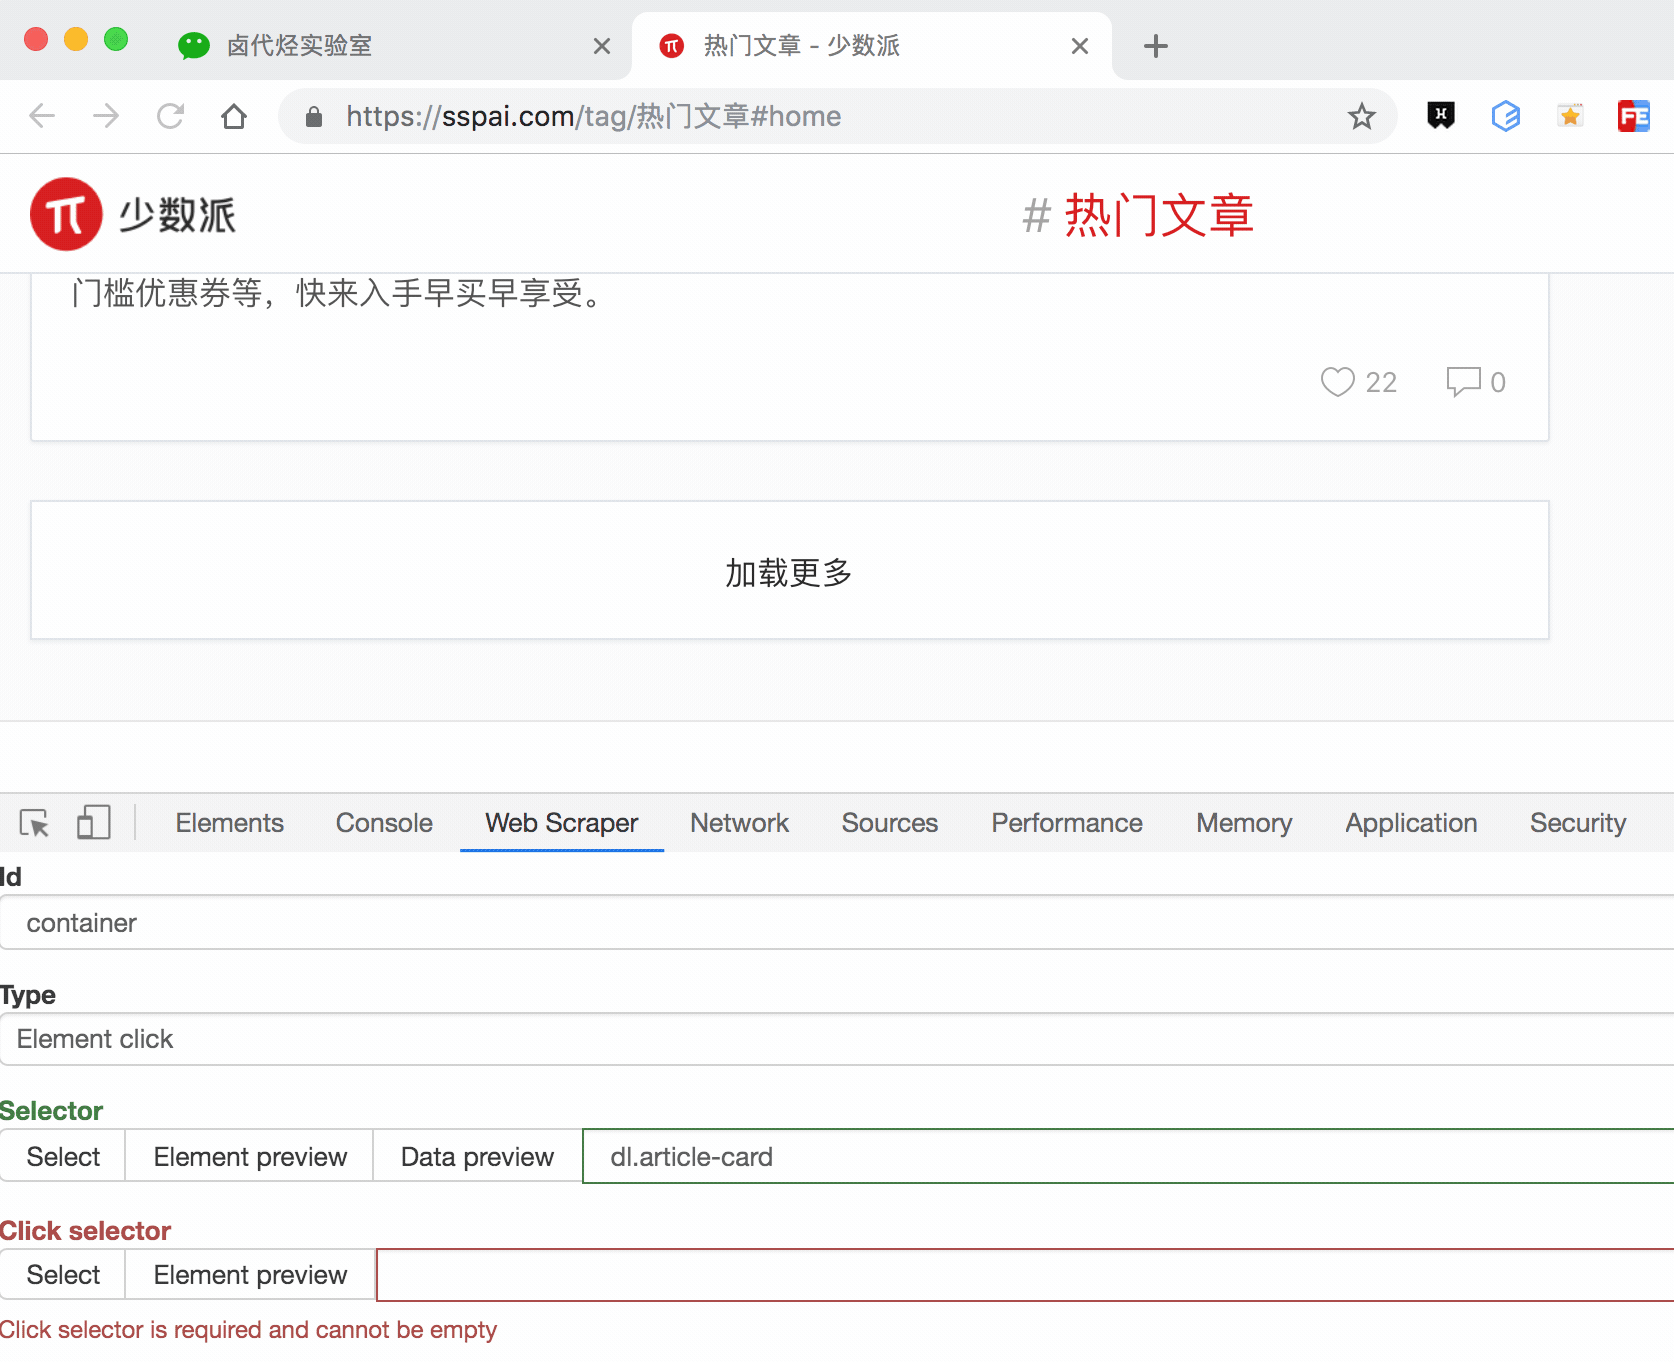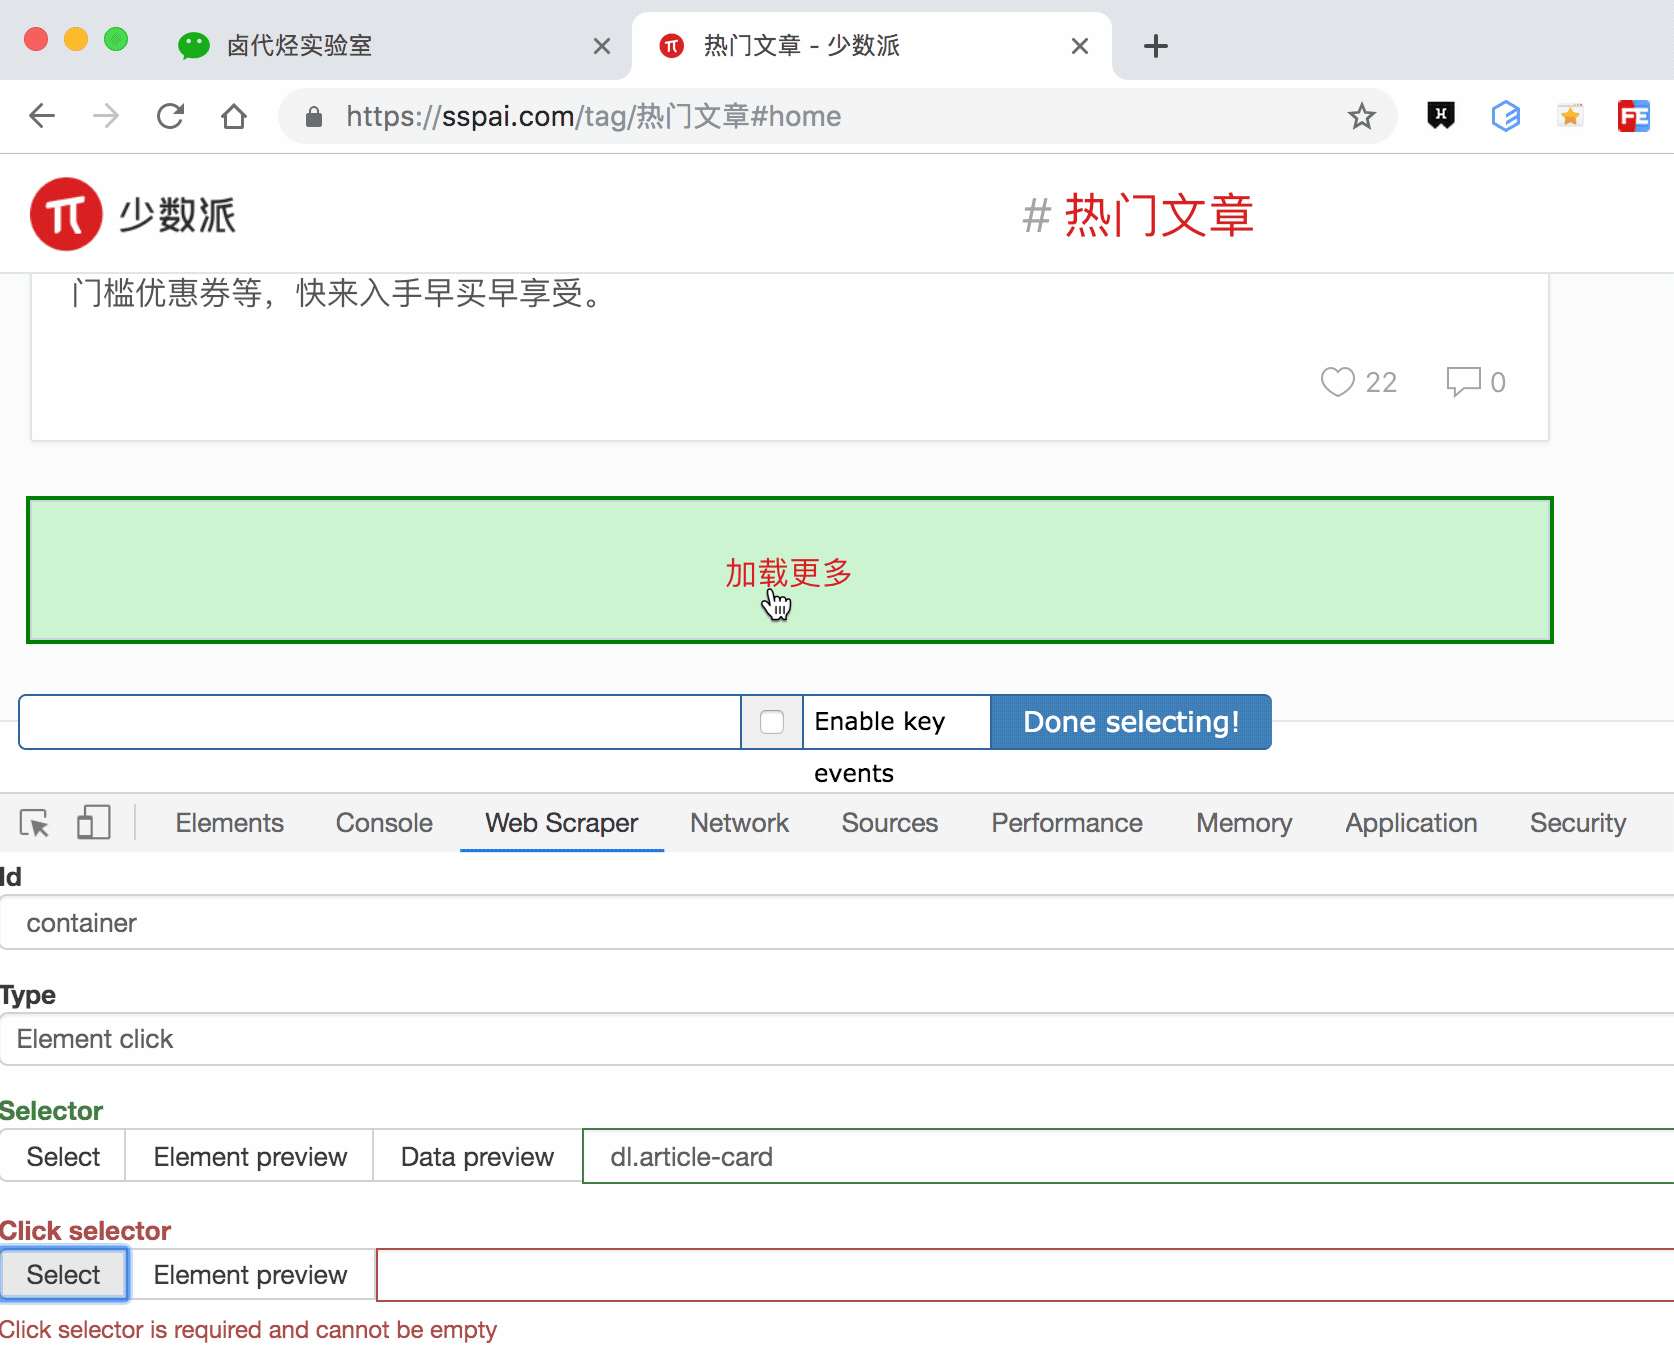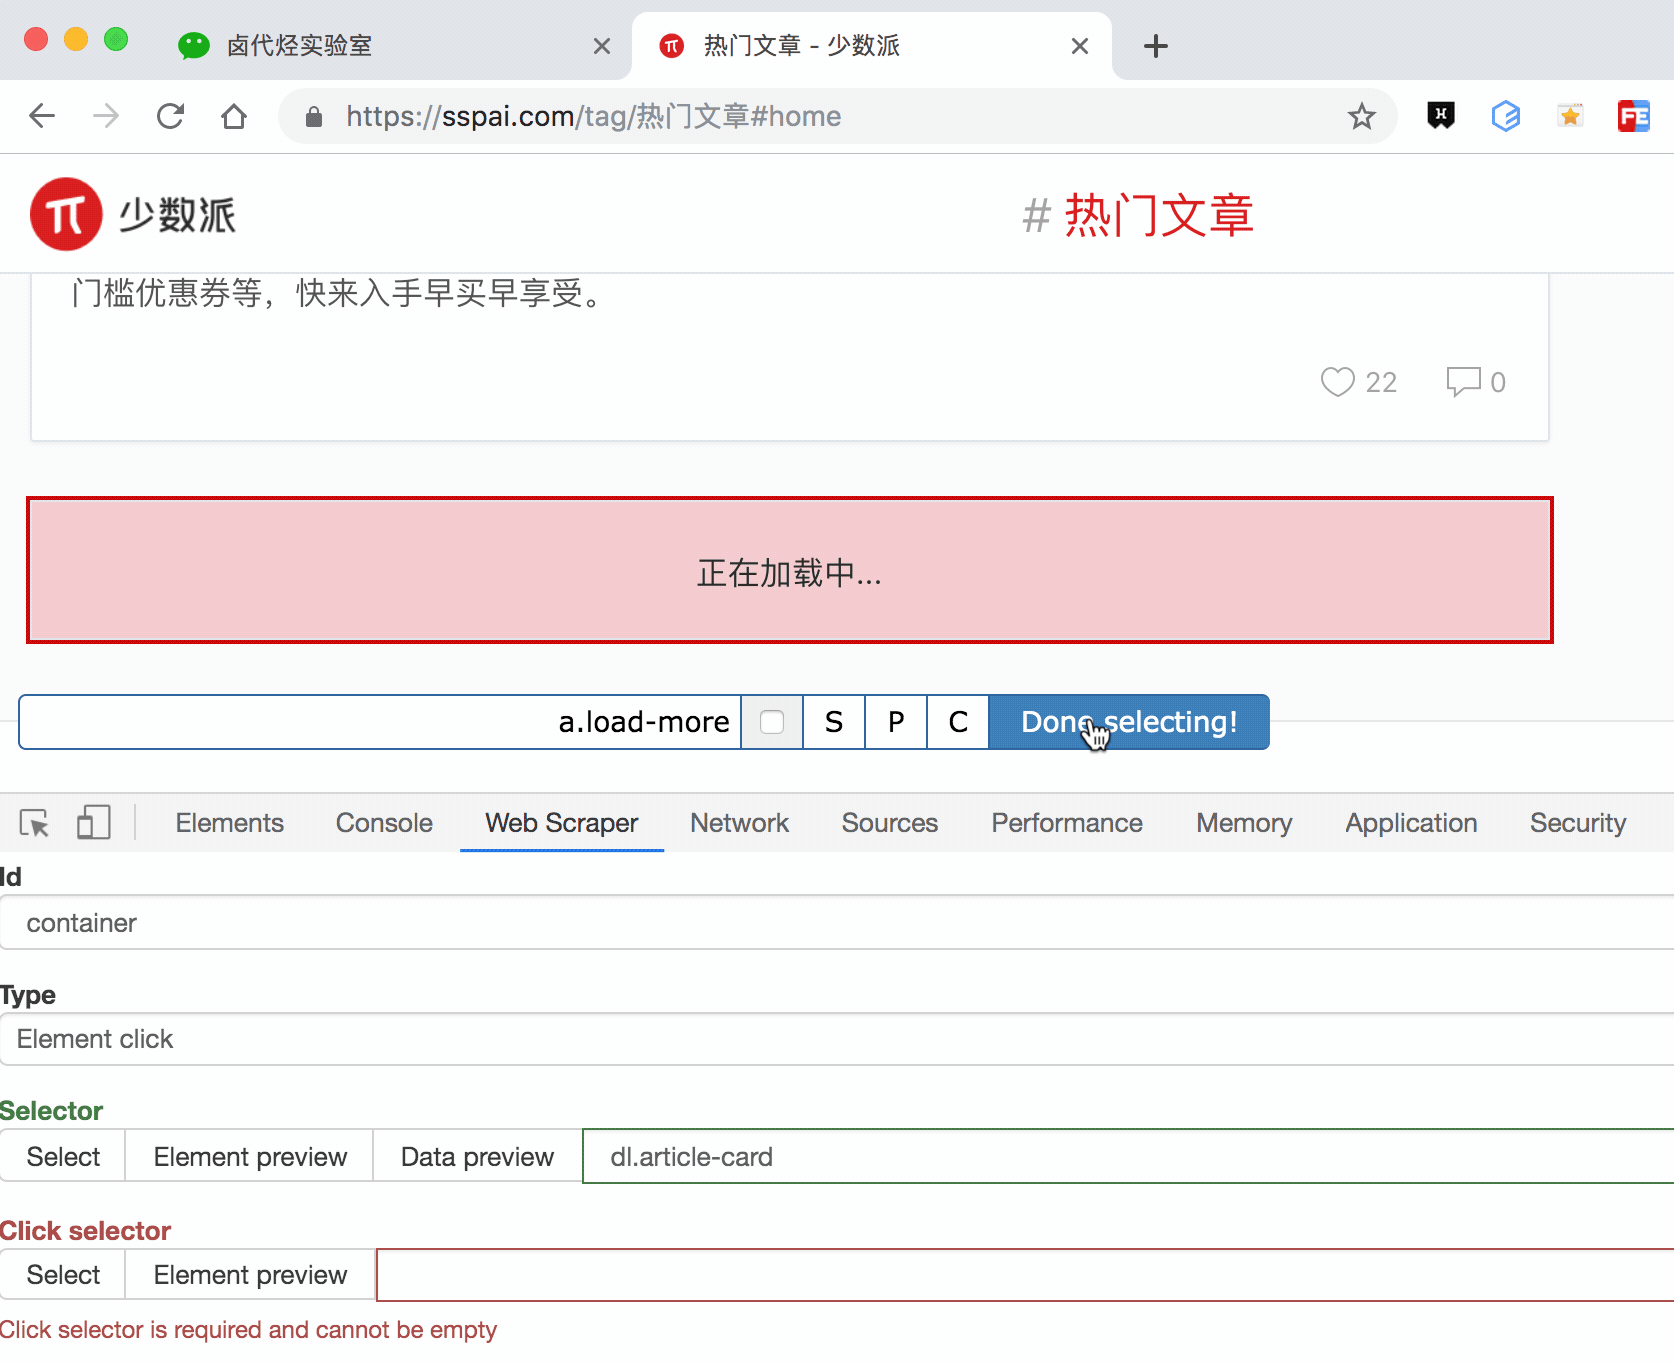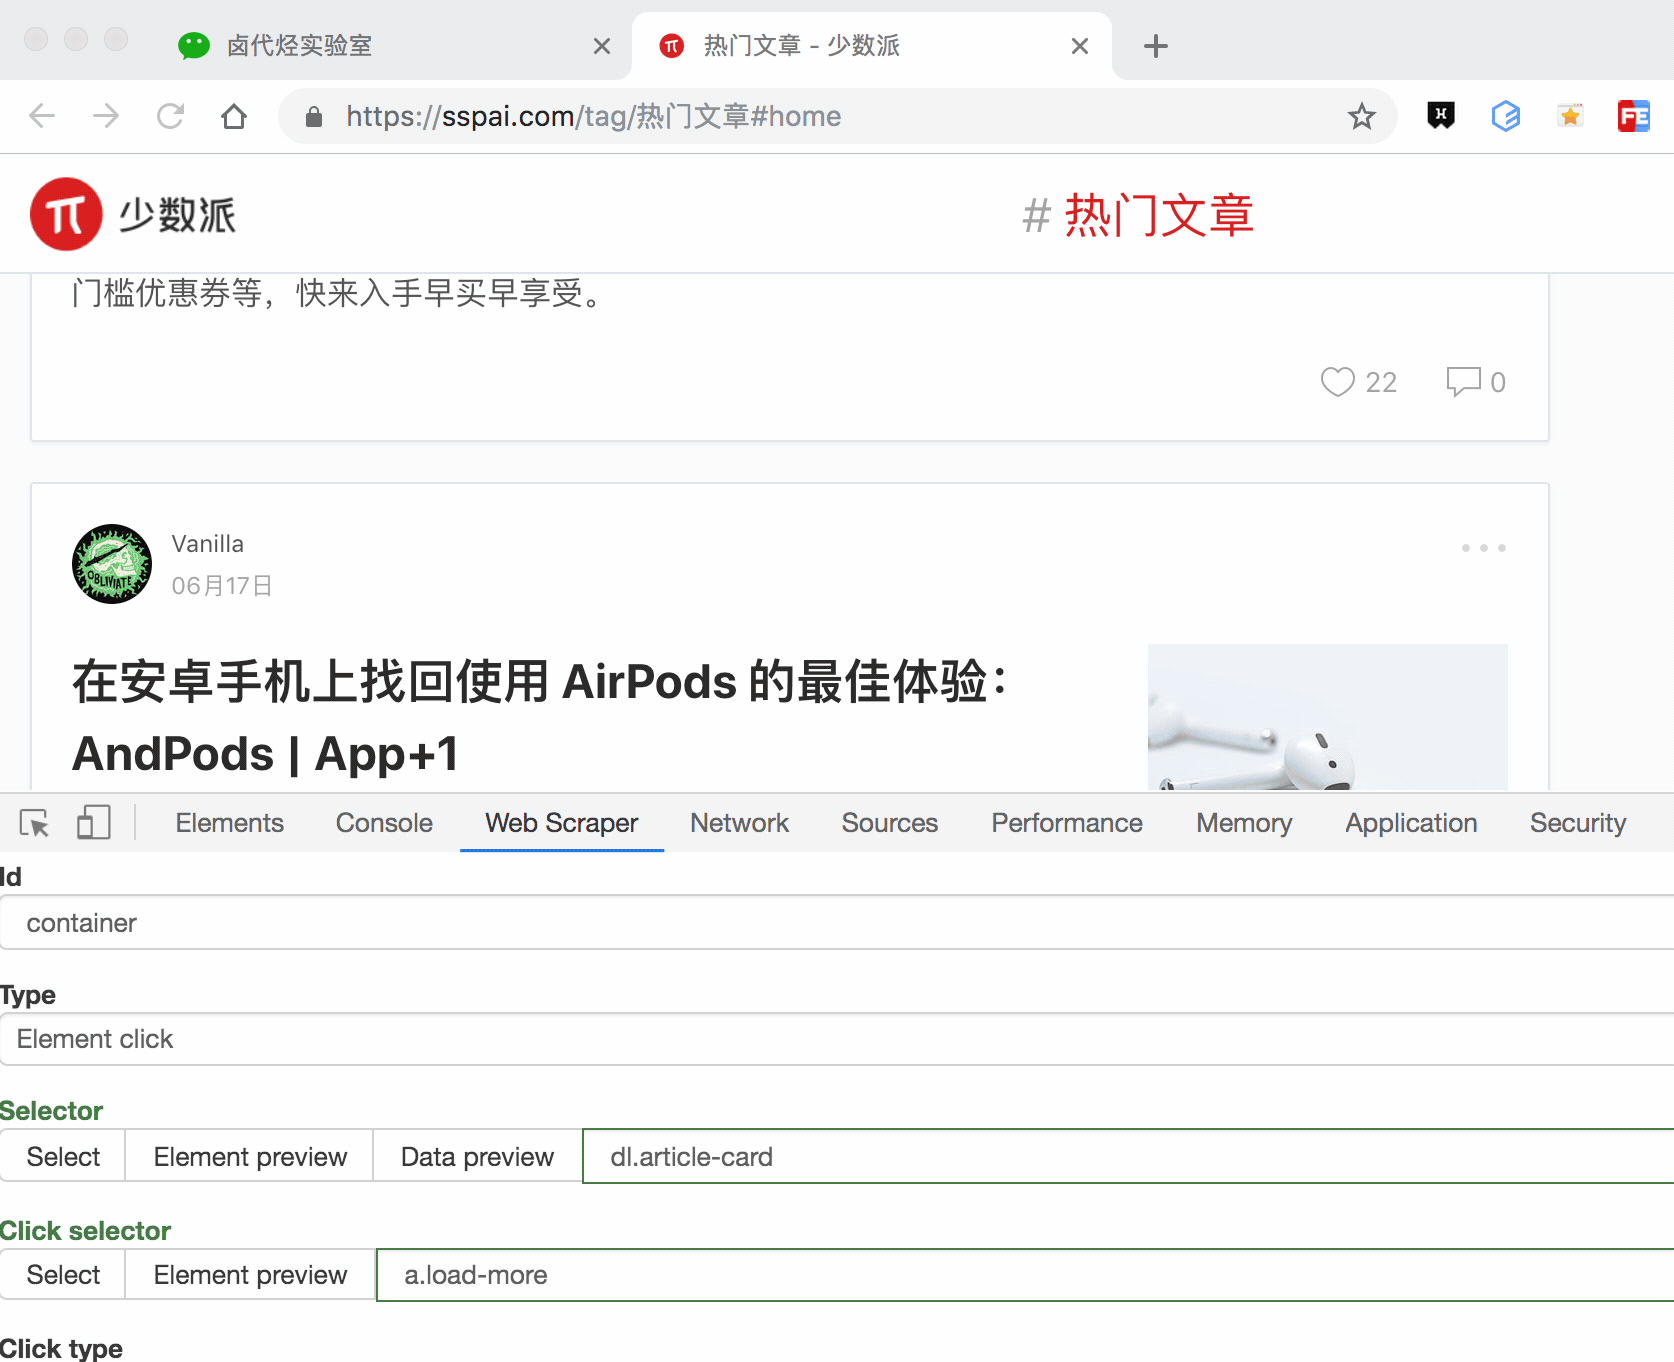
还有几个多出来的选项,我们一一解释一下:

1.Click type
点击类型,click more 表示点击多次,因为我们要抓取批量数据,这里就选择 click more,还有一个 click once 选项,点击一次
2.Click element uniqueness
这个选项是控制 Web Scraper 什么时候停止抓取数据的。比如说 Unique Text,表示文字改变时停止抓取数据。
我们都知道,一个网站的数据不可能是无穷无尽的,总有加载完的时候,这时候「加载更多」按钮文字可能就变成「没有更多」、「没有更多数据」、「加载完了」等文字,当文字变动时,Web scraper 就会知道没有更多数据了,会自动停止抓取数据。
3.Multiple
这个我们的老朋友了,表示是否多选,这里我们要抓取多条数据,当然要打勾。
4.Discard initial elements
是否丢弃初始元素,这个主要是去除一些网站的重复数据用的,不是很重要,我们这里也用不到,直接选择 Never discard,从不丢弃数据。
5.Delay
延迟时间,因为点击加载更多后,数据加载需要一段时间,delay 就是等待数据加载的时间。一般我们设置要大于等于 2000,因为延迟 2s 是一个比较合理的数据,如果网络不好,我们可以设置更大的数字。
接下来我们创建几个子选择器,分别抓取作者、标题、点赞数和评论数四种类型的数据,详细操作我在上一篇教程中已经说明了,这里我就不详细说明了。整个爬虫的结构如下,大家可以参考一下:

按照 Sitemap spay_hot -> Scrape 的操作路径就可以抓取数据了。

今天我们学习了通过 Web Scraper 抓取点击加载更多类型的网页。实践过程中,你会发现这种类型的网页无法控制爬取数目,不像豆瓣 TOP250,明明白白就是 250 条数据,不多也不少。下一篇我们就聊聊,如何利用 Web Scraper,自动控制抓取的数目。
简易数据分析 04 | Web Scraper 初尝--抓取豆瓣高分电影
简易数据分析 06 | 如何导入别人已经写好的 Web Scraper 爬虫
简易数据分析 07 | Web Scraper 抓取多条内容
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。