






这是简易数据分析系列的第 12 篇文章。
本文首发于博客园:简易数据分析 12。
前面几篇文章我们介绍了 Web Scraper 应对各种翻页的解决方法,比如说修改网页链接加载数据、点击“更多按钮“加载数据和下拉自动加载数据。今天我们说说一种更常见的翻页类型——分页器。
本来想解释一下啥叫分页器,翻了一堆定义觉得很繁琐,大家也不是第一年上网了,看张图就知道了。我找了个功能最全的例子,支持数字页码调整,上一页下一页和指定页数跳转。

今天我们就学学,Web Scraper 怎么对付这种类型的网页翻页。
其实我们在本教程的第一个例子,抓取豆瓣电影 TOP 排行榜中,豆瓣的这个电影榜单就是用分页器分割数据的:

但当时我们是找网页链接规律抓取的,没有利用分页器去抓取。因为当一个网页的链接变化规律时,控制链接参数抓取是实现成本最低的;如果这个网页进可以翻页,但是链接的变化不是规律的,就得去会一会这个分页器了。
说这些理论有些枯燥,我们举个翻页链接不规律的例子。
8 月 2 日是蔡徐坤的生日,为了表达庆祝,在微博上粉丝们给坤坤刷了 300W 的转发量,微博的转发数据正好是用分页器分割的,我们就分析一下微博的转发信息页面,看看这类数据怎么用 Web Scraper 抓取。

这条微博的直达链接是:
https://weibo.com/1776448504/I0gyT8aeQ?type=repost
看了他那么多的视频,为了表达感激,我们可以点进去出为坤坤加一份阅读量。
首先我们看看第 1 页转发的链接,长这个样子:
https://weibo.com/1776448504/I0gyT8aeQ?type=repost
第 2 页长这个样子,注意到多了个 #_rnd1568563840036 参数:
https://weibo.com/1776448504/I0gyT8aeQ?type=repost#_rnd1568563840036
第 3 页参数为 #_rnd1568563861839
https://weibo.com/1776448504/I0gyT8aeQ?type=repost#_rnd1568563861839
第 4 页参数为 #_rnd1568563882276:
https://weibo.com/1776448504/I0gyT8aeQ?type=repost#_rnd1568563882276
多看几个链接你就可以发现,这个转发网页的网址毫无规律可言,所以只能通过分页器去翻页加载数据。下面就开始我们的实战教学环节。
我们首先创建一个 SiteMap,这次取名为 cxk,起始链接为
https://weibo.com/1776448504/I0gyT8aeQ?type=repost。

因为我们要点击分页器,外面的容器的类型我们选为 Element Click,具体的参数解释可以看下图,我们之前在简易数据分析 08详细解释过一次,这里就不多言了。

container 的预览是下图的样子:

分页器选择的过程可以参看下图:
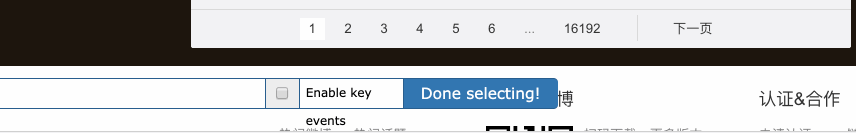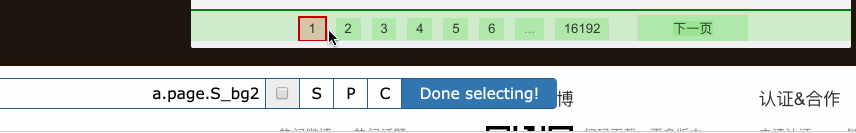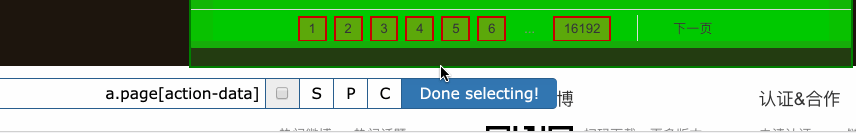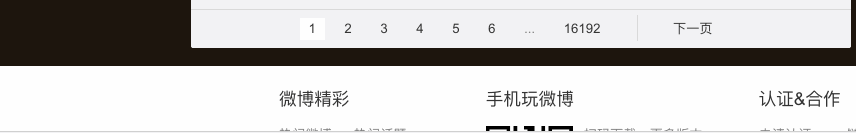
这几个子选择器都比较简单,类型都是文字选择器,我们选择了评论用户名,评论内容和评论时间三种类型的内容。

按照 Sitemap cxk -> Scrape 的操作路径就可以抓取数据了。
如果你看了我上面的教程立马去爬数据,可能遇到的第一个问题就是,300w 的数据,难道我全部爬下来吗?
听上去也不太现实,毕竟 Web Scraper 针对的数据量都是相对比较小的,几万数据都算多的了,数据再大你就得考虑爬取时间是否太长,数据如何存储,如何应对网址的反爬虫系统(比如说冷不丁的跳出一个验证码,这个 Web Scraper 是无能为力的)。
考虑到这个问题,前面的自动控制抓取数量的教程你又看过的话,可能想着用 :nth-of-type(-n+N) 控制抓取 N 条数据。如果你尝试了,就会发现这个方法根本没用。
失效的原因其实涉及到一点点网页的知识了,感兴趣的话可以看看下面的解释,不感兴趣可以直接看最后的结论。
像我前面介绍的点击更多加载型网页和下拉加载型网页,他们新加载的数据,是在当前页面追加的,你一直下拉,数据一直加载,同时网页的滚动条会越来越短,这意味着所有的数据都在同一个页面。
当我们用 :nth-of-type(-n+N) 控制加载数量时,其实相当于在这个网页设立一个计数器,当数据一直累加到我们想要的数量时,就会停止抓取。
但是对于使用翻页器的网页,每次的翻页相当于刷新当前网页,这样每次都会设立一个计数器。
比如说你想抓取 1000 条数据,但是第 1 页网页只有 20 条数据,抓到最后一条了,还差 980 条;然后一翻页,又设立一个新的计数器,抓完第 2 页的最后一条数据,还差 980,一翻页计数器就重置,又变成 1000 了......所以这个控制数量的方法就失效了。
所以结论就是,如果翻页器类型的网页想提前结束抓取,只有断网的这种方法。当然,如果你有更好的方案,可以在评论里回复我,我们可以互相讨论一下。
分页器是一种很常见的网页分页方法,我们可以通过 Web Scraper 中的 Element click 处理这种类型的网页,并通过断网的方法结束抓取。
简易数据分析 05 | Web Scraper 翻页——控制链接批量抓取数据
简易数据分析 08 | Web Scraper 翻页——点击「更多按钮」翻页
简易数据分析 10 | Web Scraper 翻页——抓取「滚动加载」类型网页
简易数据分析 09 | Web Scraper 自动控制抓取数量 & Web Scraper 父子选择器
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。