








这是简易数据分析系列的第 10 篇文章。
原文首发于博客园:简易数据分析 10。
友情提示:这一篇文章的内容较多,信息量比较大,希望大家学习的时候多看几遍。
我们在刷朋友圈刷微博的时候,总会强调一个『刷』字,因为看动态的时候,当把内容拉到屏幕末尾的时候,APP 就会自动加载下一页的数据,从体验上来看,数据会源源不断的加载出来,永远没有尽头。
我们今天就是要讲讲,如何利用 Web Scraper 抓取滚动到底翻页的网页。
今天我们的练手网站是知乎数据分析模块的精华帖,网址为:
https://www.zhihu.com/topic/19559424/top-answers

这次要抓取的内容是精华帖的标题、答题人和赞同数。下面是今天的教程。
刚开始我们要先创建一个 container,包含要抓取的三类数据,为了实现滚动到底加载数据的功能,我们把 container 的 Type 选为 Element scroll down,就是滚动到网页底部加载数据的意思。

在这个案例里,选择的元素名字为 div.List-item。

为了复习上一节通过数据编号控制条数的方法,我们在元素名后加个 nth-of-type(-n+100),暂时只抓取前 100 条数据。

然后我们保存 container 这个节点,并在这个节点下选择要抓取的三个数据类型。
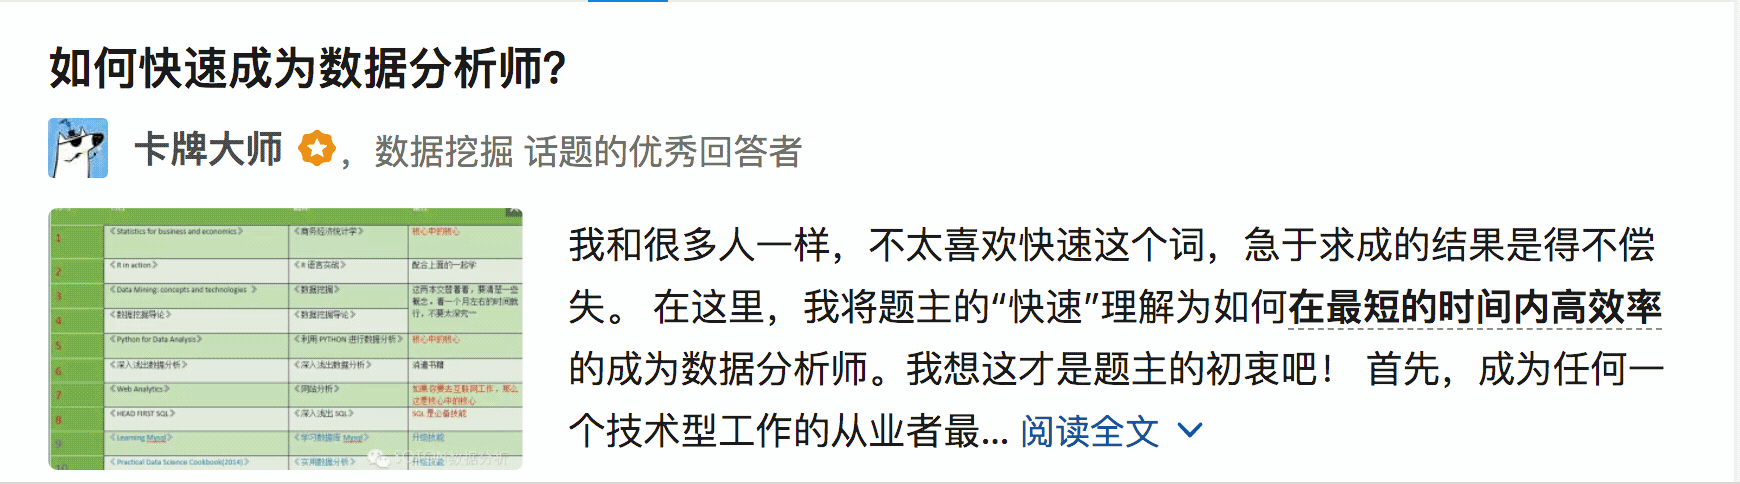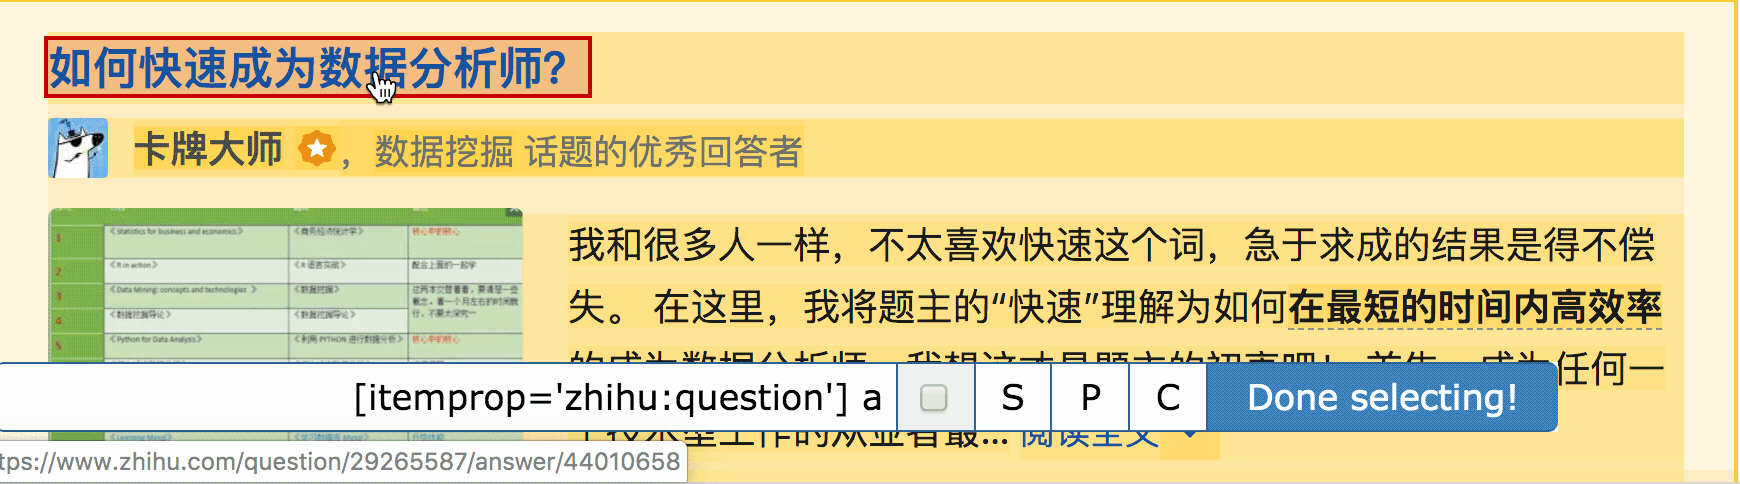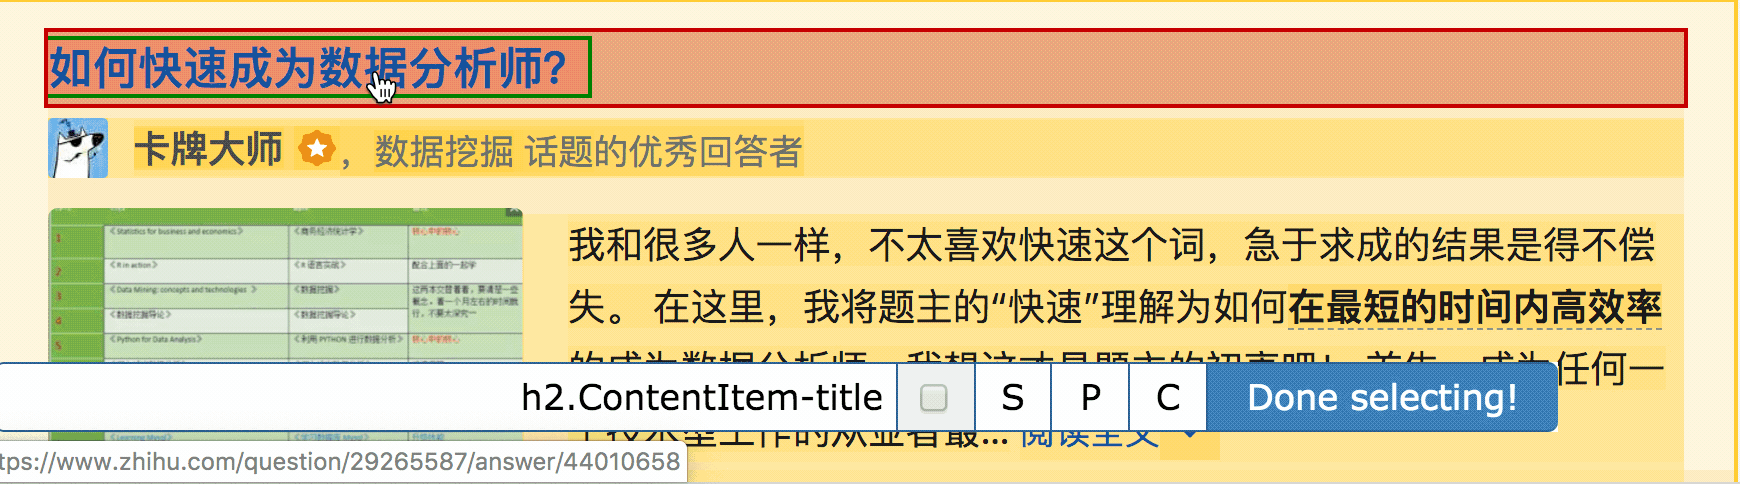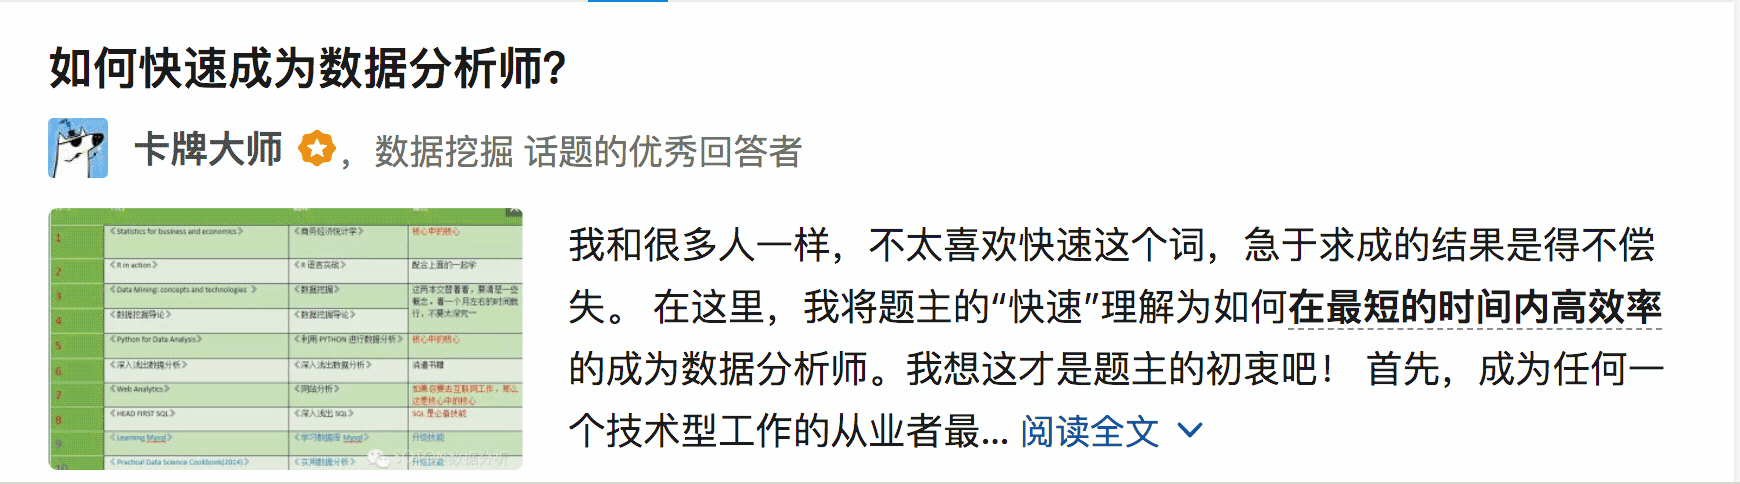
首先是标题,我们取名为 title,选择的元素名为 [itemprop='zhihu:question'] a:

然后是答题人名字 name 与 赞同数 like,选择的元素名分别为 #Popover10-toggle a 和 button.VoteButton--up:


元素都选择好了,我们按 Sitemap zhihu_top_answers -> Scrape -> Start craping 的路径进行数据抓取,等待十几秒结果出来后,内容却让我们傻了眼:

数据呢?我要抓的数据呢?怎么全变成了 null?
在计算机领域里,null 一般表示空值,表示啥都没有,放在 Web Scraper 里,就表示没有抓取到数据。

我们可以回想一下,网页上的的确确存在数据,我们在整个的操作过程中,唯一的变数就是选择元素这个操作上。所以,肯定是我们选择元素时出错了,导致内容匹配上出了问题,无法正常抓取数据。要解决这个问题,我们就要查看一下网页的构成。
查看一下网页的构成,就要用浏览器的另一个功能了,那就是选择查看元素。
Elements 这个子面板,内容是一些花花绿绿看不大懂的代码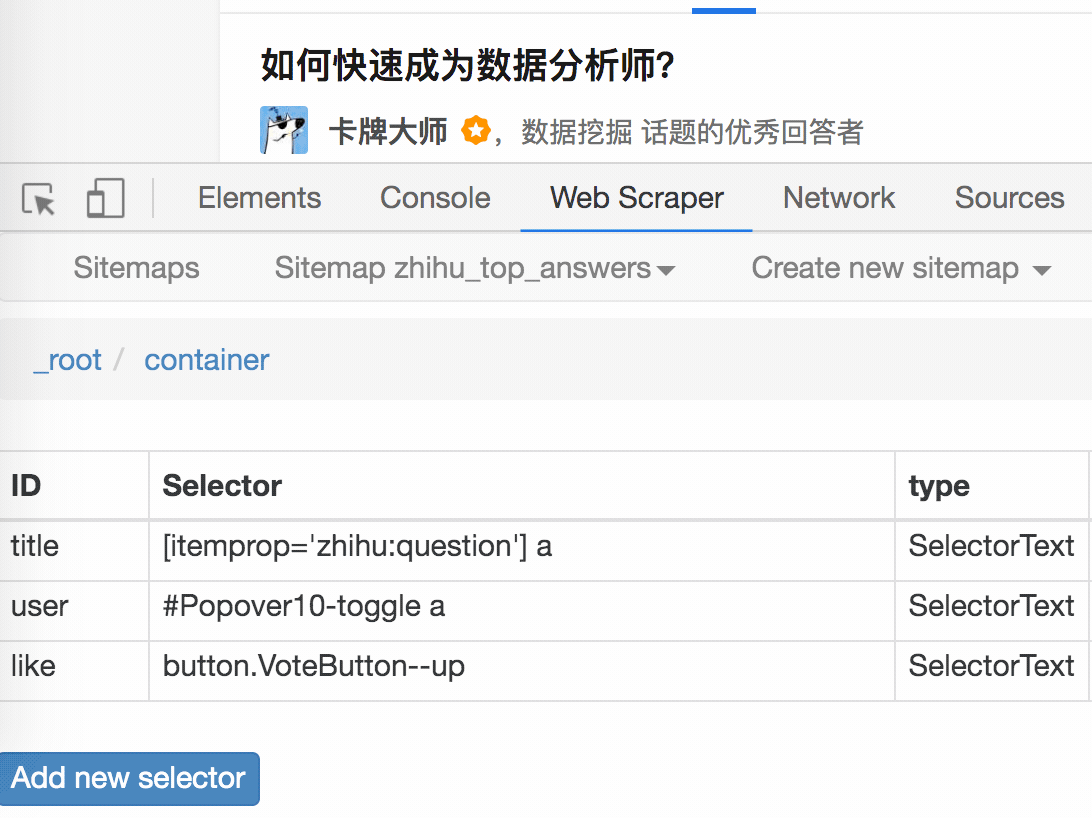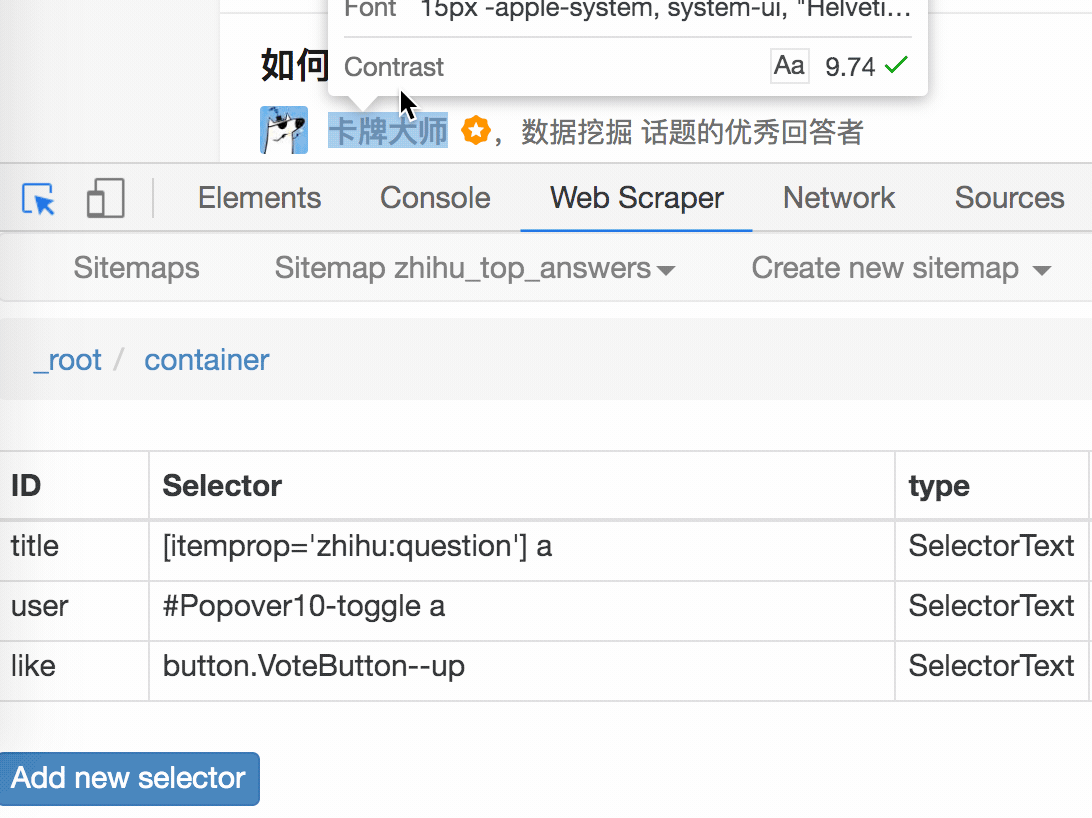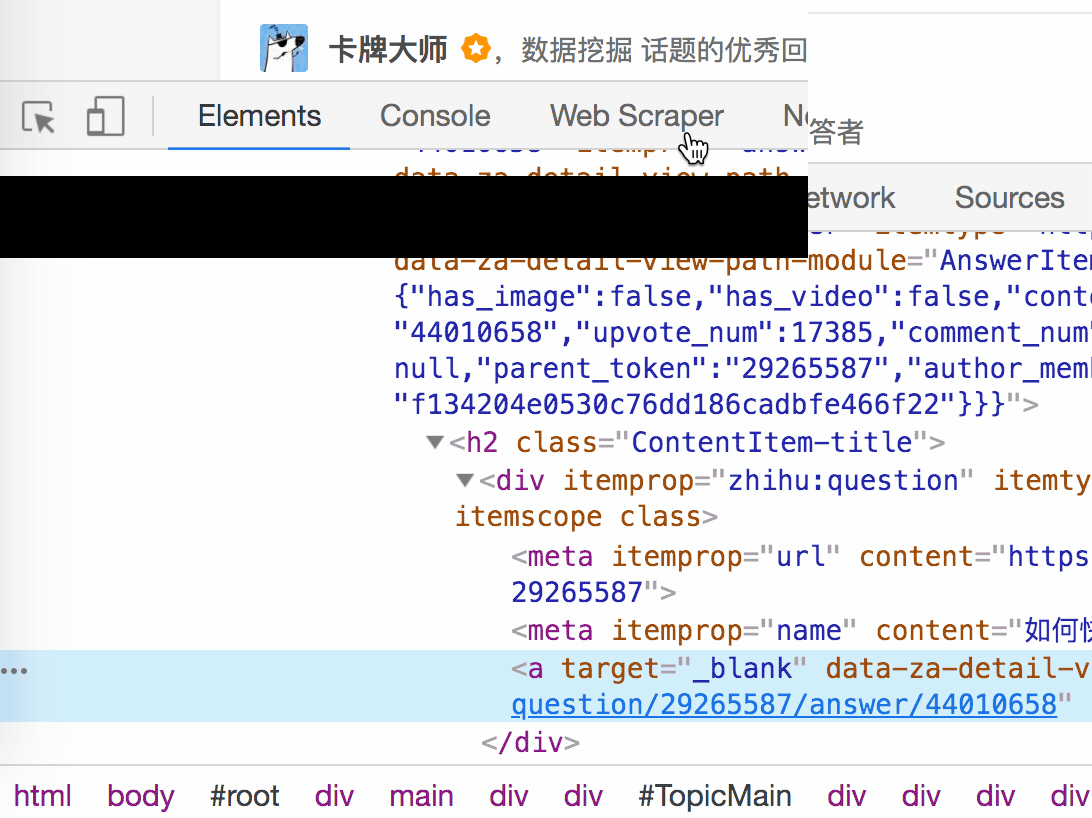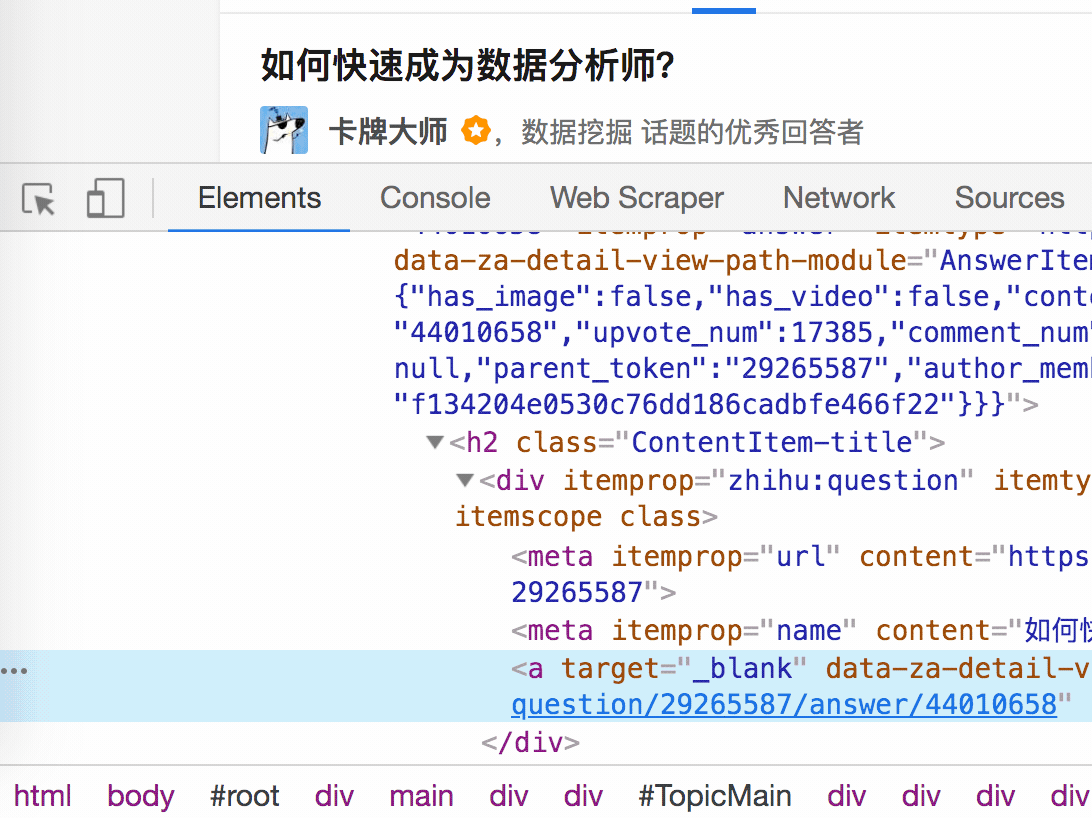
做到这里心里别发怵,这些 HTML 代码不涉及什么逻辑,在网页里就是个骨架,提供一些排版的作用。如果你平常用 markdown 写作,就可以把 HTML 理解为功能更复杂的 markdown。
结合 HTML 代码,我们先看看 [itemprop='zhihu:question'] a 这个匹配规则是怎么回事。

首先这是个树形的结构:
上句话从可视化的角度分析,其实就是一个嵌套的结构,我把关键内容抽离出来,内容结构是不是清晰了很多?
<h2 class='ContentItem-title'/>
    <div itemprop='zhihu:question'/>
        <a>如何快速成为数据分析师?</a>
    </div>
</h2>
我们再分析一个抓取标题为 null 的标题 HTML 代码。

我们可以很清楚的观察到,在这个标题的代码里,少了名为 div 属性为 itemprop='zhihu:question' 的标签!这样导致我们的匹配规则匹配时找不到对应标签,Web Scraper 就会放弃匹配,认为找不到对应内容,所以就变成 null 了。
找到原因后我们就好解决问题了。
我们发现,选择标题时,无论标题的嵌套关系怎么变,总有一个标签不变,那就是包裹在最外层的,属性名为 class='ContentItem-title' 的 h2 标签。我们如果能直接选择 h2 标签,不就可以完美匹配标题内容了吗?
逻辑上理清了关系,我们如何用 Web Scraper 操作?这时我们就可以用上一篇文章介绍的内容,利用键盘 P 键选择元素的父节点:
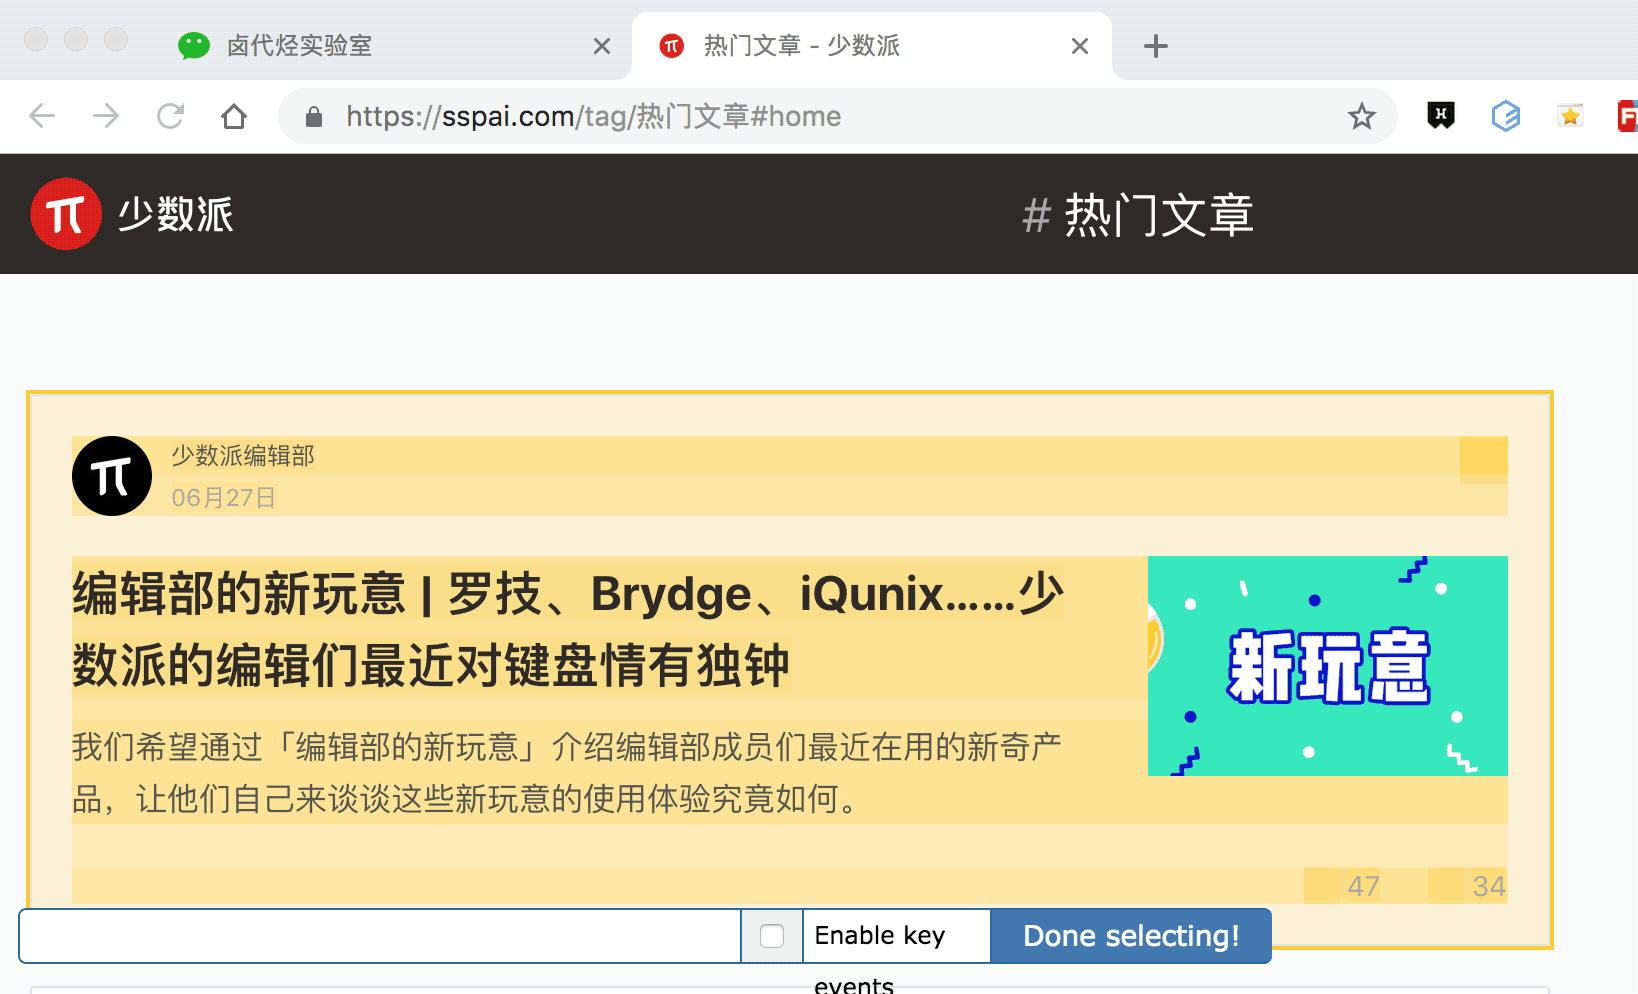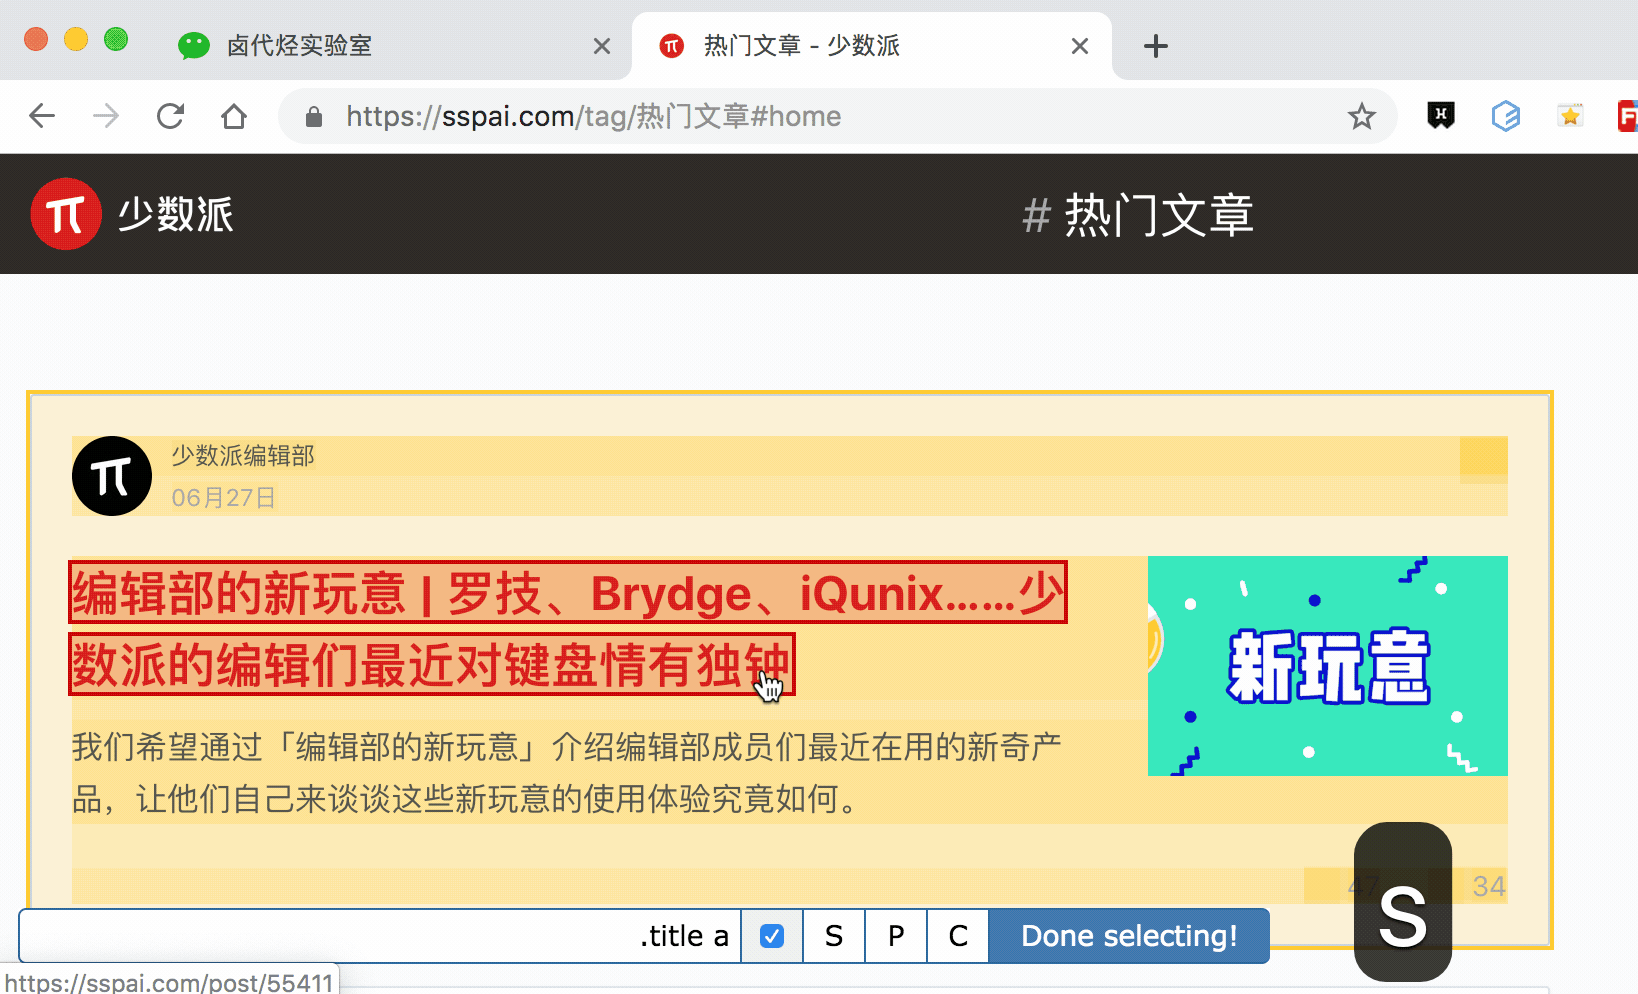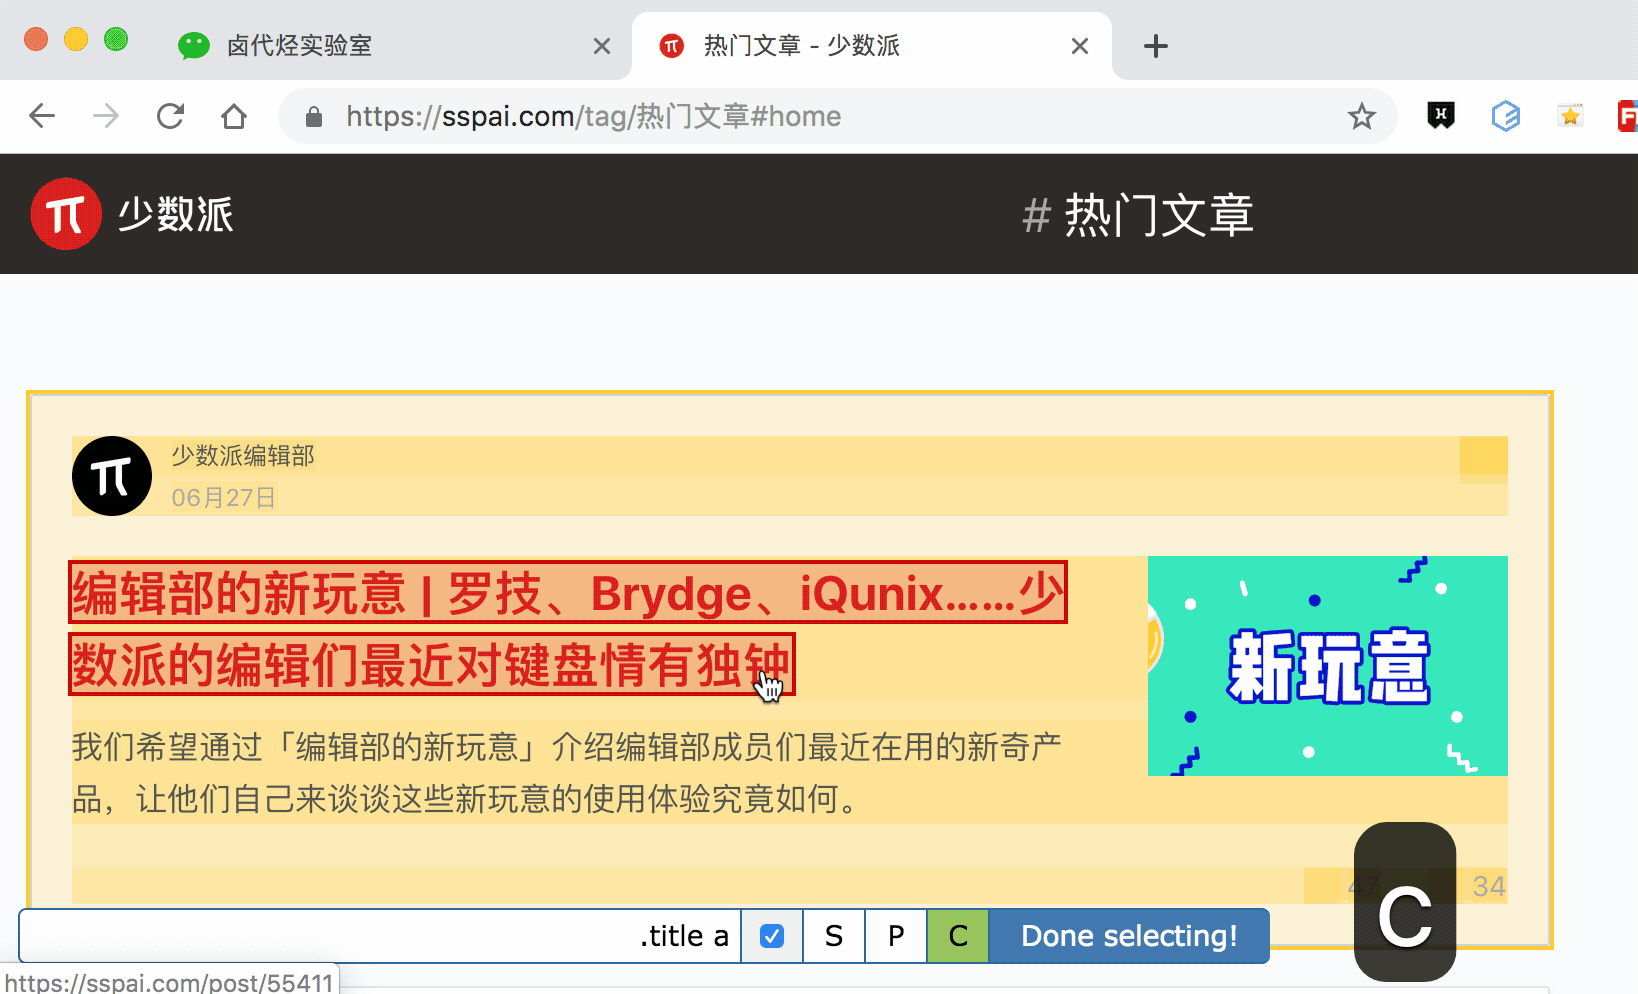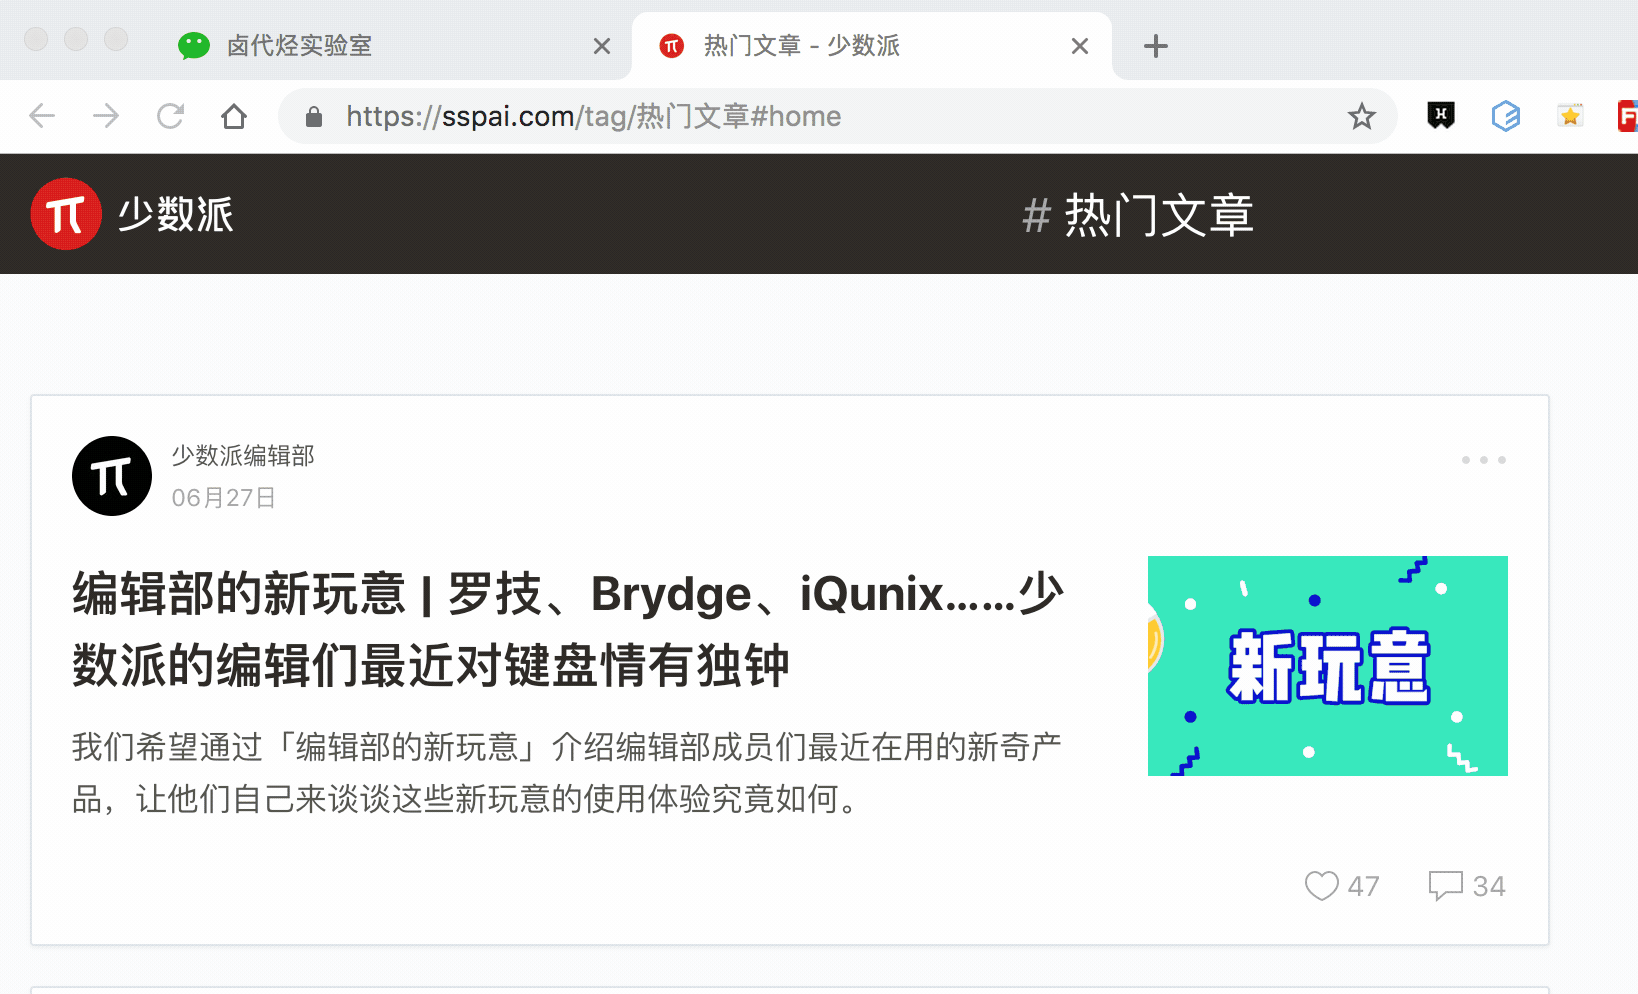
放在今天的课程里,我们点击两次 P 键,就可以匹配到标题的父标签 h2 (或 h2.ContentItem-title):
以此类推,因为答题人名字也出现了 null,我们分析了 HTML 结构后选择名字的父标签 span.AuthorInfo-name,具体的分析操作和上面差不多,大家可以尝试一下。

我的三个子内容的选择器如下,可以作为一个参考:

最后我们点击 Scrape 爬取数据,检查一下结果,没有出现 null,完美!

爬取知乎数据时,我们会发现滚动加载数据那一块儿很快就做完了,在元素匹配那里却花了很多时间。
这间接的说明,知乎这个网站从代码角度上分析,写的还是比较烂的。
如果你爬取的网站多了,就会发现大部分的网页结构都是比较「随心所欲」的。所以在正式抓取数据前,经常要先做小规模的尝试,比如说先抓取 20 条,看看数据有没有问题。没问题后再加大规模正式抓取,这样做一定程度上可以减少返工时间。
这期内容比较多,大家可以多看几遍消化一下,下期我们说些简单的内容,讲讲如何抓取表格内容。
简易数据分析 09 | Web Scraper 自动控制抓取数量 & Web Scraper 父子选择器
简易数据分析 08 | Web Scraper 翻页——点击「更多按钮」翻页
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。