









Выбор vision-модели для production — это не просто вопрос «поддерживает ли модель изображения». Разработчику нужен маршрут, который работает в реальных пользовательских сценариях: загрузка изображений, скриншоты, debugging UI, распознавание логотипов, превью документов, support tickets и agent workflows с визуальным контекстом через OpenAI-compatible API.
В этой статье сравниваются gemini-2.5-flash-lite и qwen3-vl-flash через Crazyrouter OpenAI-compatible Base URL:
Формат запроса — chat/completions, где messages[].content[] содержит текст и image_url. Каждая модель тестировалась на двух стабильных публичных изображениях — Python logo и GitHub logo — по 3 запуска на изображение.
Время теста:
2026-06-21T13:36:32Z. Это реальные API-измерения, а не пересказ model card.
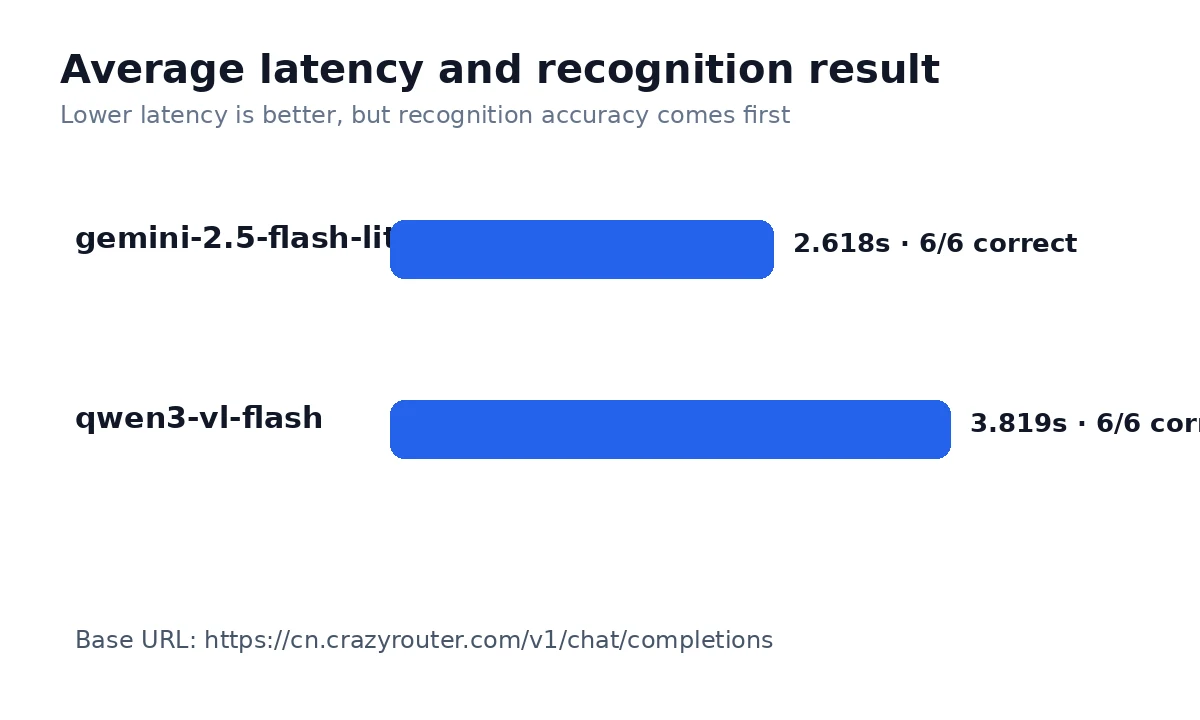
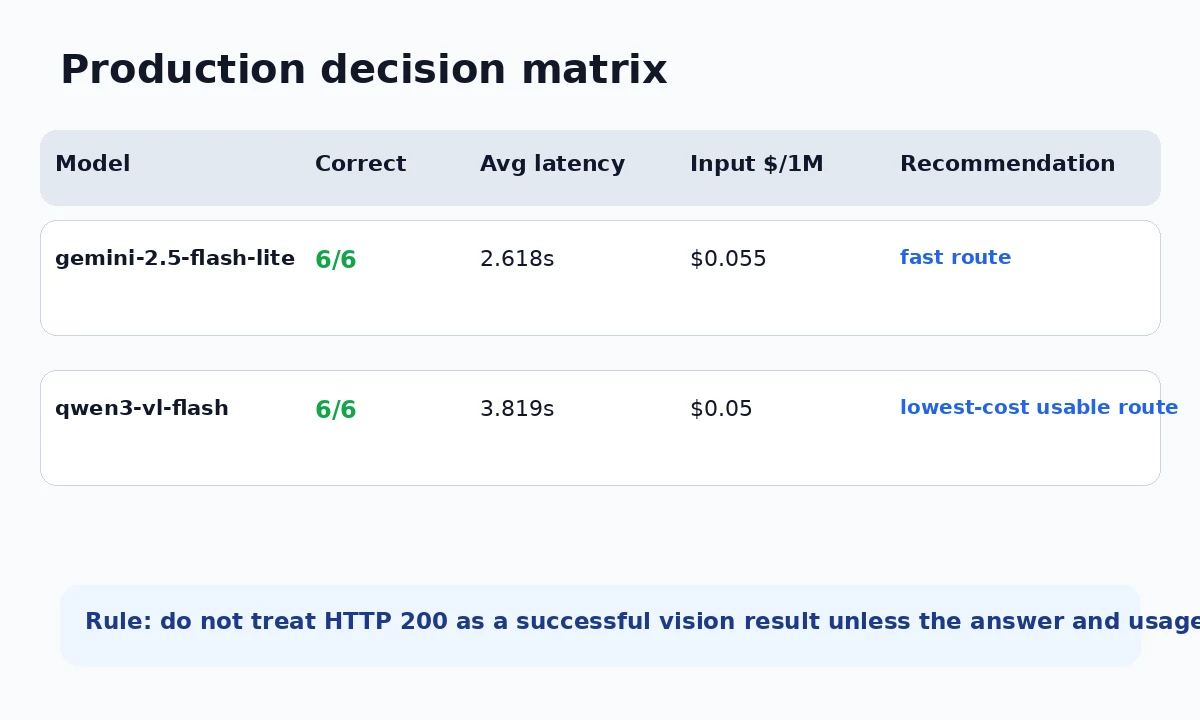
gemini-2.5-flash-lite: в этом тесте он быстрее.qwen3-vl-flash: оценочная стоимость успешного изображения ниже.| Критерий выбора | gemini-2.5-flash-lite | qwen3-vl-flash | Почему это важно |
|---|---|---|---|
| HTTP success | 6/6 | 6/6 | Показывает только транспортный успех; не доказывает, что модель увидела изображение. |
| Корректное визуальное распознавание | 6/6 | 6/6 | Главная метрика smoke test для image_url routing. |
| No-image failure claims | 0 | 0 | Помогает найти маршруты, которые приняли запрос, но не передали изображение. |
| Average latency | 2.618s | 3.819s | Влияет на ожидание пользователя в обычном запросе. |
| Median latency | 2.627s | 3.493s | Лучше отражает типичный опыт, чем среднее. |
| Slowest request | 4.195s | 5.975s | Tail latency — то, что пользователь ощущает как «зависание». |
| Input price / 1M tokens | $0.055 | $0.05 | Важно для image tagging, OCR pre-filtering и batch classification. |
| Output price / 1M tokens | $0.22 | $0.4 | Важно, если нужны длинные описания изображений. |
| Estimated cost / 10k test-style calls | $0.5466 | $0.0915 | Практичнее, чем raw token price: учитывает наблюдаемый usage. |
| Usage / image signal | поля image tokens равны нулю или отсутствуют; нужен визуальный smoke test, а не только HTTP status | в usage metadata есть явный сигнал image tokens | Usage metadata может показать сломанный vision path даже при HTTP 200. |
Это намеренно vision API smoke test. Он помогает понять:
image_url через OpenAI-compatible API;Это не полный benchmark для OCR, chart reasoning, handwriting, medical images, dense document extraction или multi-image reasoning. Для таких задач используйте этот тест как первый routing check и добавляйте отдельные domain-specific evaluation.
| Метрика | gemini-2.5-flash-lite | qwen3-vl-flash |
|---|---|---|
| HTTP success | 6/6 | 6/6 |
| Correct recognition | 6/6 | 6/6 |
| No-image replies | 0 | 0 |
| Average latency | 2.618s | 3.819s |
| Median latency | 2.627s | 3.493s |
| Fastest request | 1.302s | 2.529s |
| Slowest request | 4.195s | 5.975s |
| Avg prompt tokens observed | 970.5 | 111.0 |
| Avg completion tokens observed | 5.8 | 9.0 |
| Задача | Модель | Пример ответа | Задержка | Prompt tokens |
|---|---|---|---|---|
logo_python | gemini-2.5-flash-lite | The Python programming language logo. | 2.616s | 1109 |
logo_python | qwen3-vl-flash | Python programming language logo. | 3.217s | 111 |
logo_github | gemini-2.5-flash-lite | The GitHub logo. | 2.638s | 1109 |
logo_github | qwen3-vl-flash | GitHub logo: cat head with ears and whiskers. | 4.243s | 111 |
Для chat apps, customer support tools и пользовательской загрузки изображений важнее всего latency и reliability. Дешёвая модель не является дешёвой, если пользователи повторяют запросы, уходят из продукта или постоянно запускают fallback.
Для массовой классификации важна стоимость успешного изображения. Используйте более дешёвый маршрут, если задача простая и формат ответа можно валидировать. Fallback нужен для empty answers, no-image claims и low-confidence классификаций.
Этот benchmark не доказывает OCR quality. Для invoices, tables, forms, receipts и dense screenshots нужен отдельный тест на реальных документах. Модель, которая распознаёт логотип, не обязательно хорошо извлекает layout.
Agents требуют предсказуемых входных данных. Если маршрут иногда теряет image content при HTTP 200, агент может уверенно принимать неверные решения. Для agent use cases проверяйте answer correctness, usage signals и fail closed при подозрительном image path.
image_url support может означать разные вещи: API принимает URL от клиента, gateway скачивает и конвертирует media, либо upstream provider получает исходный URL. Это влияет на bandwidth, privacy, SSRF controls, latency и billing. Media behavior должен быть частью model routing.
Валидный HTTP response доказывает только то, что API что-то вернул. Он не доказывает, что изображение дошло до модели. В monitoring для Vision API нужно отправлять маленькое deterministic test image, задавать вопрос с известным ответом и проверять как текст ответа, так и usage metadata.
Особенно это важно для маршрутов, где usage показывает отсутствие image tokens или модель отвечает, что изображение не было предоставлено. Это может быть не failure самой модели, а проблема adapter, media-fetch, payload conversion или routing.
В кодовых API endpoints UTM-параметры не добавляются. Для ссылок, которые видит человек, можно использовать UTM, например Crazyrouter Pricing.
Лучший Vision API route зависит от workflow. Для real-time interactions важны корректное распознавание и низкая latency. Для bulk classification — cost per successful image. Для agents и document workflows — reliability, usage signals и fallback design.
Иными словами: не выбирайте vision-модель только по названию. Выбирайте по задаче, failure mode, media path, latency и стоимости полезного результата.
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。