

惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

Google DeepMind News
博客园 - 司徒正美
WordPress大学
WordPress大学
爱范儿
爱范儿
小众软件
小众软件
钛媒体:引领未来商业与生活新知
钛媒体:引领未来商业与生活新知
罗磊的独立博客
博客园_首页
V
V2EX
让小产品的独立变现更简单 - ezindie.com
T
Tailwind CSS Blog
大猫的无限游戏
大猫的无限游戏
The Cloudflare Blog
MyScale Blog
MyScale Blog
IT之家
IT之家
H
Help Net Security
Blog — PlanetScale
Blog — PlanetScale
Microsoft Security Blog
H
Hackread – Cybersecurity News, Data Breaches, AI and More
Recent Announcements
F
Fortinet All Blogs
The GitHub Blog
The GitHub Blog
Y
Y Combinator Blog
人人都是产品经理
人人都是产品经理

我的学习笔记

为什么AI落地实施越来越像一项咨询工作? WorkBuddy、豆包工作、千问办公开战—企业AI的机会反而更清楚了 从钉钉知识库导出文档到 TorchV AIS 大型企业AI落地的隐性共识:知识工程必须先做扎实 企业AI落地,需要的不是一个知识库,而是一台“知识引擎” 做完一次总体设计后,我重新理解了企业级知识库 企业AI知识库的主要应用场景,以及需求变化后带来的新挑战 AI知识引擎的一些常见企业应用场景 跨越业务视角与AI技术视角的鸿沟,Facade模式在企业AI落地中的应用思考 企业级知识库有哪些特殊之处,讲讲安全合规与知识健康 FDE越来越火,你认为这会是2026年AI落地之道吗? AI时代,企业的业务底座正在从数据库变成知识引擎 大多数公司没有为AI做好准备,7个问题自测一下 【万字长文】OpenClaw 火了,企业怎么用才是正确的? 企业AI落地三部曲3:真正的角力—知识构建与知识健康 企业AI落地三部曲2:数字员工军团——从自主智能体到指数级生产力 企业AI落地三部曲:为什么95%的企业AI项目失败 企业AI知识库不止是RAG,更重要的是“知识引擎三大支柱” 企业AI落地不顺,问题可能出在你没搞懂知识库 TorchV创业一年半复盘,我们在努力定义AI企业知识库 DeepSeek火爆现象背后企业可以得到什么实质提升? RAG的2024—随需而变,从狂热到理性 【翻译】RRF — 如何在 RAG 中对多种检索方法的结果进行评分 聊个5分钟的企业AI应用需求变化趋势 介绍TorchV AI的两款应用,做简洁却重要的事情 稀土掘金分享——RAG在企业应用中落地的难点与创新(文字稿) TorchV AI用户手册0609 LLM企业应用落地场景中的问题一览 |LLM |RAG |Agent |TorchV 【翻译】AI Agents Are All You Need 探讨实现AI Agents的三种方式,不同的方式带来不同的客群和场景 |LLM |Agent |RAG
知识加工驱动知识库整个生命周期的三个阶段
yuanwai · 2026-06-25 · via 我的学习笔记

作者:肖玉民,杭州萌嘉网络科技有限公司联合创始人&CTO。团队长期专注于企业 AI 落地与 AI 知识引擎实践,是国内较早探索 RAG 企业应用落地的团队之一。产品 TorchV 已成功服务浪潮信息、微众银行、物产中大国际贸易、物产中大金属、台州银行、适途汽车、中汇税务师事务所等客户。
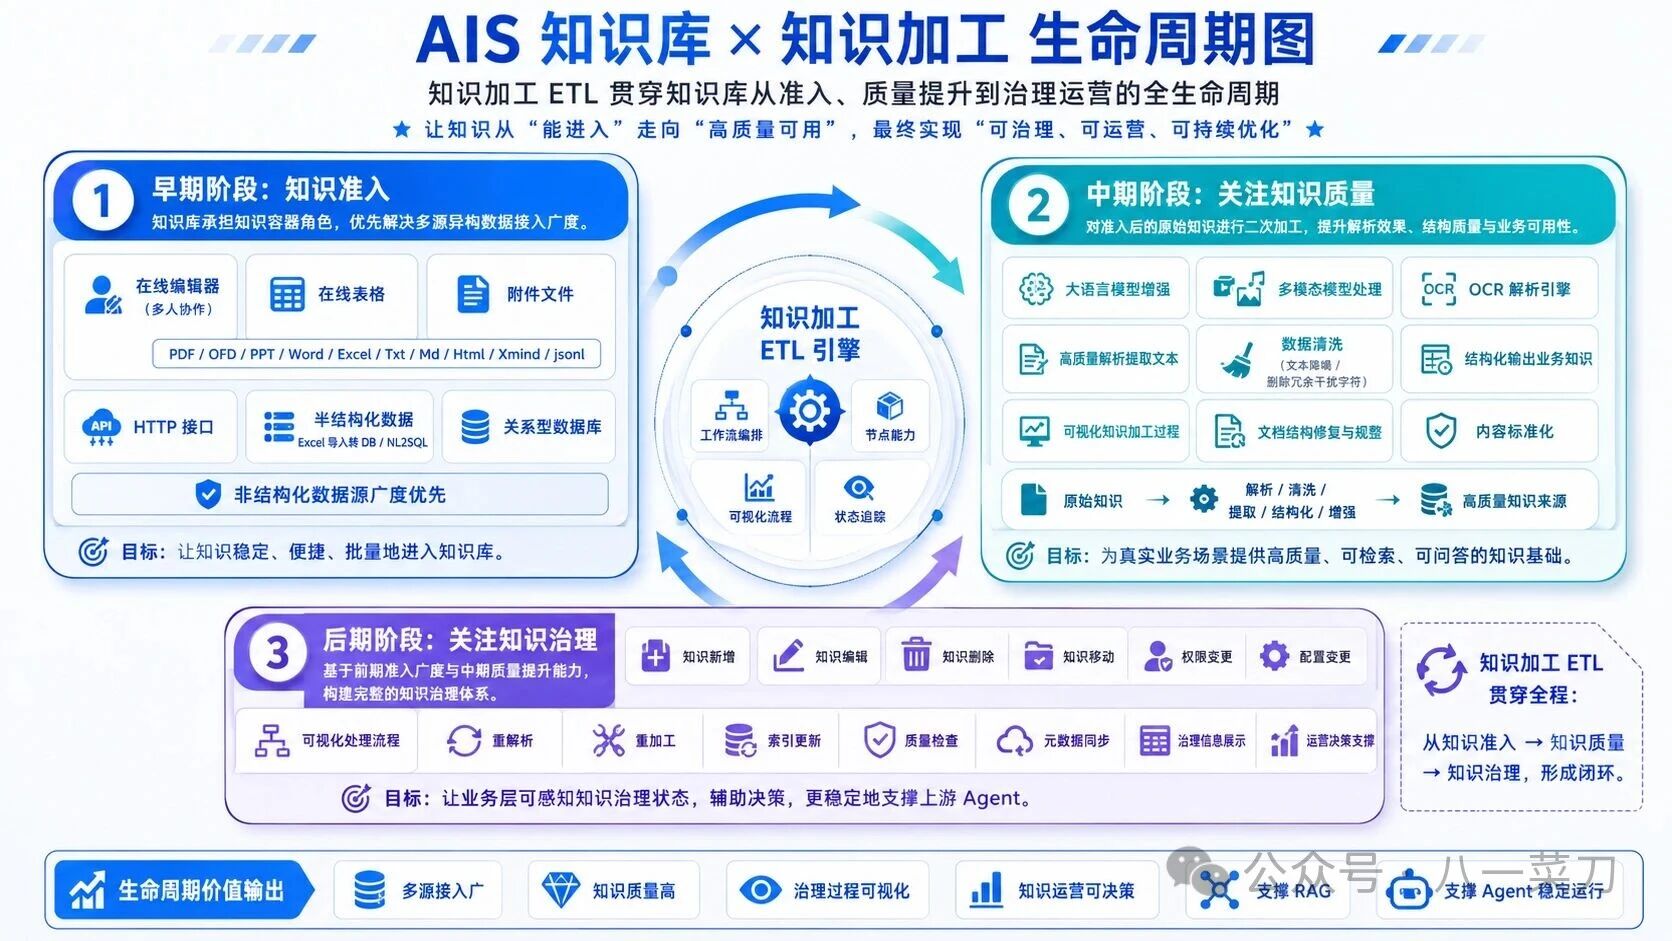
image-20260607142702610

我觉得在知识库里面,以知识加工来驱动知识库三个生命周期的阶段:

1、早期阶段(知识准入)

知识库需要起到容器的作用,对于知识准入来说,知识库系统需要支撑多种数据源的导入处理请求,要求的是对文件的支撑的广度,AIS知识库在这个阶段,提供了非常多的数据类型支撑,包括:在线编辑器(多人协作)、在线表格、附件(支持PDF、OFD、PPT、Word、Excel、Txt、Md、Html、Xmind、jsonl等文件)、HTTP接口等多种数据源的、半结构化数据(Excel导入转DB走Nl2SQL的方式)、关系型数据库。我们是支持的非结构化数据源的广度优先。

2、中期阶段(关注知识质量)

在中期阶段,我们发现了第一阶段的数据,可能无法支撑业务在真实的环境,这里面包括数据的质量不好,文档解析效果不佳,源文件内容结构、排版糟糕等等诸多问题,此时我们关心对于知识,希望借助外部大模型、多模态模型、OCR解析引擎等等先进的AI技术手段,提供对知识的二次加工处理,这里面包括数据的清洗(文本降噪/删除冗余干扰的字符)、结构化输出业务知识、可视化知识加工过程、高质量的解析提取文本等等内容,都是为了提高我们知识准入阶段,为业务做好高质量的知识来源,提供支撑。

3、后期阶段(关注知识治理)

在知识库的后期,我们有了知识准入的广度,也提供了知识质量的一系列标准技术手段方法,此时围绕知识库,就可以构建完整的知识治理体系。真是因为有了前期2个阶段的铺垫工作,后期的知识治理做起来才会得心应手。通过知识加工ETL,能够贯穿整个知识库的生命周期,从知识准入、知识质量、知识治理。三个维度,都可以提供标准的ETL的节点,对知识库的知识的新增、编辑、删除等动作,提供可视化的处理流程,业务层也能关注到知识库的文件治理的信息,做出决策,更好的支撑起上游