







当前,以 Agent 为核心的新一轮技术浪潮正在席卷产业。那么,世界模型的下一个突破在哪?Agent 从 Demo 到工程化还差什么?研发体系不重构,还能撑多久?
6 月 26 日-6 月 27 日,AICon全球人工智能开发与应用大会将在上海举办。本次大会将围绕以上问题,邀请来自腾讯、阿里、快手、华为、飞猪等 50+头部企业的技术负责人、高校与科研机构的一线专家,分享 Agent 在真实生产环境中的落地经验与前瞻思考。深入探讨 Agent 从原型到量产的工程挑战、数据与记忆的基础设施底座、安全可信的落地保障,以及大模型推理优化、智算架构升级等关键命题。
深信服科技副总裁廖俊峰确认出席 “AI 原生数据工程” 专题,发表题为《AI 时代数据面临新的挑战和解决之道》的主题分享。传统数据湖信奉“先存后管”,导致大量非结构化数据处于不可视、不可用的“数据沼泽”状态,面临治理溃败与 ROI 难以证明的困境。AI 时代,Agent 应用对数据的需求从单纯“文件”转向可引用的“上下文”。本次演讲提出从 Data Lake 向 AI 数据湖(Context Lake) 的战略升级。通过构建“湖原生存储底座+统一数据视图(UDV)”,实现非结构化数据的资产化激活,为 AI Pipeline 提供可信的记忆层。
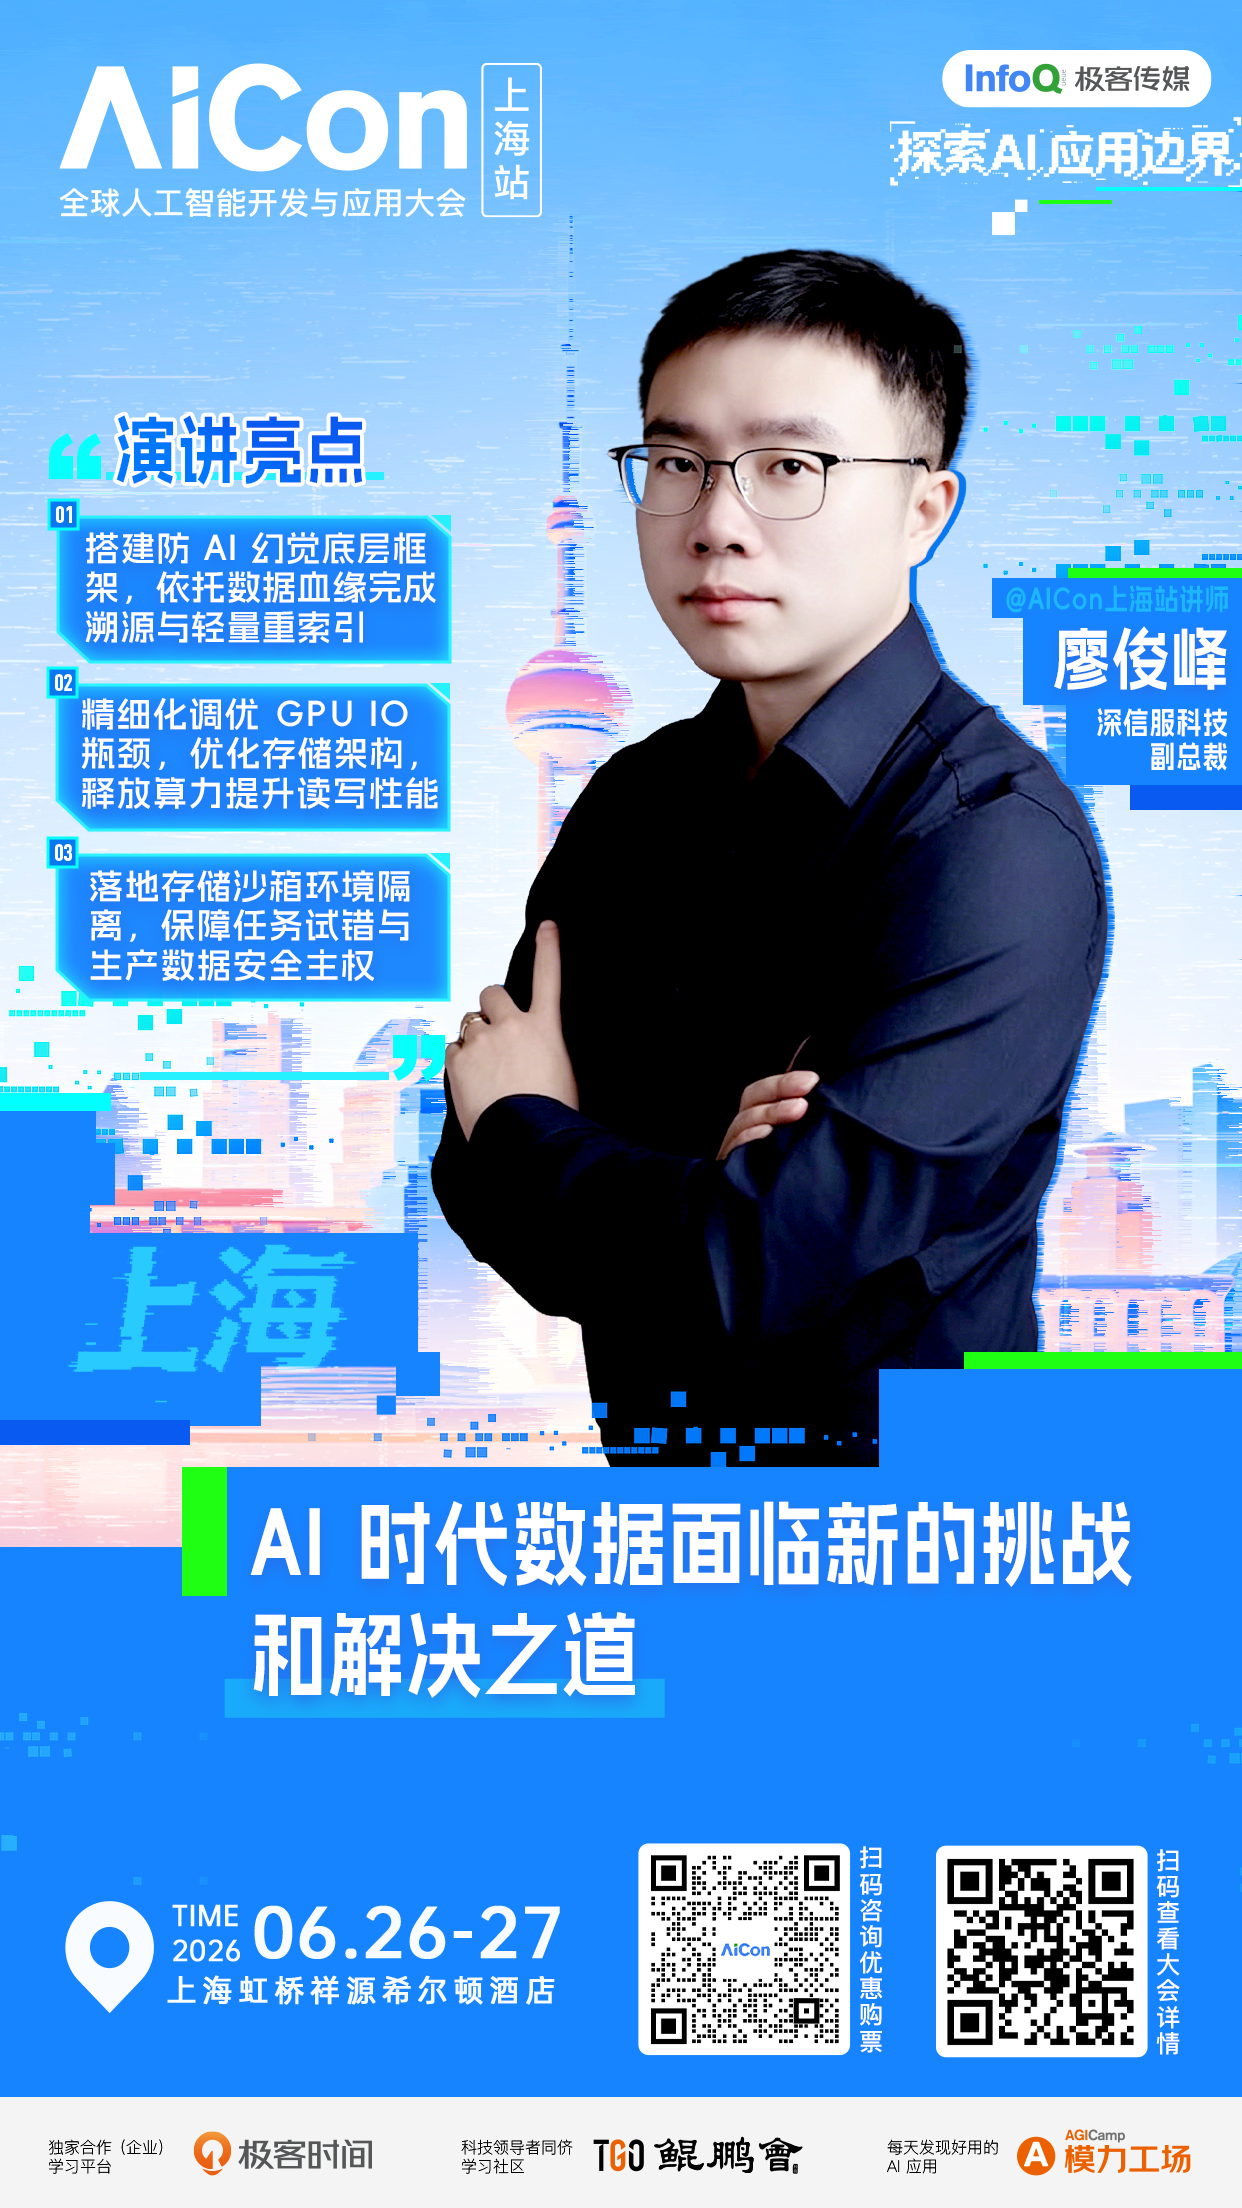
廖俊峰,专家级技术领袖,深信服 AI 及存储业务核心领航人。清华大学计算机科学与技术系博士,深耕高性能计算(HPC)、异构计算及大规模分布式存储领域十余年。曾任职于国家超算中心,相关科研工作入围全球高性能计算领域最高奖项“戈登贝尔奖”(Gordon Bell Prize)决赛前三。他在本次会议的详细演讲内容如下:
演讲提纲:
背景与痛点:为什么传统数据湖在 AI 面前“哑火”了?
从“先存后管”到“数据沼泽”:
核心痛点: 传统数据湖信奉 Schema-on-Read,导致入湖门槛极低,缺乏强制元数据定义
现状: 存储只回答“文件在哪里”,不回答“数据是什么”。企业存了数 PB 数据,却因为找不到、不可信、权限乱,变成了“数据坟场”
AI 应用的消费壁垒:
语义断层: AI 消费的不是原始 Byte,而是 Chunk 和 Embedding。传统存储与向量库之间存在巨大的工程断层
踩坑经验: 很多企业尝试直接在传统对象存储上跑 RAG,结果发现元数据检索极其缓慢(List 操作性能瓶颈),且向量数据与原始文档的血缘关系一旦丢失,AI 产生幻觉时根本无法追溯纠偏
解决方案选型:AI 时代的数据基础设施升级逻辑
从 Data Lake 转向 Context Lake:
目标: 不只是存数据,而是管理“上下文供应链”
核心组件选型:
底座层: 湖原生高性能存储(高性能文件+目录桶对象)
中枢层: 统一数据视图+ 高性能内置 Catalog
执行层: Agent 工作空间沙箱
深度技术细节:解决 AI 工程化落地的“三个关键点”
高性能内置 Catalog:解决“不可解释性”与“重切片难题”
技术原理: 在存储原生层建立“原文 - 分块 - 向量”的深度血缘绑定
独特优势: 支持“标量过滤+向量检索”的混合查询
实战经验: 当 Embedding 模型升级时,利用 Catalog 记录的元数据实现资产重构,避免全量重跑 pipeline,节省 70% 以上的算力浪费
目录桶与 S3 over RDMA:打通 IO 瓶颈
技术细节: 针对 AI 训练中大量小文件、高并发 List 的特征,采用层级目录组织
性能支撑: 支持 S3 over RDMA 与 GDS,大幅降低 GPU 等待 IO 的时延
踩坑经验: 普通对象存储的扁平命名空间在处理百万级分区时,List 操作会引发元数据节点抖动,目录桶通过物理分区隔离彻底解决了这个问题
Agent Workspace Sandbox:让 AI 安全试错
技术细节: 基于快照技术,为 Agent 提供秒级创建的可写隔离空间
核心价值: AI 在沙箱内进行重切片验证、Prompt 调优,不污染生产主线数据
独特设计: 只有经过“审批发布”的产物才能进入主线,解决了 Agent 自动修改数据可能带来的安全性焦虑
实施效果与数据支撑(基于内部测试与规划指标)
治理效率提升: 通过“入湖即治理”模式,非结构化数据的资产化处理时间缩短了 60%
访问性能突破:
- 在分布式训练场景下,目录桶相较于普通对象桶,高并发 List 性能提升了 10 倍以上
- 配合 S3 over RDMA,端到端吞吐量接近物理网速极限。
成本优化:利用温冷向量存储架构,将非活跃向量存储成本降低了 50%(不必全部挤在昂贵的在线向量数据库中)
跨协议互通:同一份数据同时支持 NFS 写入与 S3 读取,减少了 1:1 的数据冗余搬迁
听众收益:
学习如何通过存储原生的高性能 Catalog,在底层建立“原文-分块-向量”的深度血缘
掌握消灭 GPU “IO 饥饿”的极致性能调优方案,深入理解目录桶与传统对象存储扁平命名空间的本质区别,以及 S3 over RDMA/GDS 的落地细节
获取一种“数据平行宇宙”的系统级安全试错思路,了解如何利用快照技术构建 Agent Workspace Sandbox
除此之外,本次大会还策划了端侧 AI、物理与数字空间智能化、世界模型与多模态智能突破、Agent 架构与工程化实践、Agent 安全与可信治理、企业级研发体系重构、AI 原生数据工程、AI 时代的个人提效与组织变革等 14 个专题论坛,届时将有来自不同行业、不同领域、不同企业的 50+资深专家在现场带来前沿技术洞察和一线实践经验。
更多详情可扫码或联系票务经理 13269078023 进行咨询。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。