


惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

宝玉的分享
宝玉的分享
I
InfoQ
B
Blog
Engineering at Meta
Engineering at Meta
Y
Y Combinator Blog
GbyAI
GbyAI
T
The Blog of Author Tim Ferriss
G
Google Developers Blog
量子位
The Cloudflare Blog
OSCHINA 社区最新新闻
OSCHINA 社区最新新闻
小众软件
小众软件
博客园 - 【当耐特】
Hugging Face - Blog
Hugging Face - Blog
阮一峰的网络日志
阮一峰的网络日志
博客园 - 司徒正美
美团技术团队
人人都是产品经理
人人都是产品经理
博客园 - 三生石上(FineUI控件)
酷 壳 – CoolShell
酷 壳 – CoolShell
大猫的无限游戏
大猫的无限游戏
罗磊的独立博客
博客园 - 聂微东
IT之家
IT之家

InfoQ - 促进软件开发领域知识与创新的传播

Meta 收购 Manus 这事儿泡汤了 5.5万 Star 开源项目 Ghostty 被迫出走,GitHub 正在终结一代技术人的乌托邦 Slack 长时运行多智能体系统的上下文管理方案 从 T+1 到分钟级:金城银行基于 Apache Doris 构建高可靠、强一致的实时数据平台 谷歌云推出 Agents CLI,简化 AI 智能体开发全流程 Claude官方击穿高薪、高学历的安全防线!Anthropic点名10大高危职业,但有群人暂时稳了 亚马逊云科技终止 WorkMail 服务,并将 App Runner 转入维护模式 OPPO小布记忆:全模态碎片化内容的理解与智能整理实践|AICon上海 模力工场038周AI应用周榜:工具在消失,工作流在出现 Akamai CEO Tom Leighton:Agent 时代来临,云基础设施正从“中心化”转向“分布式边缘” 日均数百亿入库背后:从“人肉调度”到K8s弹性架构,度小满金融基于OceanBase重构入库架构实践 百度文库网盘发布GenFlow 4.0:月活用户超1亿,要把网盘变成全端AI工作台 Altman 投的 Agent 终端 Warp 开源了!斩获3.5万star 哪些客户需要拒, 敢让龙虾决定吗?_AI&大模型_InfoQ 中文站_InfoQ精选视频 从开发到生产:为什么越来越多的机器学习团队纷纷迁移到 Snowflake | BUILD 2025_AI&大模型_王玮_InfoQ精选视频 探索多智能体工作流:LangGraph Snowflake Cortex AI | BUILD 2025_AI&大模型_王玮_InfoQ精选视频 腾讯云分布式缓存数据库:AI Agent - 从提示词工程到 Harness 工程 | 腾讯云数据库 DBTalk_腾讯_凌敏_InfoQ精选视频 基于 Streamlit 为 CSV 数据构建分析智能体 | BUILD 2025_AI&大模型_王玮_InfoQ精选视频 AI 智能体:告别文档缺漏 | BUILD 2025_AI&大模型_王玮_InfoQ精选视频 构建 AI 驱动的数据管道:深度探讨 Snowflake Openflow 与非结构化数据 | BUILD 2025_AI&大模型_王玮_InfoQ精选视频 云端太贵、本地不够聪明,英特尔押注“端云混合AI”:智能体PC会替人完成工作 不到10%的存储投入,可能拖垮90%的GPU投资!IBM把AI Agent塞进存储系统,算清企业最容易忽略的一笔账 Snowpark 上手实战 | BUILD 2025_大数据_王玮_InfoQ精选视频 ClickHouse + Langfuse,构建 Agent 可观测基石 腾讯云分布式缓存数据库:Cluster Proxy 共享连接架构深度解析 | 腾讯云数据库 DBTalk_腾讯_凌敏_InfoQ精选视频 AI 写代码太烧钱了:Copilot、Claude 一起涨价,不如把程序员请回来? 英特尔发布至强600系列工作站处理器与锐炫Pro B70 GPU,全新AI工作站来了 腾讯云分布式缓存数据库:从 Redis 到 Valkey - 开源社区如何快速创新 | 腾讯云数据库 DBTalk_腾讯_凌敏_InfoQ精选视频 印奇这次要“从0重做”智驾模型!首谈阶跃和千里双公司布局:中国AI商业闭环要靠车跑出来 从Cursor返聘归来,90后华裔女高管带Claude开启日更模式:token成本比工程师工资低多了!
苹果推出 Core AI 框架,为自研芯片优化端侧生成式 AI
作者:Sergio De Simone明知山 · 2026-06-28 · via InfoQ - 促进软件开发领域知识与创新的传播

在 2026 年 WWDC 大会上,苹果发布了 Core AI 框架,Core ML 的官方继任者。该框架旨在让开发者能够完全在设备本地运行大语言模型和生成式 AI,同时支持自定义转换后的 PyTorch 模型和预优化的开源模型。

苹果表示,新的 Core AI 框架提供了一个统一的架构,可在 iPhone、iPad、Mac 以及 Apple Vision Pro 上部署小至仅 30 亿参数的视觉模型、大至最高 700 亿参数的推理模型)

Core AI 是 Apple Intelligence 的底层技术,随着苹果下一代操作系统与工具链发布,开发者将可使用该框架打造苹果所称的 “自定义智能功能”。Core AI 只能在 Apple Silicon 上运行,确保用户数据隐私、零服务器依赖,也不会产生按词元计费的云端开销。
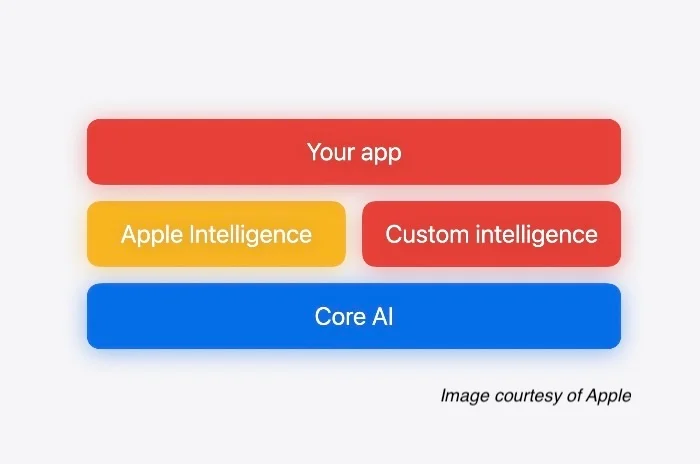
Core AI 的关键能力包括:统一硬件访问,工作负载可使用单个 API 在 CPU、GPU 和神经网络引擎上无缝运行;内存安全的 Swift API 可实现零拷贝数据路径和对推理内存的精细控制;提前(AOT)编译技术,将运算预处理工作转移至设备外部完成,实现近乎瞬时的模型加载速度。

如前所述,你可以使用 Core AI PyTorch 将 PyTorch 模型转换为 Core AI 模型。最简单的方法是将 PyTorch 导出为 torch.export.ExportedProgram,然后使用 TorchConverter().add_exported_program(ep).to_coreai() 将其转换为 CoreAI 的 AIProgram。

或者,你可以使用库提供的内置复合算子(如注意力机制、RoPE 嵌入、RMSNorm 和 gather-matmul)基于现有 PyTorch 模型构建新的 Core AI 模型,注册自定义降阶函数以便将新的 PyTorch 算子映射到 Core AI IR,甚至创建自定义 Metal 内核以实现更底层的优化。

转换 PyTorch 模型时,一个关键步骤是针对 Apple 硬件进行压缩部署。该过程应用了量化调色板化等优化技术,这些技术默认与 Core AI 运行时的执行模式对齐,确保高效的设备端性能。

模型压缩有助于减少模型的内存占用(包括磁盘大小和运行时占用)、降低推理延迟、降低功耗,或同时实现以上全部优化。

运行 AIModel 有一个关键特性:模型会自动特化当前硬件和操作系统版本,这个过程在模型首次加载到模型缓存时完成。因此,首次使用模型的耗时可能比后续长一些。开发者可以通过自定义 SpecializationOptions、访问 AICacheModel 来检查模型是否已可用或删除已缓存的模型,甚至可以在应用组之间共享模型缓存。

随着 Core AI 的推出,苹果为其操作系统上的 ML/AI 提供了三种不同的运行方式:Core ML、Core AI 和 MLX Swift。根据 Hacker News 上的开发者讨论来看,苹果的使用建议是:将 Core ML 用于“经典的非神经网络 ML”,如决策树或表格特征工程;将 Core AI 用于神经网络和 Transformer;将 MLX 用于处理自定义模型权重——尽管可能性能较低社区反馈还指出,虽然 Core AI “让集成高性能 LLM 变得更加容易”,但其长期价值将取决于“官方 Core AI/社区的未来发展”。

查看英文原文:https://www.infoq.com/news/2026/06/apple-core-ai-wwdc/