惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

MongoDB | Blog
MongoDB | Blog
大猫的无限游戏
大猫的无限游戏
H
Help Net Security
V
Visual Studio Blog
G
Google Developers Blog
Blog — PlanetScale
Blog — PlanetScale
Last Week in AI
Last Week in AI
C
Check Point Blog
D
Docker
M
MIT News - Artificial intelligence
P
Proofpoint News Feed
博客园 - 叶小钗
博客园 - 聂微东
The Cloudflare Blog
云风的 BLOG
云风的 BLOG
Martin Fowler
Martin Fowler
OSCHINA 社区最新新闻
OSCHINA 社区最新新闻
酷 壳 – CoolShell
酷 壳 – CoolShell
MyScale Blog
MyScale Blog
WordPress大学
WordPress大学
Engineering at Meta
Engineering at Meta
腾讯CDC
S
SegmentFault 最新的问题
博客园 - 【当耐特】

BMPI

构建自己的信息简报 2.0 我的退休计划:把无期变成有期 从情绪化交易到系统化投资 策引2025 实盘大考:当算法跑赢人性 三十五 我的AI投资助手 我的投资之路 BMPI周记008:设止损而勇试错 BMPI周记007:经济下行 BMPI周记006:时光机 BMPI周记005:直播小完结 BMPI周记004:不要做空 BMPI周记003:十年前的今天 BMPI周记002:交易之难 BMPI周记001:开始直播 对交易的思考 AI驱动开发:从Prompt到Product(直播) 策引全球投资组合:A股1号 策引全球投资组合:A股2号 策引全球投资组合:A股3号 策引全球投资组合:A股全球 策引全球投资组合:加密币1号 策引全球投资组合:加密币2号 策引全球投资组合:美股1号 策引全球投资组合:美股2号 策引全球投资组合:美股3号 策引全球投资组合:美股4号 策引全球投资组合:美股全球 全球投资开户完全指南:A股与美股篇 我的2023
使用TF-IDF算法计算网站页面相似度分布(Python)
马大伟 · 2020-01-18 · via BMPI

如果你的网站网页重复或者相似页面过多将会影响你网站的排名,那么如何计算网站内网页的相似度分布?

本文教你通过开发Python脚本使用TF-IDF算法计算网站全站页面相似度分布并可视化展示出来。

0. TF-IDF

TF-IDF(英语:term frequency–inverse document frequency)是一种用于信息检索与文本挖掘的常用加权技术。TF-IDF是一种统计方法,用以评估一字词对于一个文件集或一个语料库中的其中一份文件的重要程度。字词的重要性随着它在文件中出现的次数成正比增加,但同时会随着它在语料库中出现的频率成反比下降。TF-IDF加权的各种形式常被搜索引擎应用,作为文件与用户查询之间相关程度的度量或评级。除了TF-IDF以外,互联网上的搜索引擎还会使用基于链接分析的评级方法,以确定文件在搜索结果中出现的顺序。1

1. 计算原理

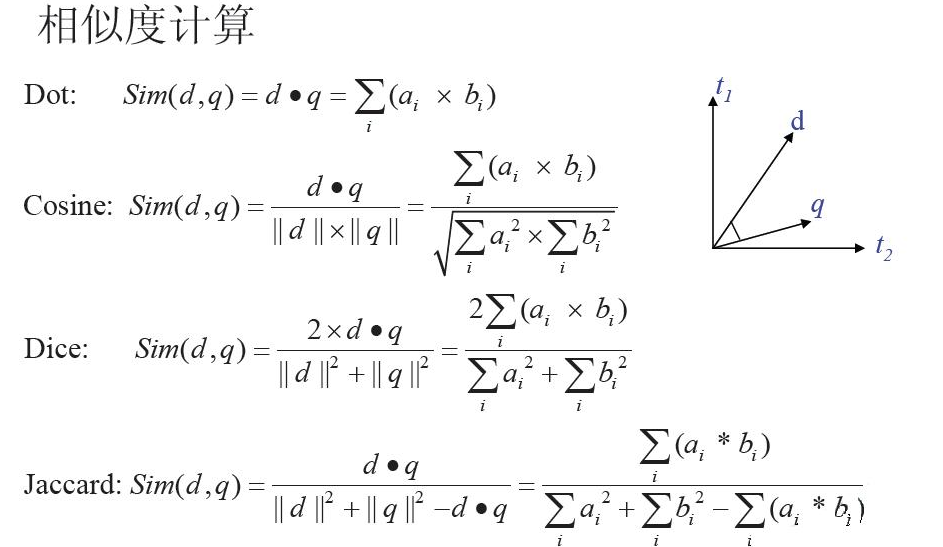
通过sitemap获取全站公开url,使用chrome无头浏览器抓取每个页面截图及其html源文件,然后抽取html中的可视文本,拿到每个页面文本后将页面内容分词后抽象为一个向量,互相计算每个页面向量之间的相似度(夹角),使用的算法为TF-IDF算法,如下:

假设现在有一个包含 1000 个文档的文档集合,其中包括文档:[经济,发展,新常态,研究,……],该文档总词汇数是 100,“经济”这个词汇出现了 4 次,则“经济”一词的词频(TF)为 4/100 = 0.04,如果在 1000 个文档中有 100 个文档出现过“经济”一词,则逆向文档频率(IDF)为 log(1000/100) = 1,那么在 TF-IDF 矩阵中,该文档中“经济”一词对应的权数应为 0.04*1=0.04。
2. 计算代码

点击图片查看源代码

点击图片查看源代码

3. 计算结果

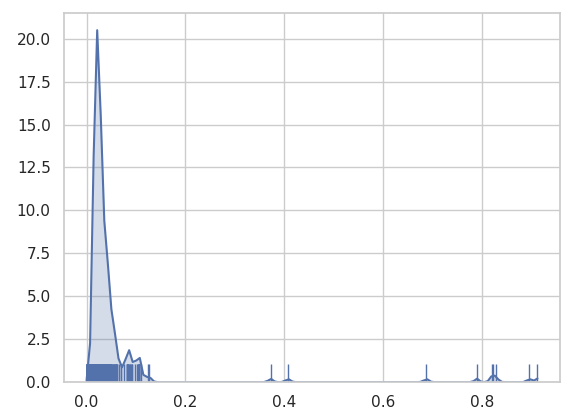
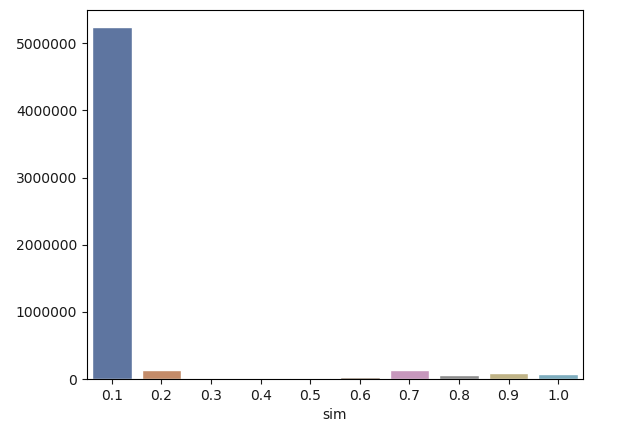
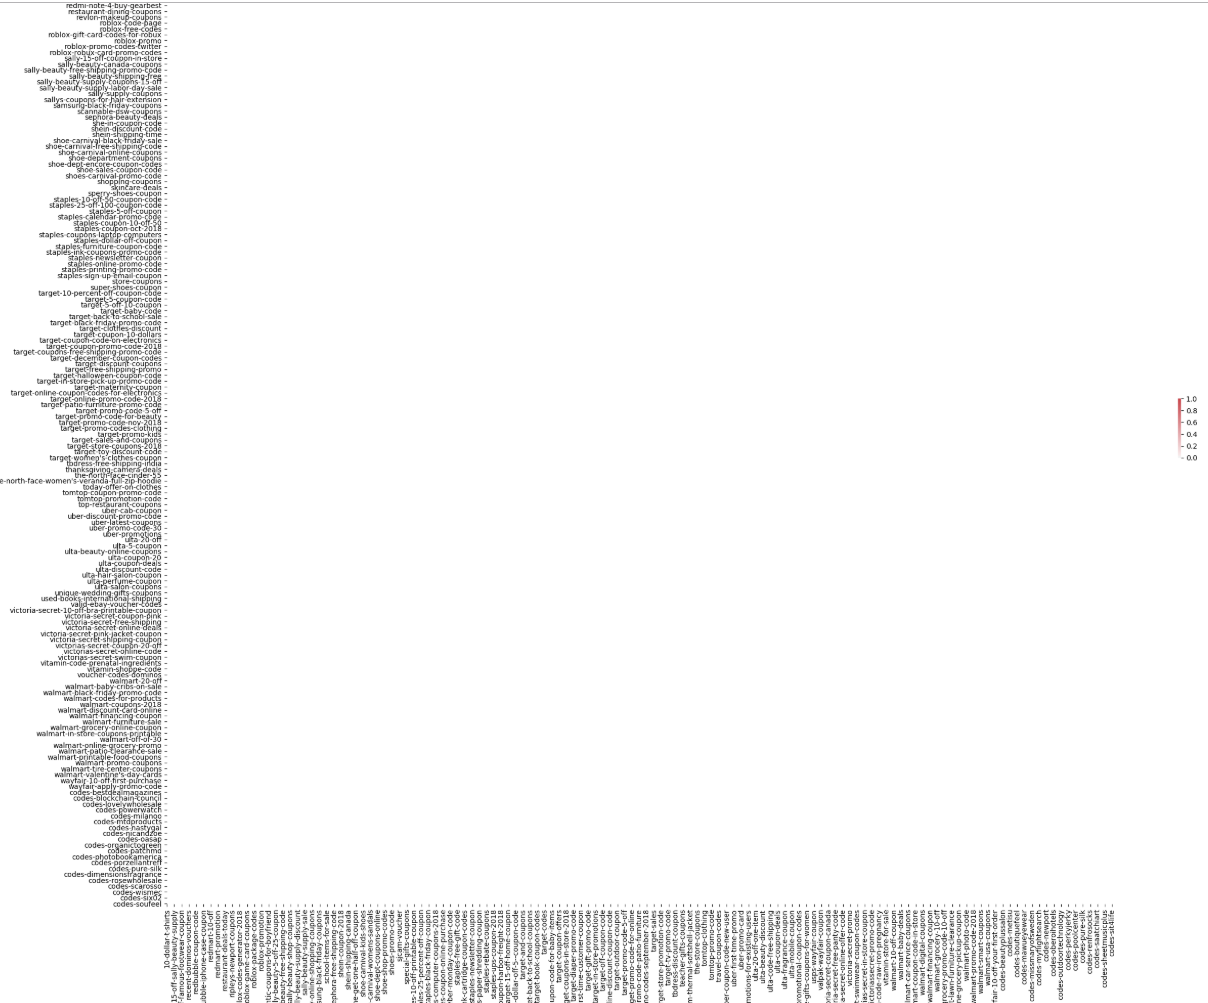
从上图可以看出全站相似度并不高,大部分页面相似分布在10%-20%之间,处于可接受范围。如果相似页面多,则热力图可能会出现如下情况:
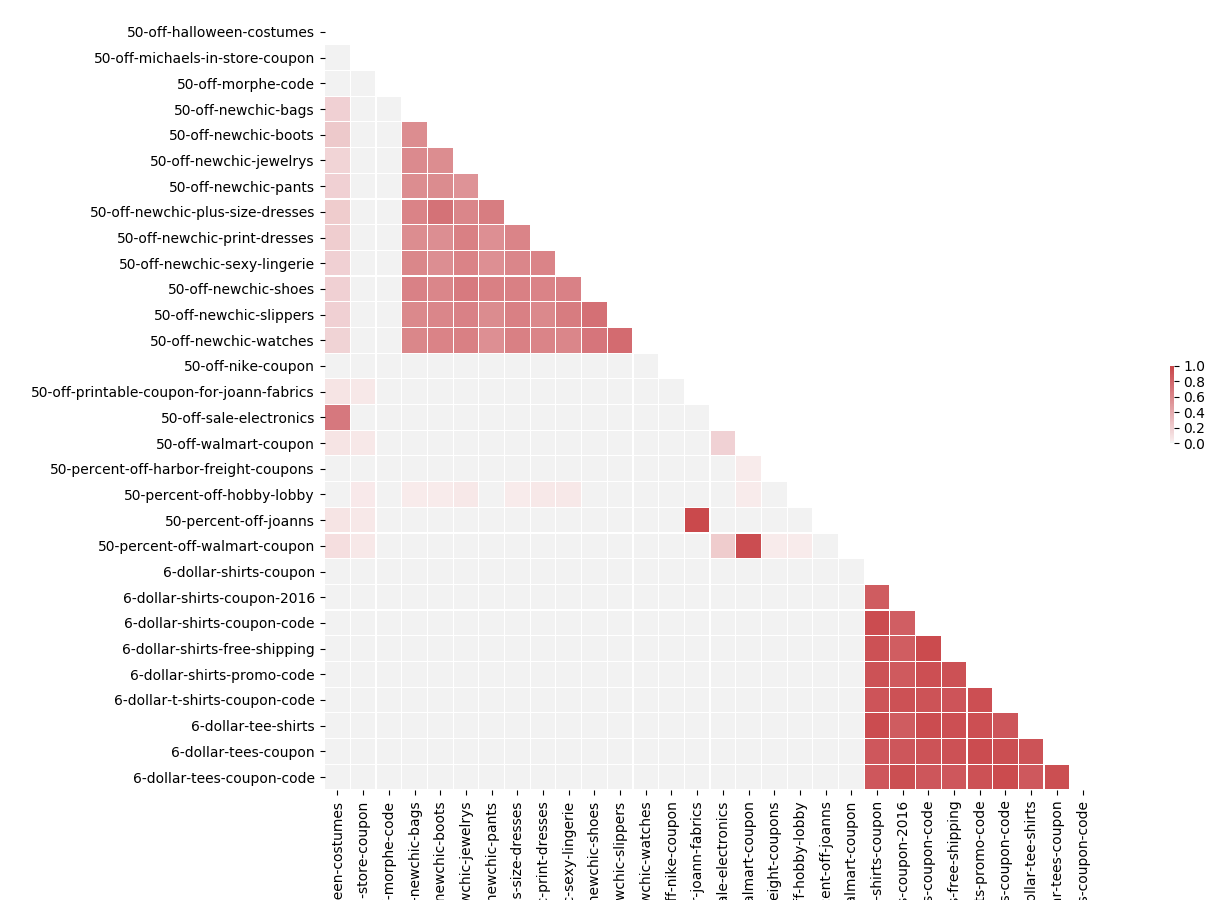
红色区域表示这些相关页面相似度极高。

References


  1. https://zh.wikipedia.org/wiki/Tf-idf ↩︎