








如果使用Chrome浏览器访问XML地址,返回报错信息:
Input is not proper UTF-8, indicate encoding !
Bytes: 0x08 0xE6 0xBA 0x90
这是由于返回回来的数据存在ASCII控制字符。XML规范不支持这部分控制字符。
这个报错提示是Chrome浏览器生成的报错,不是服务器端返回的报错。
关于该报错的详细信息请参阅:《PRB: Error Message When an XML Document Contains Low-Order ASCII Characters》。
使用正则替换这部分控制字符\x00-\x1F\x7F或替换不可打印字符\x00-\x1F\x7F-\x9F。
JavaScript:
'string'.replace(/[\x00-\x1F\x7F]/g, '')
控制字符是 ASCII 范围0-31中特殊的不可见字符。正常情况下这些字符很少用在 JavaScript 中,包含这些字符的正则表达式很可能编写有误,因此部分ESLint规则可能将其视为错误,可将该行设置no-control-regex: "off"。
JAVA:
Regex.Replace(xmlStr, "[\x00-\x1F\x7F]","");
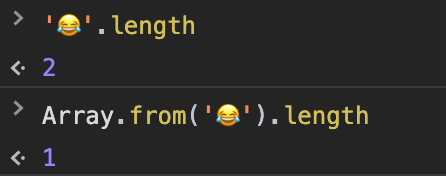
刚开始遇到这个问题,以为类似MySQL存储字符宽度超过3个字节的UTF8编码的问题。尝试过删除文本中的Emoji表情,但是仍然没能解决问题。但是在探索过程中发现了JS过滤Emoji表情的准确方法。
JavaScript引擎把utf-16的4字节字符,拆分成两个ucs-2的2字节字符。因此4字节utf-16在js中被用两个字符来表示,高位范围为0xD800 - 0xDBFF,低位范围为0xDC00 - 0xDFFF。
因此,检测包括Emoji表情在内的utf-16字符可以使用正则表达式/[\ud800-\udbff][\udc00-\udfff]/g进行过滤,即过滤utf8非3字节编码的字符串。
H = char.charCodeAt(0) // 取出高位
L = char.charCodeAt(1) // 取出低位
判断包含Emoji表情的字符串长度,需要使用
Array.from(string).length
来代替string.length。
本站RSS订阅地址:https://www.wyr.me/rss.xml。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。