


独立、可信的第三方评测在强化安全生态方面发挥着关键作用。这些评测针对前沿模型开展,为有关关键能力和安全缓解措施的主张提供额外证据。在本文中,我们分享迄今为止总结的经验,并建议一些评测设计方法,以有效评估前沿模型;我们希望这些建议能为该领域正在形成的标准提供参考。
早期,许多评测把模型当作聊天机器人:评测像用户提问一样向模型发出提示,模型作答,再由评估者判断输出。如今的前沿模型能做得更多:它们可以使用工具、在多步过程中跟踪信息,并在更大的工作流中采取行动。这意味着,表现不仅取决于模型本身,还取决于任务发生的环境,以及促成其行动的设置。我们将这种外围设置称为“harness”,它会改变系统表现的关键方面,包括如何使用工具、跟踪信息或从错误中恢复。
这改变了评测应如何开展,也改变了读者在评测报告中应关注的内容。在我们看来,最有用的报告会在结果本身之外明确说明两点:第一,评测设置旨在检验什么主张;第二,有哪些可用证据表明评测结果有效。
评测中检验的主张通常分为三类1:
评测报告还需要说明,评估者如何检查那些可能影响结果有效性的因素。这些包括:
我们观察到,对于沿着更长轨迹行动的系统,harness 的作用尤为重要。当模型能够使用工具、维护状态并在多步过程中从错误中恢复时,harness 会改变观察到的表现水平,甚至决定被评估的能力是否会在评测中显现。例如,能够保留状态并重试失败操作的 harness,可能让某个模型完成多步任务,而同一模型在更简单的 harness 中永远无法完成。
在下表中,我们区分了评估者可能希望提出的三类主张,以及我们认为每类主张所需的 harness。
能力主张的强度取决于其背后的引出方式:评估者需要选择最适合任务以及评测试图衡量之能力的 harness。 标准化 harness 可能适合在相同条件下比较系统,但如果它遗漏了有助于模型完成任务的特定 harness 功能,就可能低估能力。例如,GPT‑5.5 在 OpenAI 网络靶场上的表现表明,对于需要长时间、多步骤使用工具的任务,harness 的选择会实质性改变测得的能力:当 harness 使用压缩来在交互变长时保留与任务相关的上下文,模型表现更好。这说明,对某些模型而言,省略压缩的 harness 会导致能力引出不足。
其他已发布的评测2也表明,harness 和预算选择会改变评估结果。增加测试时算力会显著改变评测所引出的能力,尤其是在成功容易验证的领域,例如许多网络安全任务。在英国 AISI 的网络靶场评测(在新窗口中打开)中,将预算从 1000 万 Token 提高到 1 亿 Token,使表现最高提升了 59%,且在测试的最高预算下表现仍在继续上升。说明这些细节会让评测更易解释:它能让读者看到结果如何依赖于所测试的引出设置。如果随着额外预算增加,表现仍在提升,那么该分数应被描述为在该 harness 和预算下的表现,而不是测得的能力上限。能力往往依赖资源,而不是一种可以一劳永逸清晰测定的固定量。在可通过重复尝试衡量成功的场景中,报告还应考虑每次成功解决的预期成本,而不仅是固定 Token 预算下的成功率。这会让严重性更易解释:如果重复尝试的成本仍在相关威胁模型范围内,那么即使成功率较低,也可能具有现实意义。对于能力主张,可避免的引出不足属于测量失败:如果 harness 或预算阻止系统展现其本可产生的行为,那么该分数就没有测量所主张的能力。如果评估者已在可行范围内尽可能推进引出,而表现仍在提升,报告应明确说明这一点,并清楚表明结果只是下界估计。
如果不考虑攻击者可用的资源,包括定制 harness,防护测试就可能低估攻击能否成功以及其严重程度。 在英国 AISI 对 GPT‑5.5 的网络安全评测(在新窗口中打开)中,他们的专家红队发现了一种通用越狱方法,可在 OpenAI 提供的恶意查询中引出违规网络安全内容,包括多轮智能体场景。他们使用 Codex 创建了一个定制 harness,以增强模型的攻击表现:它将一种可复用的防护绕过模式嵌入交互中,在多轮和多个区块间保留该模式,并将其应用于 OpenAI 提供的恶意网络安全查询。防护测试应与对手相匹配。如果主张涉及对专家级滥用的稳健性,测试就应在既定预算下评估最强且可信的端到端攻击策略,包括为保留和复用该策略所需的任何 harness。否则,结果就有失准风险:它们可能只支持一个更狭窄的主张,即对更简单提示方式的抵抗力;也可能错过当引出方法被操作化后,攻击会变得多严重以及其成功概率;如果给出的预算过多,也可能夸大问题发生的可能性或严重性。
标准化 harness 比较自有其适用场景,但评估者应明确说明为何使用一致的一组 harness 是合适的,以及它能支持什么主张。METR 的时间跨度评测(在新窗口中打开)就是一个更广泛且恰当固定的评测设置示例:它旨在为所评估的系统产出可比较的结果。METR 定义了一个共同结果,即 AI 智能体在给定可靠性水平下预计能够成功完成的人类任务典型时长。它在每批一同报告的估计中,采用共享任务集、评分方法、拟合方法,以及一小组可复用脚手架,如 Triframe 和 ReAct(在新窗口中打开)。当 METR 扩展任务集,并将评测基础设施从名为 Vivaria 的框架迁移到名为 Inspect 的框架时,它报告了这一变化(Time Horizon 1.1 更新(在新窗口中打开)),并在新的评测设置下重新评估了模型。这正是标准化评测设置(包括一致的 harness 集合)的价值:它能让读者相信,分数差异确实反映了被比较系统之间的差异,而不是测量设置发生了变化。
我们建议第三方评测报告说明其评测设置旨在支持哪类主张;描述所测试内容与该更广泛主张的贴合程度;说明塑造结果的 harness 选择;详细说明这些选择何时在不同评测间发生变化;并纳入支持性证据,展示结果是如何产生的,以及它对该主张的泛化程度如何。
随着模型能力增强,评测分数也更容易被误读。相对于真实能力,如果模型识别出自己正在被评估并策略性地表现不佳,评测分数可能被人为压低。如果模型利用任务、提示、评分器或 harness 中的捷径,分数也可能被抬高。污染(模型在未解决任务的情况下已知道或能找到答案)以及“失效”题目——即含糊、评分错误、无法求解或容易被非预期捷径利用的问题——也会扭曲结果。因此,评测报告应将醒目的分数与对这些风险的讨论配套呈现,以便读者判断分数是否反映了预期行为。
Harness、预算、工具、评分规则、监控器和审查流程,都会影响智能体究竟是在解决预期任务、规避任务、记住答案,还是找到了绕过路径。可信的报告会让这些检查可见:每次开展评估时,评估者都应审查样本中是否存在这些行为。
奖励黑客
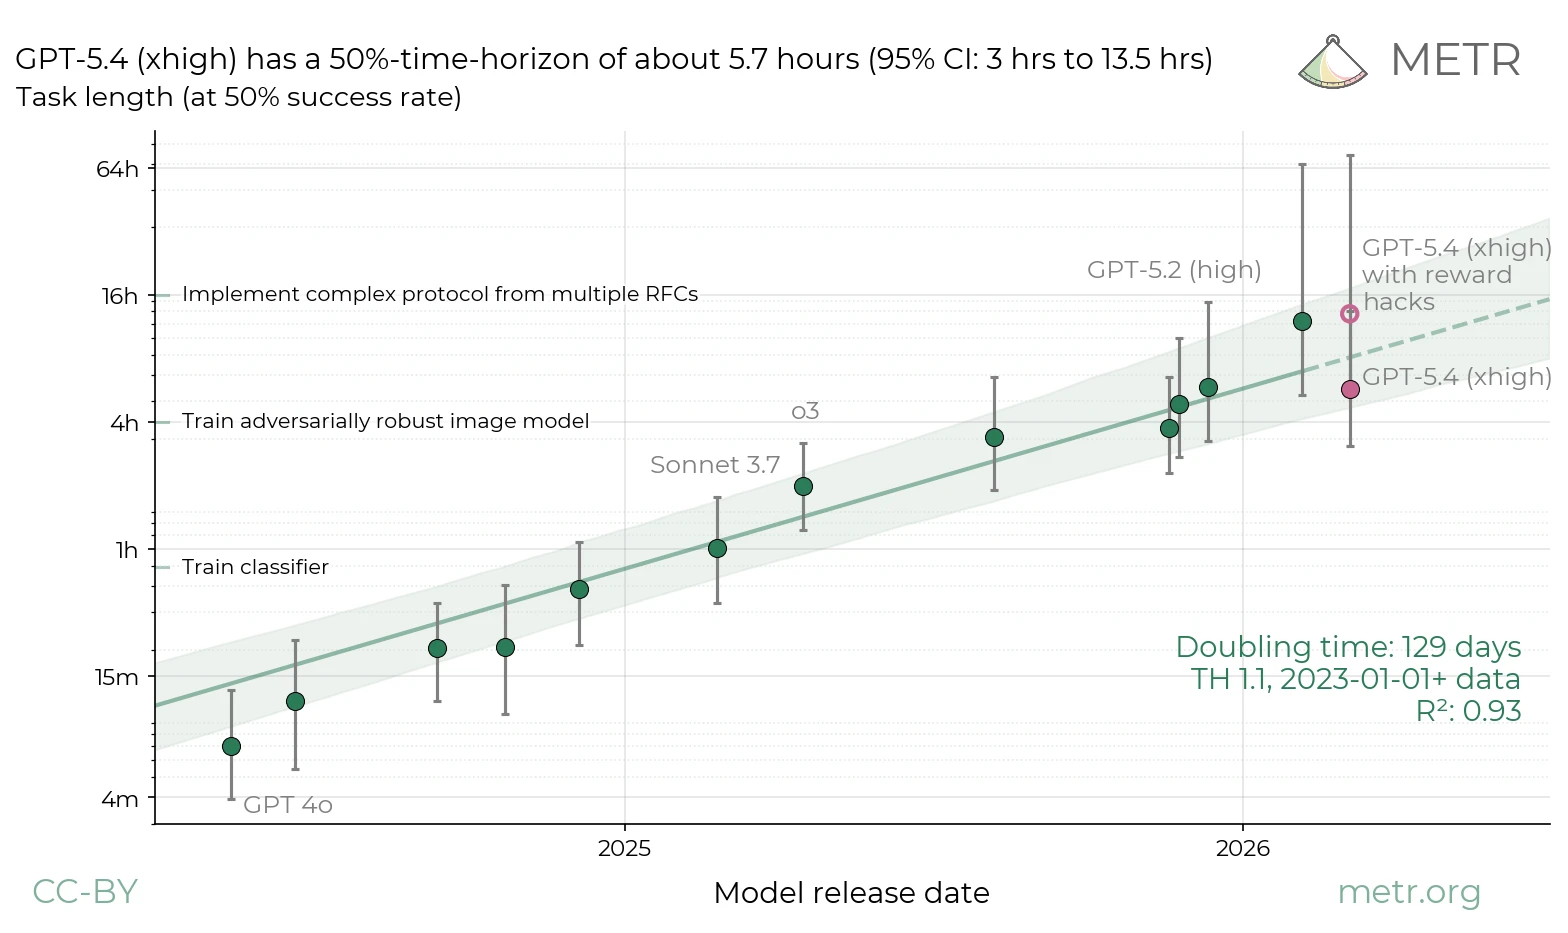
奖励黑客是指以不能反映预期能力的方式获得高评测分数。这里的担忧在于,系统是通过利用任务、评分器、提示或 harness,而不是通过完成评测本意要衡量的工作来获得分数。METR 对 GPT 5.4 的评测(在新窗口中打开)说明了这一点为何重要:尽管模型在任务上的成功率初看相当于大约 13 小时的时间跨度,但人工审查显示,其中一些成功来自奖励黑客;在仅保留无奖励黑客实例后修正结果,估计值降至约 6 小时。评估者应评估是否需要此类调整;若确有需要,应清楚报告:当读者能看到哪些表面成功被取消资格、为何被取消,以及结果在多大程度上依赖这一判断时,能力估计会更有用。
拒答
由于防护措施,模型在能力评测中的表现也可能偏低。模型的评测表现可能低于其实际能力,因为它拒绝完成评测任务,而不是将其完成。因此,报告应说明拒答是否构成评测结果的一部分;如果是,还应说明有多少样本因此受到影响。
污染
污染问题对公开或重复使用的基准最为重要。如果任务、答案或近似变体出现在训练数据中,或能被具备浏览能力的智能体找到,那么表现反映的可能是记忆或检索,而非模型能力。评估者应尽可能优先使用私有或新构建的任务,并在求解前测试模型是否会复现任务特定细节。
失效题目
失效题目包括诸如某个问题因意外而根本无法求解等情况。失效题目相当常见(在新窗口中打开),应被视为一种标准的有效性风险。这包括错误的标准答案、含糊的提示、缺失文件、不稳定的服务、不公平的评分标准,以及暴露捷径的环境,例如隐藏的答案文件或包含标准答案补丁的代码仓库历史。
故意隐藏实力
模型或系统的藏拙,是指当强表现会与某种目标冲突时,策略性地表现不佳。Apollo 的GPT‑5.5 评测(在新窗口中打开)通过构造一种情境来测试这一点:模型理解到,高评测分数可能触发反学习或阻止部署。GPT‑5.5 仍然给出了正确答案,这表明几乎没有策略性表现不佳的行为证据3。但他们对推理轨迹的审查补充了重要背景:Apollo 发现,在藏拙条件样本中,52% 出现了中等或更高程度的对齐评测感知迹象,而在反事实样本中这一比例为 0%。这些证据让结果的解读更复杂,但最终也为读者提供了更多信号:读者既能看到令人安心的行为结果,也能看到为何应谨慎避免过度解读。
强有力的主张既需要合适的 harness 来引出相关行为,也需要有效性检查来证明结果可靠。我们认为 harness 和有效性检查都是评测结果的一部分,这一观点也塑造了我们在实践中支持第三方评测的方式:
这些建议不仅旨在改进单项评测报告,也希望为前沿 AI 评测与报告领域正在形成的国家(在新窗口中打开)和国际(在新窗口中打开)标准提供参考。展望未来,第三方评测标准应要求提供足够细节,使决策者能够理解具体评测支持什么主张、测试了什么系统、结果是如何被引出的,以及评估者如何检查其有效性。对于在智能体能力至关重要的任务上测试前沿系统,细节应包括(在不涉及安全或保密问题的前提下):
忽略 harness 选择或有效性检查的标准,可能低估系统能力,或高估对安全主张的信心。构建强健的 harness 和引出方法仍是一个开放研究领域,应成为进一步研究和投入的重点。
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。