惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

博客园_首页
博客园 - Franky
大猫的无限游戏
大猫的无限游戏
博客园 - 三生石上(FineUI控件)
量子位
博客园 - 聂微东
OSCHINA 社区最新新闻
OSCHINA 社区最新新闻
S
SegmentFault 最新的问题
Apple Machine Learning Research
爱范儿
爱范儿
V
Visual Studio Blog
雷峰网
雷峰网
T
Tailwind CSS Blog
宝玉的分享
宝玉的分享
Blog — PlanetScale
Blog — PlanetScale
有赞技术团队
有赞技术团队
博客园 - 叶小钗
Microsoft Azure Blog
T
The Blog of Author Tim Ferriss
U
Unit 42
钛媒体:引领未来商业与生活新知
钛媒体:引领未来商业与生活新知
小众软件
小众软件
阮一峰的网络日志
阮一峰的网络日志
Y
Y Combinator Blog

Nicksxs's Blog

Pi Agent 源码解析(一):从调试环境到双层主循环 6GB显存能跑35B MoE吗:FreeToken极限配置、性能压榨与实操教程 聊聊 Java 的类加载机制一 从ASM到ByteKit再到Arthas:一条Java字节码增强链路 8GB显存如何跑35B:深入理解FreeToken的专家缓存与CPU-GPU协同 让chatgpt来给我讲解下deepseek harness的插件体系 来学习下pi agent的原理 如何在命令行中输出进度条 联想 G400 安装 Windows 7 折腾记录 记一个gitea推送失败的问题 学一下chrome的扩展开发 看下chrome的内置模型 从 app.test 到小锁:valet 本地 HTTPS 的完整链路 浅析一下jpeg图片格式及其来源 关于github拉取下载加速的另一个方式 关于适合什么模型,推荐下llmfit 看看目前本地能跑什么模型,使用llama.cpp 最近使用vibe coding的一些感悟 使用php的inotify扩展来监听文件变更 一些设计模式的记忆点 使用xiaomi mimo大模型api运行Hermes Agent 结合Obsidian的cli的一体化体验 开始尝试使用obsidian作为笔记软件 学习下大神的知识库 体验下微软开源的Markdown转换工具Markitdown 学习下git的worktree 一些架构师知识点的记录 解答一下关于traefik的一点疑惑 记录一下迁移服务器需要使用的一些命令 较早代iPhone更换新iPhone的一些小指南
浅析下mysql的索引的基数与可选择性
2026-02-08 · via Nicksxs's Blog

最近也看到了一篇文章,结合一些实际的经验来看下索引的基数和可选择性,
这个基数指的是啥呢,就是索引我们一直在讲的是要字段值的差异度比较大的那种,因为假如这个字段的所有值都是比如0和1的话,那索引的结构BTree就没办法高效的找到所查询的值,这个基数就是可以作为它差异度大小的一个参考,当然这是一种反过来的说法,理论上应该从写入这个表的数据的逻辑去看,这些字段会出现哪些值以及它的取值范围是怎么样的
那么这个会在mysql中存起来的基数值可以怎么看呢
还是用我之前建的一个简单的表

1
2
3
4
5
6
7
8
9
10
CREATE TABLE `students` (
`id` bigint(32) NOT NULL AUTO_INCREMENT COMMENT '主键',
`name` varchar(64) NOT NULL COMMENT '姓名',
`age` int(11) NOT NULL COMMENT '年纪',
`class` int(11) NOT NULL COMMENT '班级',
`created_at` datetime NOT NULL COMMENT '创建时间',
`updated_at` timestamp NOT NULL DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP COMMENT '更新时间',
PRIMARY KEY (`id`),
KEY `idx_class` (`class`) USING BTREE
) ENGINE=InnoDB AUTO_INCREMENT=608 DEFAULT CHARSET=utf8mb4 COMMENT='学生表';

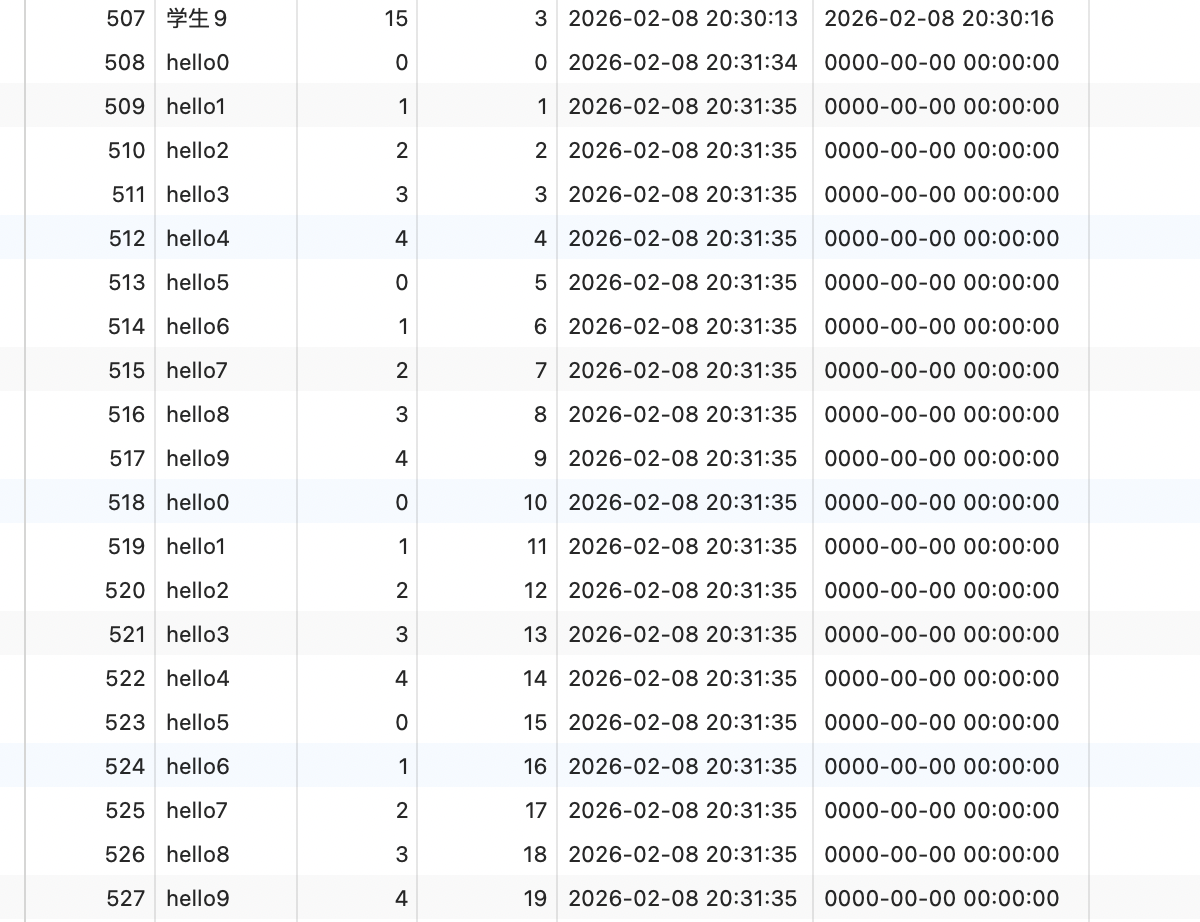
表里的数据也比较简单

因为升成name和class的时候我都用了一定的规律取余,所以会有一些重复的,
这是我们就可以在information库的查一下这个基数

1
select table_schema,table_name,index_name,cardinality from information_schema.statistics where table_schema='database' and table_name = 'students' order by cardinality desc

database是你的库,可以来这么查询

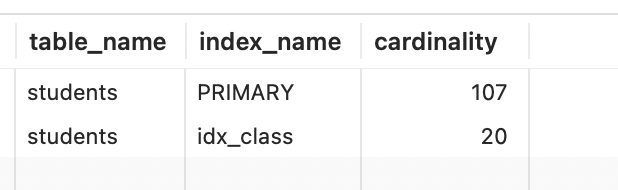
我的这个表差不多是这样,主键刚好对应的就是数据量,另一个班级的索引就是这个class的数量是一致的
所以这就是个明确的区分度的值,而之前也提到过,如果一个表的某个索引字段他的区分度低,跟全表扫描差不多的话
优化器当然也可能会选择不使用索引,直接使用全表扫描,这样就不用质疑说为啥没用起来索引等等