


惯性聚合 高效追踪和阅读你感兴趣的博客、新闻、科技资讯
阅读原文 在惯性聚合中打开

推荐订阅源

V
Visual Studio Blog
Stack Overflow Blog
Stack Overflow Blog
G
Google Developers Blog
Microsoft Azure Blog
Engineering at Meta
Engineering at Meta
L
LangChain Blog
T
The Blog of Author Tim Ferriss
J
Java Code Geeks
Y
Y Combinator Blog
月光博客
月光博客
雷峰网
雷峰网
OSCHINA 社区最新新闻
OSCHINA 社区最新新闻
F
Fortinet All Blogs
A
About on SuperTechFans
让小产品的独立变现更简单 - ezindie.com
P
Proofpoint News Feed
小众软件
小众软件
H
Help Net Security
Last Week in AI
Last Week in AI
B
Blog RSS Feed
宝玉的分享
宝玉的分享
N
Netflix TechBlog - Medium
博客园 - 叶小钗
The GitHub Blog
The GitHub Blog

博客园 - 峻祁连

2022 FISCO BCOS产业应用白皮书披露毕链科技区块链应用方案 毕链科技参编2022 FISCO BCOS产业应用白皮书 动态NFT赋能三维模型数字资产 基于BIM区块链的施工过程结算解决方案 大白话解释一下什么是NFT BIM+区块链在建筑业施工过程结算的应用 设置Mac 中保存对话框默认为扩展窗口 IDEA 环境下更改Maven的仓库镜像提高下载速度 [大数据学习研究] 4. Zookeeper-分布式服务的协同管理神器 用OSS给阿里云ECS扩展硬盘容量 [大数据学习研究] 3. hadoop分布式环境搭建 [大数据学习研究]2.利用VirtualBox模拟Linux集群 [大数据学习研究]1.在Mac上利用VirtualBox搭建本地虚拟机环境 bimgotoblock-BIM要上区块链 BIM轻量化助力建筑业迈向BIM+时代 毕加索发布轻量化转化引擎及BIMSOP协作云平台 - 峻祁连 - 博客园 放个大招,招聘的招 玩儿转物联网IoT - 在Beagle Bone Black上运行node.js 程序 蓝牙Bluetooth技术小知识
[大数据学习研究] 错误排查,Hadoop集群部分DataNode不能启动
峻祁连 · 2019-10-15 · via 博客园 - 峻祁连

错误现象

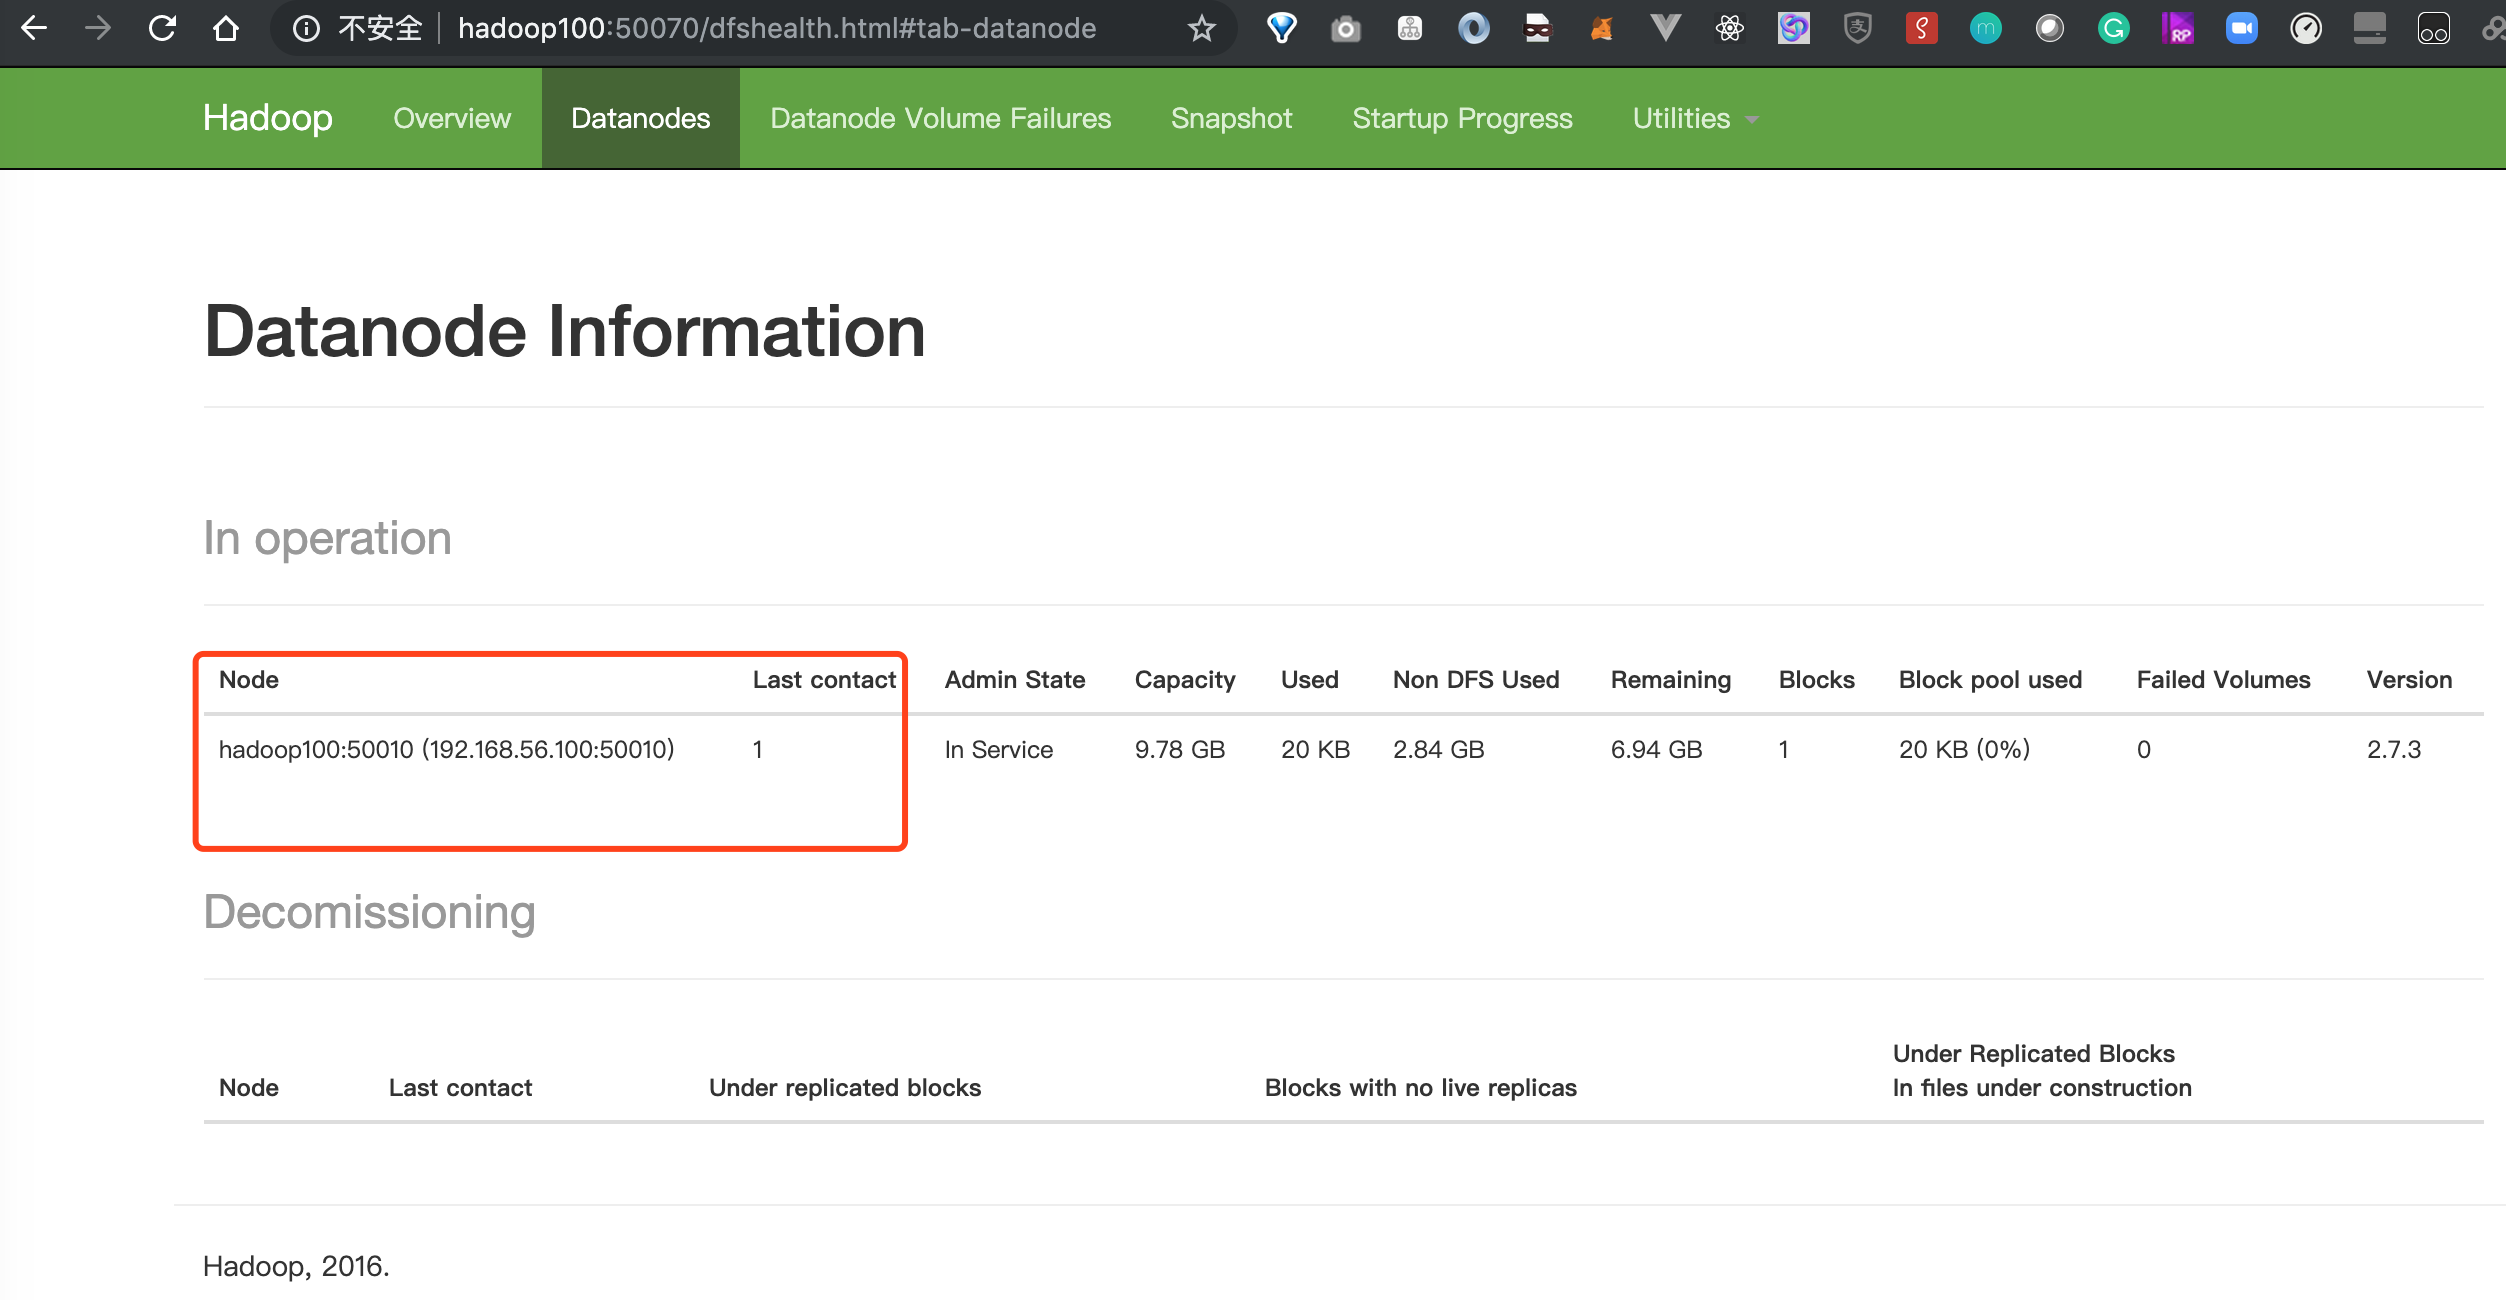
不知道什么原因,今天发现我的hadoop集群启动后datanode只有一台了,我的集群本来有三台的,怎么只剩一台了呢?
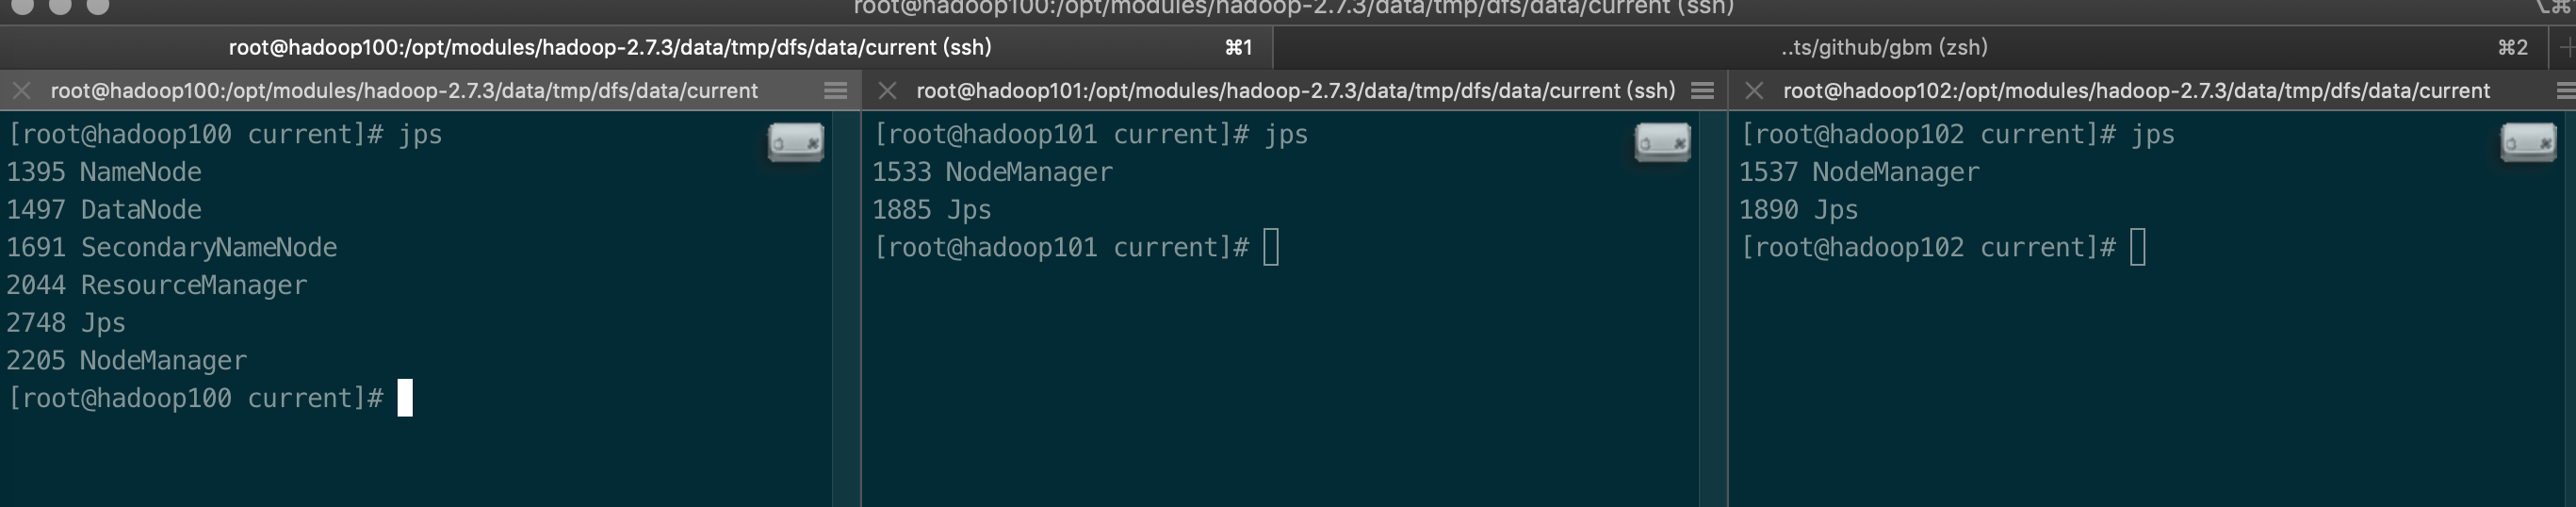
用jps命令检查一下,发现果然有两台机器的DataNode没有启动。
可能原因:

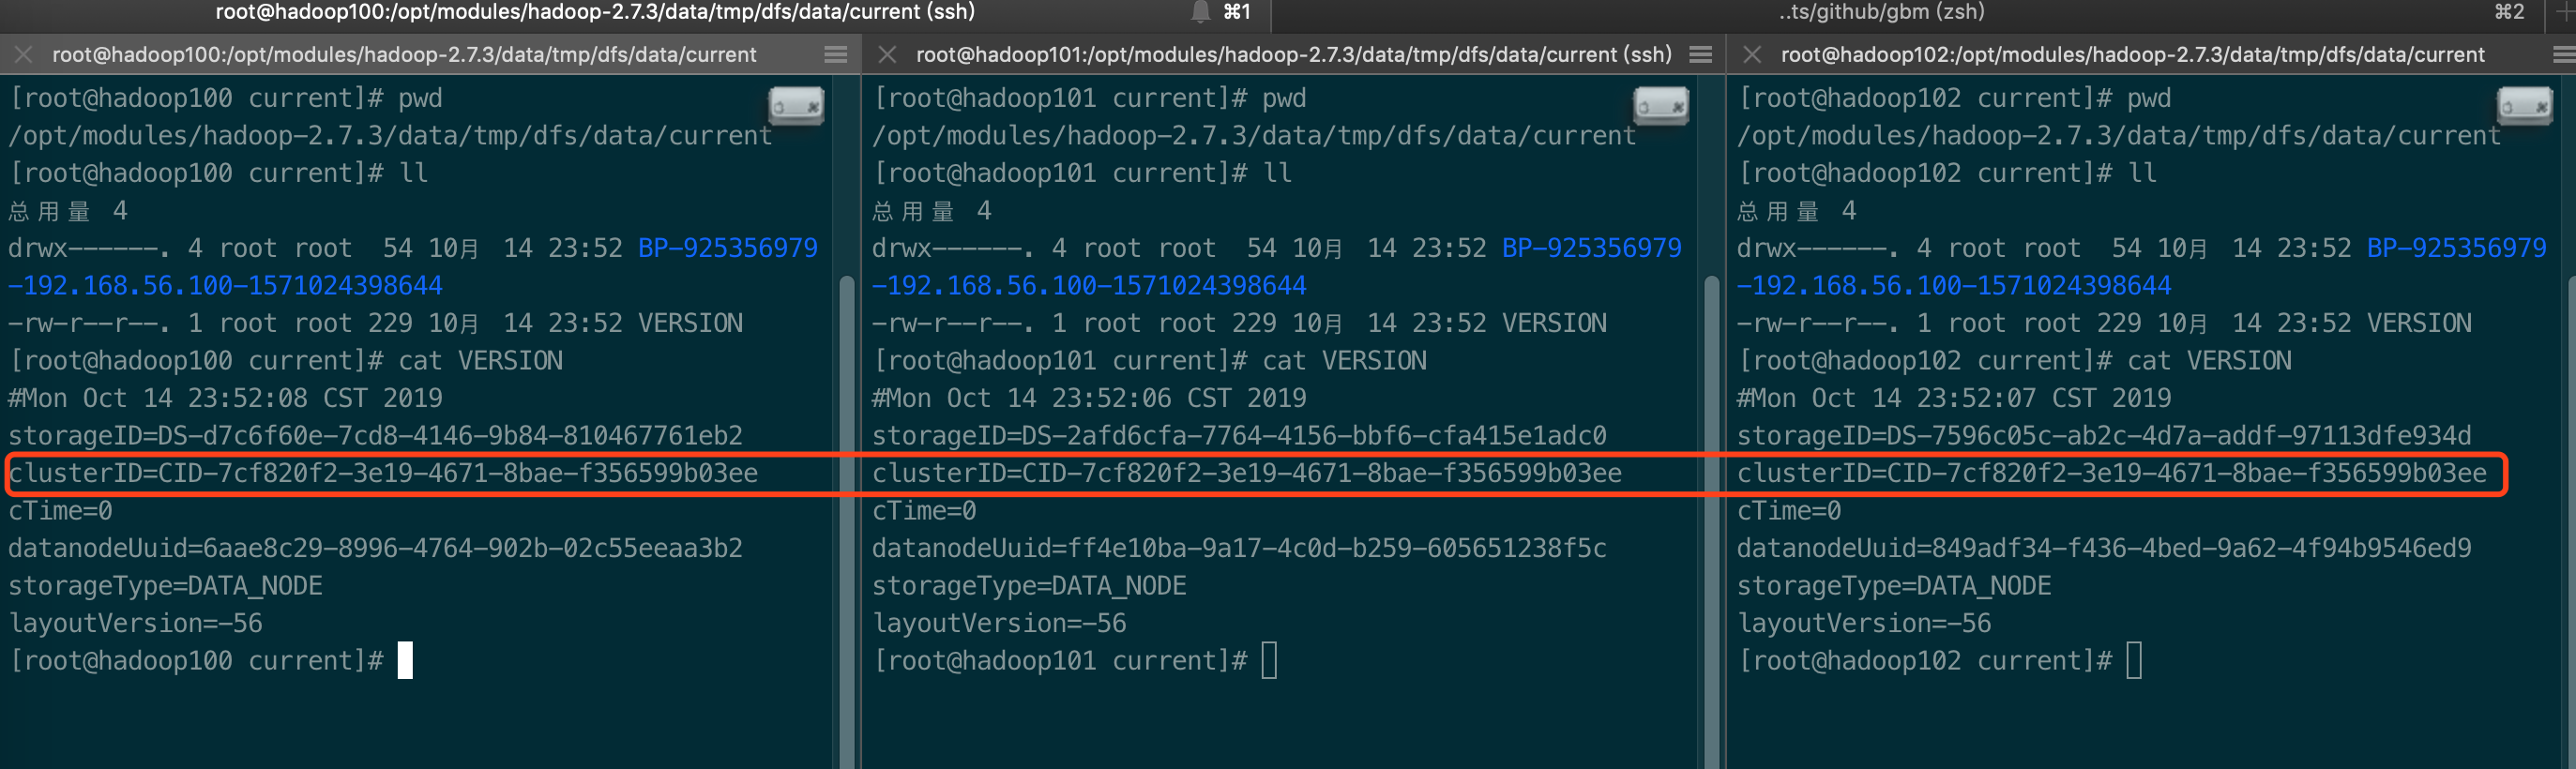
1. 我之前遇到过的问题,由于多次运行hdfs namenode -format, 造成了clusterId不一致,检查一下:进入到/opt/modules/hadoop-2.7.3/data/tmp/dfs/data/current目录下,cat显示一下VERSION文件的内容,检查集群中的几台机器的ClusterID是不是一致。我的机器这三台机器的clusterid是一致的,看起来没问题。如果要是不一致的话,需要改过来,改成一致的,然后用 hadoop-daemon.sh start datanode 就可以启动datanode了,我的不是这个问题引起的,还得继续排查。
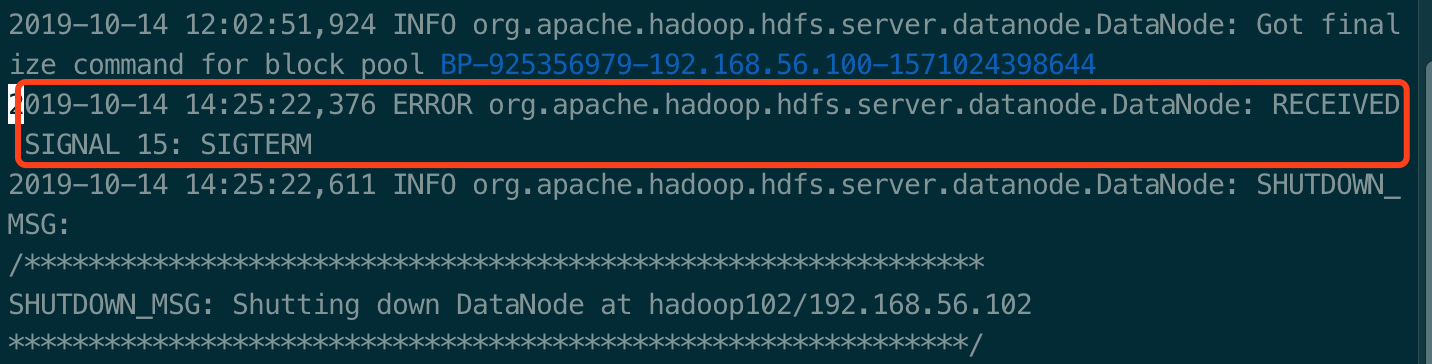
2. 不知道什么原因,还是看看日志,进入的出问题的机器上的logs目录下,打开日志文件,跳到最后,从后面往前看,终于在一堆INFO里面看到一条ERROR:


[root@hadoop101 logs]# pwd /opt/modules/hadoop-2.7.3/logs [root@hadoop101 logs]# vi hadoop-root-datanode-hadoop101.log
2019-10-14 14:25:22,376 ERROR org.apache.hadoop.hdfs.server.datanode.DataNode: RECEIVED SIGNAL 15: SIGTERM 
解决问题

什么原因引起的不清楚,放狗搜了一下,有人说重启服务就好了,当然还是要试一下这个重启大法。关闭服务,再重启一下相关服务,就解决了,好没趣。

stop-all.sh
等带完成
start-dfs.sh

start-yarn.sh

另外,这个帖子里说调用一下hadoop dfsadmin -refreshNodes就好了,但我没用上,反正先重启就搞定了,要还有下次的话再试试吧。