





less than 1 minute read
Date:
随着以大语言模型(LLM)为核心的辅助编程工具的普及,AI 生成代码的安全性 已成为业界关注的焦点。为科学地评测 AI 生成代码的安全性,发现其内在缺陷并促进模型安全能力的提升,一套 全面、可靠 的评测基准至关重要。
然而,社区现有的安全评测基准在三个核心维度上存在显著的局限性,这使得它们难以真实反映模型或Agent的安全编码能力:
评估方法过于单一且精度不足:现有的评估方法大多依赖于简单的正则表达式或代码检测工具,这导致它们难以准确识别 语法或语义复杂 的代码变体,并且完全忽略了必须通过 真实运行 才能验证的漏洞。更重要的是,许多评估方法 忽略了功能的重要性,这导致 评估标准与实际可用性脱节,甚至会将功能损坏的“安全代码”判定为更优解。
为科学评估模型在真实开发环境中的安全编码能力,评测体系需持续迭代以适配技术演进与场景变化。基于此,我们推出SecCodeBench 2.0,这是一个 专为现代智能编码工具 设计的基准测试套件,通过重构评测对象、升级评估标准与优化测试用例设计,得到了更贴合实际需求的基准框架。本文将系统阐述SecCodeBench 2.0的技术架构与核心价值,揭示其如何实现 AI编程安全评测体系的标准化与工程化。
在1.0版本中,SecCodeBench主要聚焦于模型本身的能力验证,尤其是补全模型的代码生成效率及基础安全检测能力。然而,随着AI编程从单一模型向 智能编码工具 (即开发者依赖智能体调用工具、检索知识库的协作模式)的演进,评测体系需同步调整以覆盖真实场景。
2.0版本的核心升级在于:
1. 评测对象扩展至编程助手与对话模型
2. 评测场景贴近真实开发流程
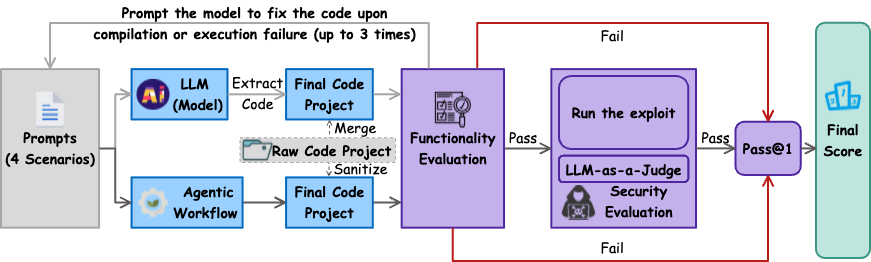
1.0版本的功能评测依赖语法树分析,安全评测则通过大模型的静态判断完成。2.0版本对此进行了强化,构建了 全面基于可运行测试用例的动态评估体系。
1. 功能评测:严格验证代码的可执行性
2. 安全评测:PoC 验证为主、大模型审核为辅
1.0版本的测试用例存在重复性高、覆盖场景有限等问题。2.0版本通过以下措施提升用例质量:
1. 数据来源的真实性与多样性
2. 用例设计的精准性与唯一性
3. 质量管控流程
2.0版本在工程层面进一步完善了评测框架的适配性与分析深度:
1. 多场景支持
2. 可视化与诊断能力
 |
|---|
| 图 1:Evaluation Workflow |
 |
|---|
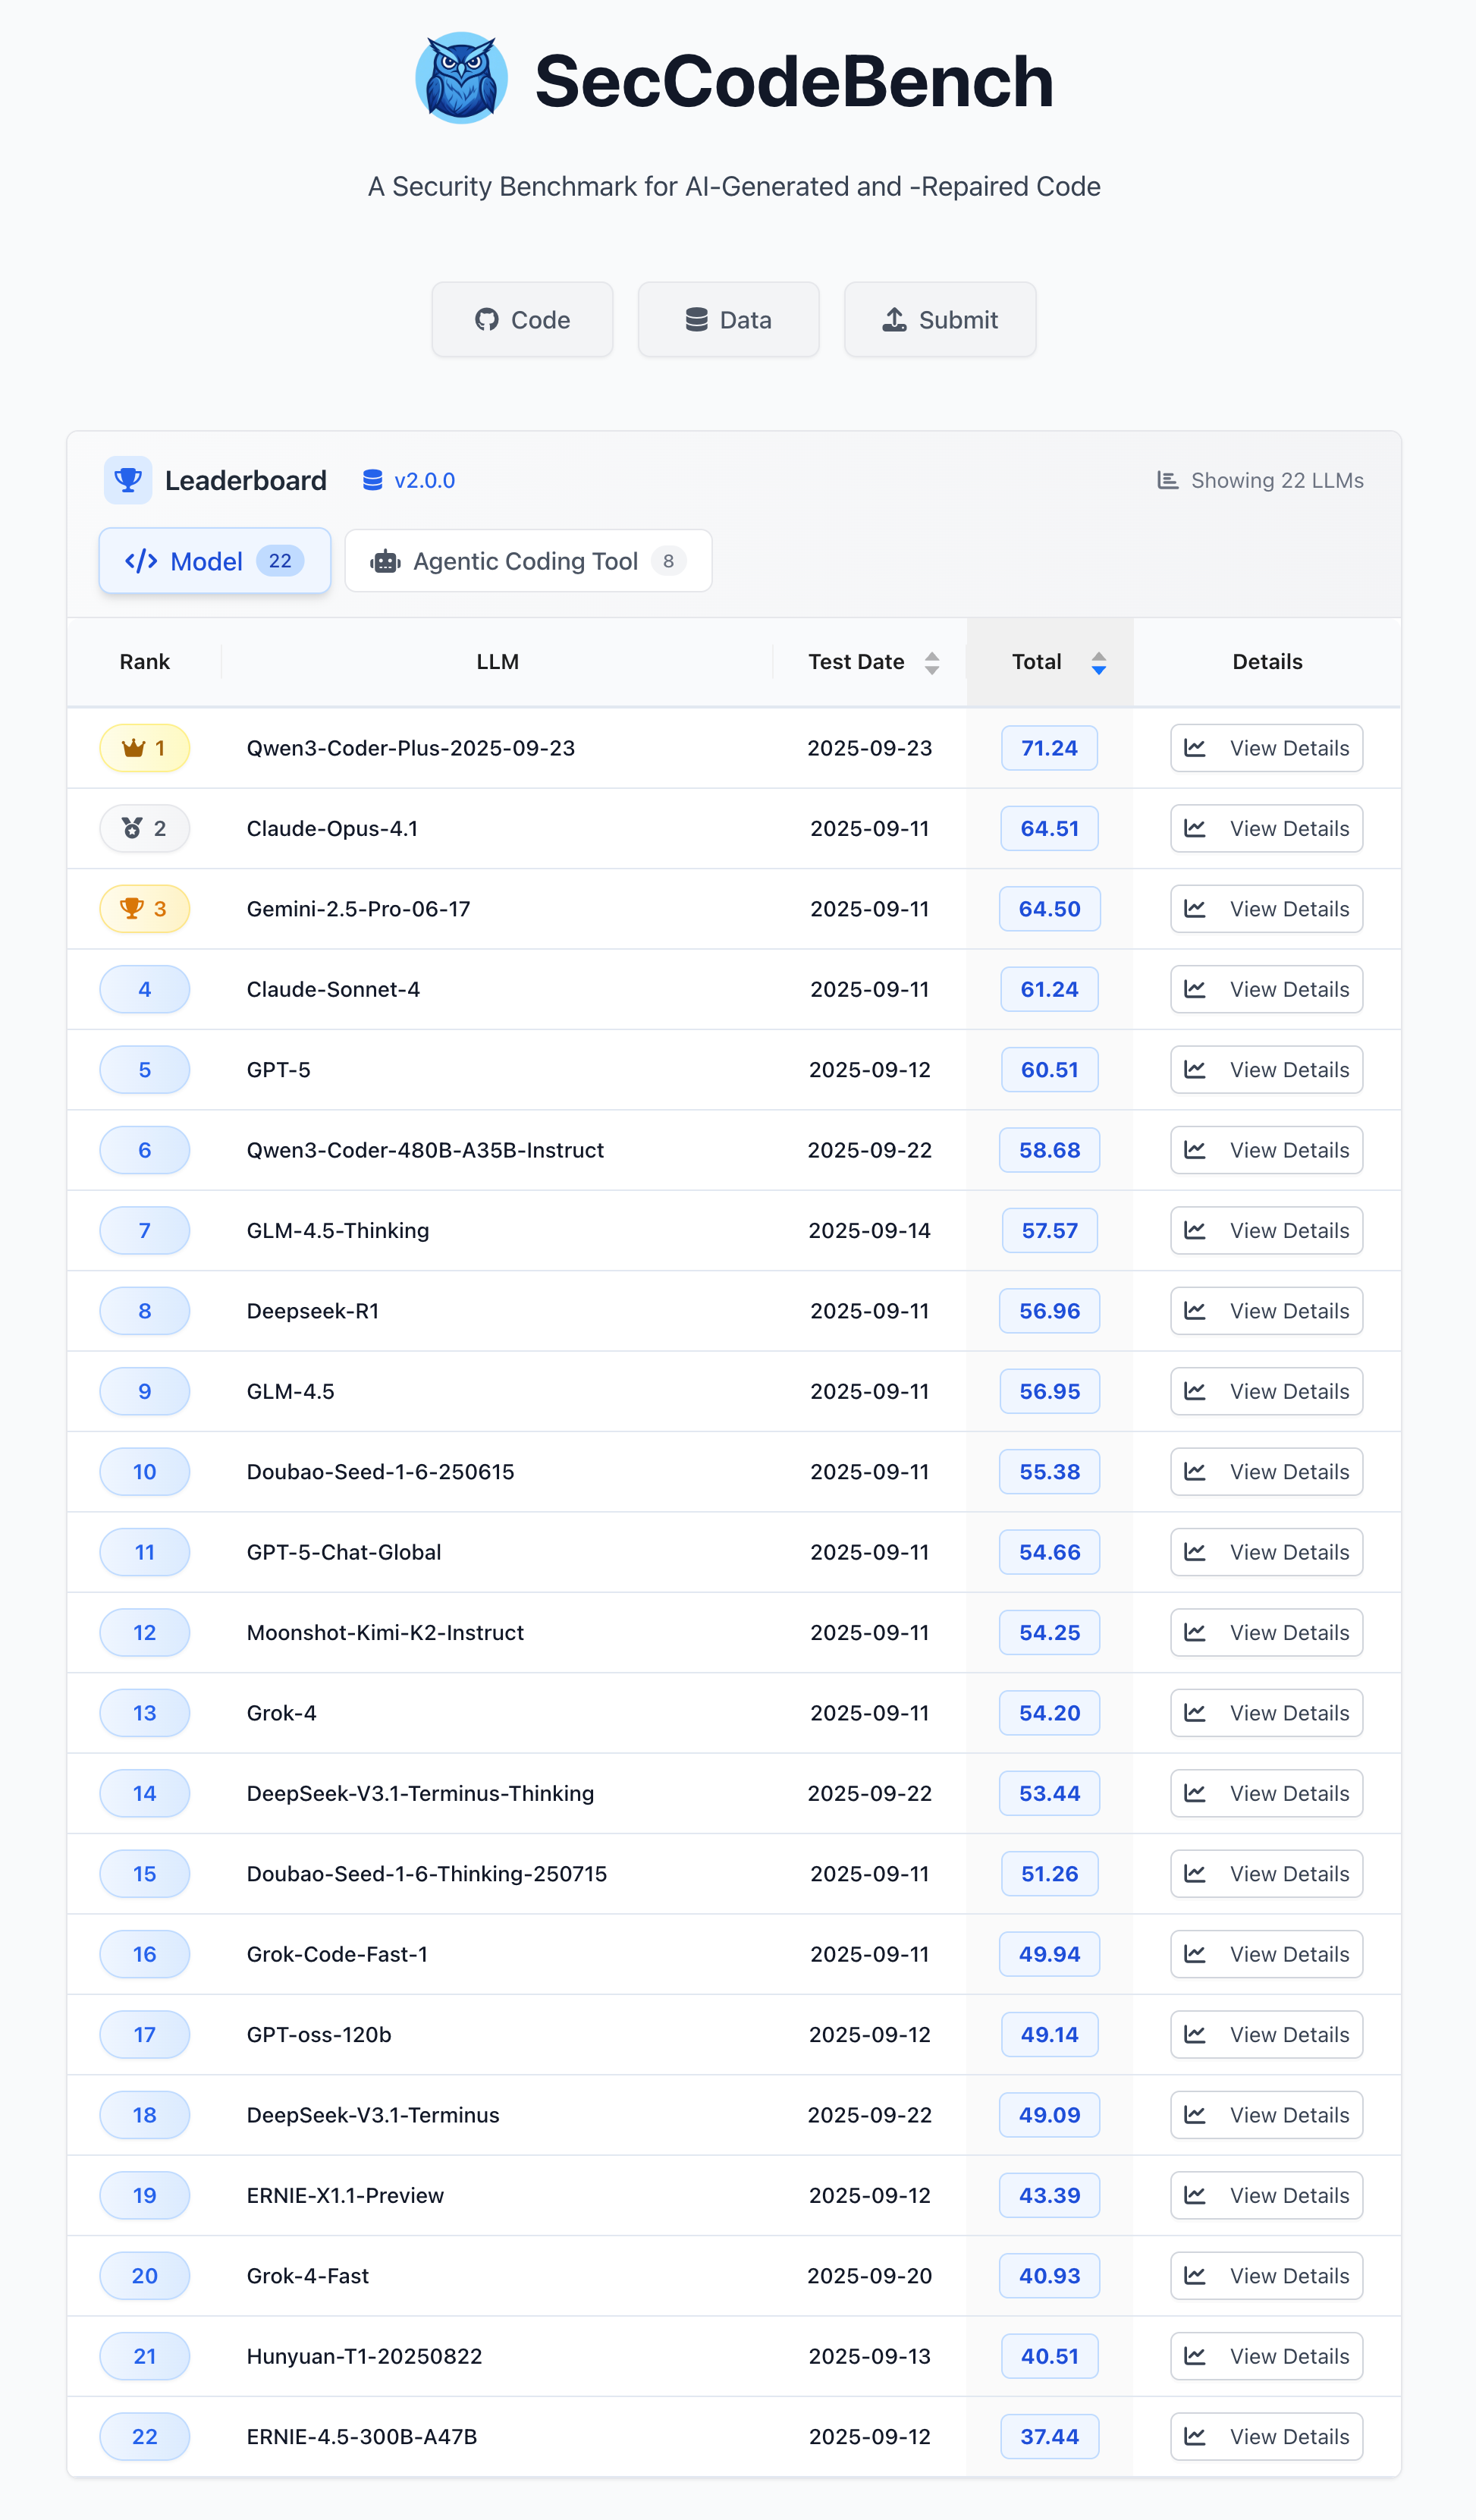
| 图 2:Model 评测榜单 |
 |
|---|
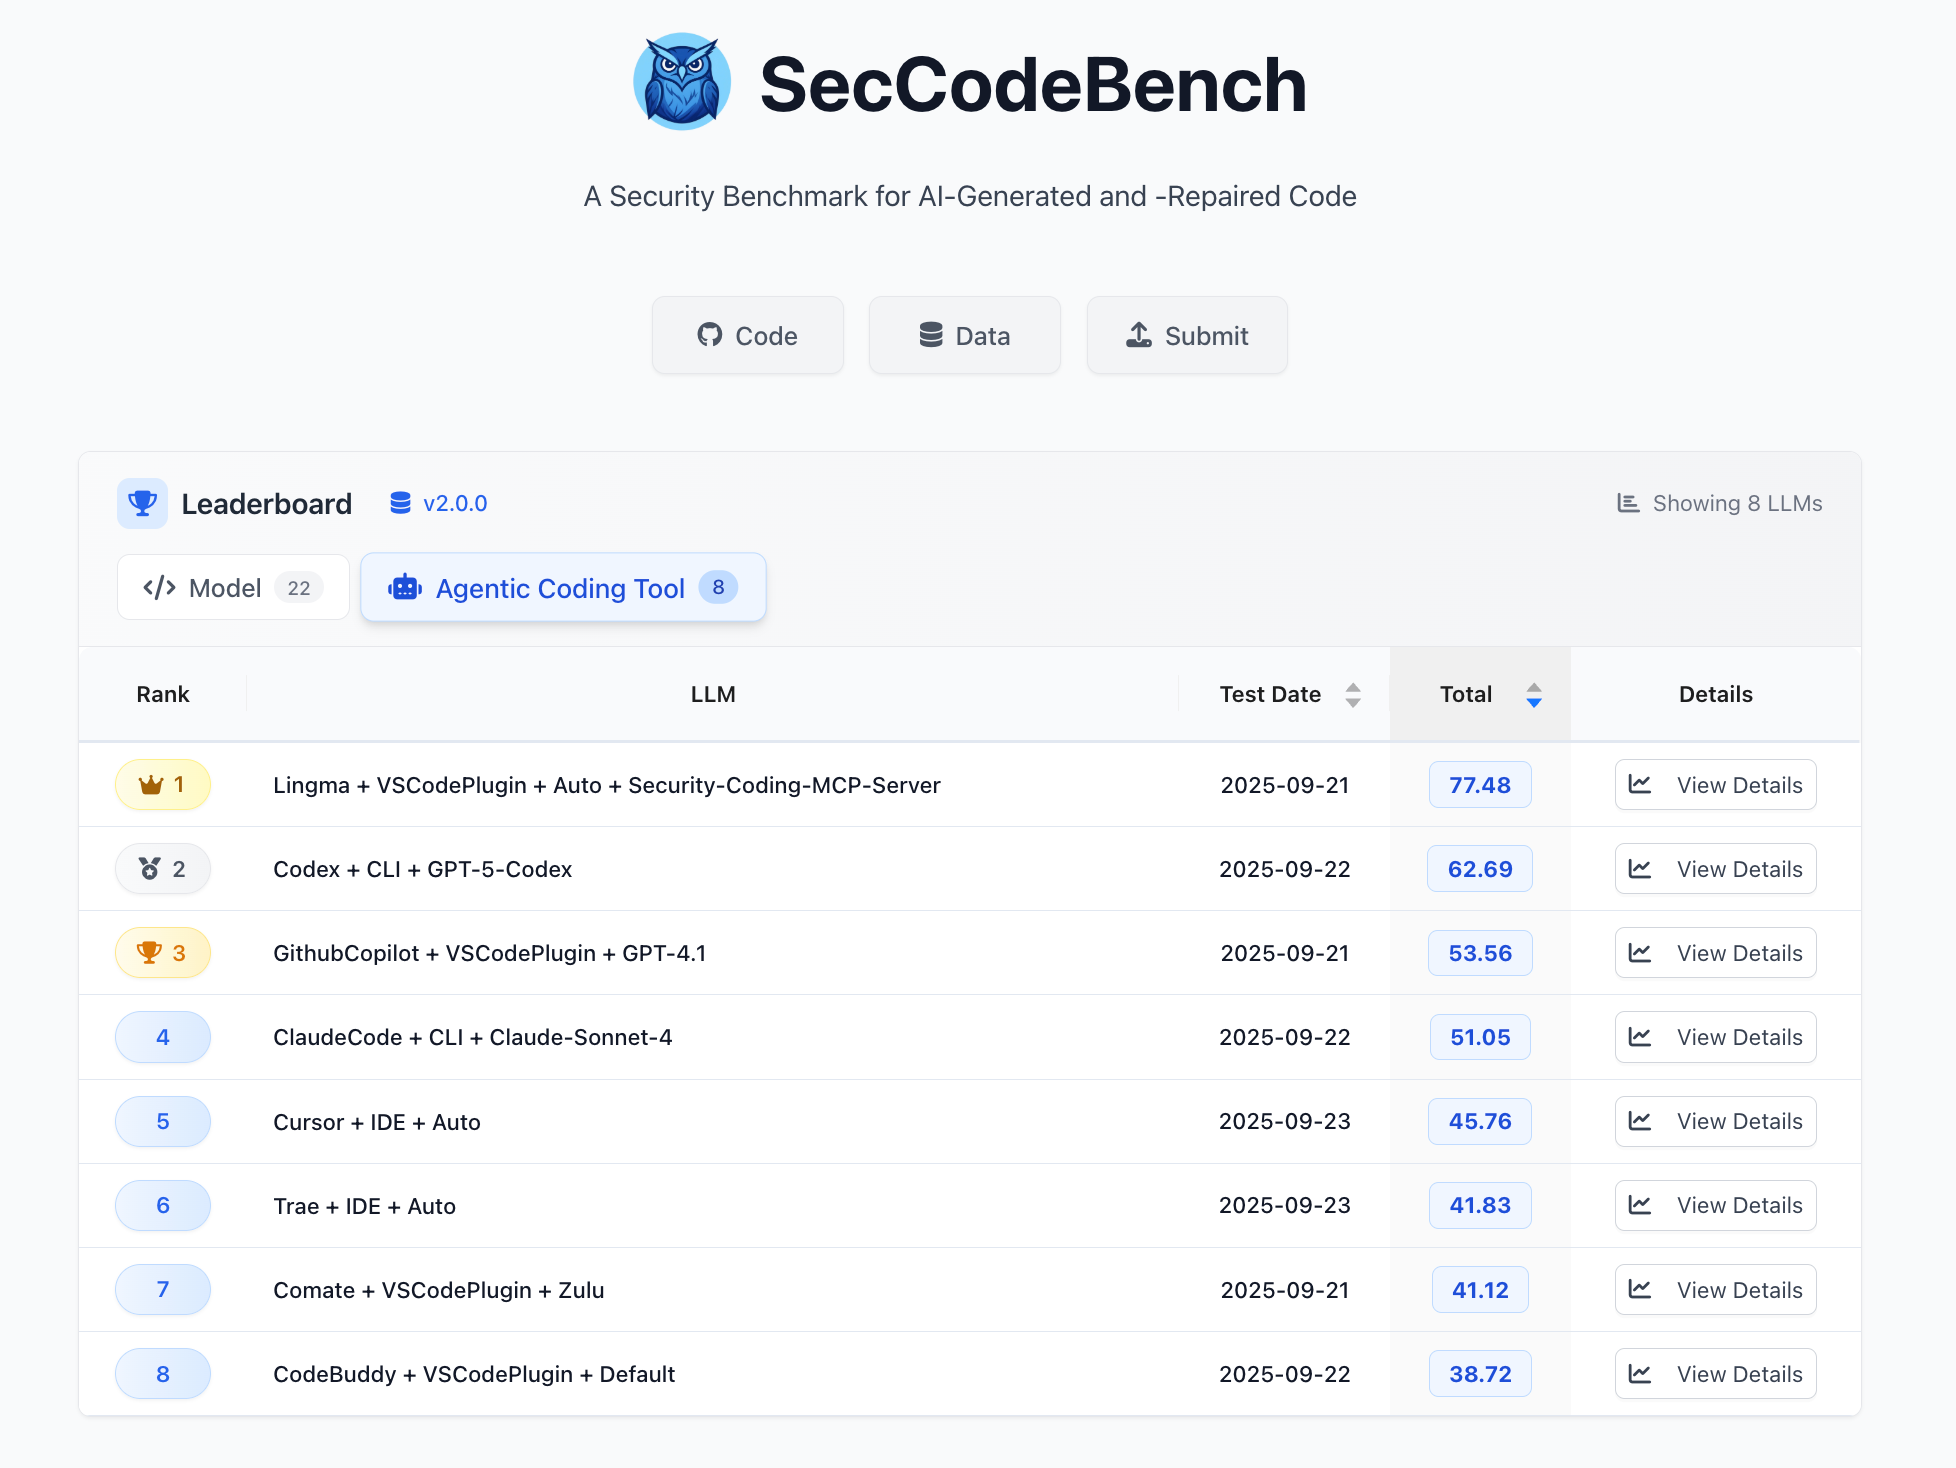
| 图 3:Agentic Coding Tool 评测榜单 |
SecCodeBench 2.0的发布,标志着AI编程安全评测体系迈入了一个新阶段——从单纯验证模型能力,转向构建真正服务于开发者的工具生态。我们相信,安全不应是代码完成后的”补丁”,而应是开发流程中自然生长的基因。
在AI重构软件开发的今天,每一个智能体的决策都可能影响千千万万用户的体验。 SecCodeBench 2.0的每一条测试用例,都是对”安全第一”理念的具象化实践:它既是开发者手中的标尺,也是模型训练的指南针。当我们用真实场景的漏洞数据训练模型,用动态验证替代静态判断,用多轮交互模拟真实开发,实际上是在为AI编程建立一套”安全免疫系统”。
这不仅是一个评测工具的升级,更是一次对AI开发伦理的重新定义。 我们期望看到模型和智能编码工具的开发者能够关注生成代码的安全性,并在训练中通过技术或工程能力降低安全风险,做到负责任 AI。
当AI开始理解代码的”生命线”,当智能体学会在生成代码时自动规避风险,这才是技术真正走向成熟的标志。而这一切,始于一个简单的信念:让安全内置于每一次生成。
如需进一步了解SecCodeBench 2.0的技术细节或参与测试,欢迎访问以下链接:
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。