





对大模型的调用通常有以下几种方式:方式一、大模型厂商都会定义http风格的请求接口,在代码中可以直接发起http请求调用;方式二、在开发环境中使用大模型厂商提供的api;方式三、使用开发框架Langchain调用,这个就像java对数据库的调用一样,可以直接用jdbc也可以使用第三方框架,第三方框架调用会封装一些共性问题,比如参数配置,多数据库统一调用方式,连接处理,缓存处理等等,使用第三方框架调用往往会大幅提高开发效率。下面逐一说明几种调用方式
方式一: post请求调用,以openai(chatgpt)为例,demo如下,举例代码语言为python,http调用各种语言都有这个能力,个人建议还是python来做大模型相关开发,pandas对数据集合处理已经比较成熟,内存运算性能也很高,下面的例子中requests为python的requests的模块
response = requests.post(
"https://api.openai.com/v1/chat/completions",
headers=headers,
json=json_data,
)
其中head封装了在openai上注册的key
headers = {
"Content-Type": "application/json",
"Authorization": "Bearer " + openai.api_key,
}
json是一个python的字典,封装了模型名称和messages(prompt请求)
json_data = {"model": model, "messages": messages}
方式二:python使用使用大模型厂商提供的api(openai为例),首先要在开发环境中pip安装tiktoken和openai模块,openai有两个接口,1个是对话模型,1个语言模型,调用方式分别如下
pip install tiktoken openai
#调用Completion api,openai会以json返回回答
data = openai.Completion.create(
model="text-davinci-003",
prompt="牛肉面故乡在哪里",
max_tokens=1000,
temperature=0
)
#调用 chat Completion api,chat Completion api是GPT3.5开始使用的问答模型,可以使用这个模型实现一问一答
messages=[
{
"role": "user",
"content": "你好"
}
]
data = openai.ChatCompletion.create(
model="gpt-3.5-turbo",
messages = messages
)
方式三:用使用langchain调用,使用langchain自带的OpenAI类,
from langchain.llms import OpenAI
llm = OpenAI(model_name="text-davinci-003")
llm("牛肉面起源于哪个城市")
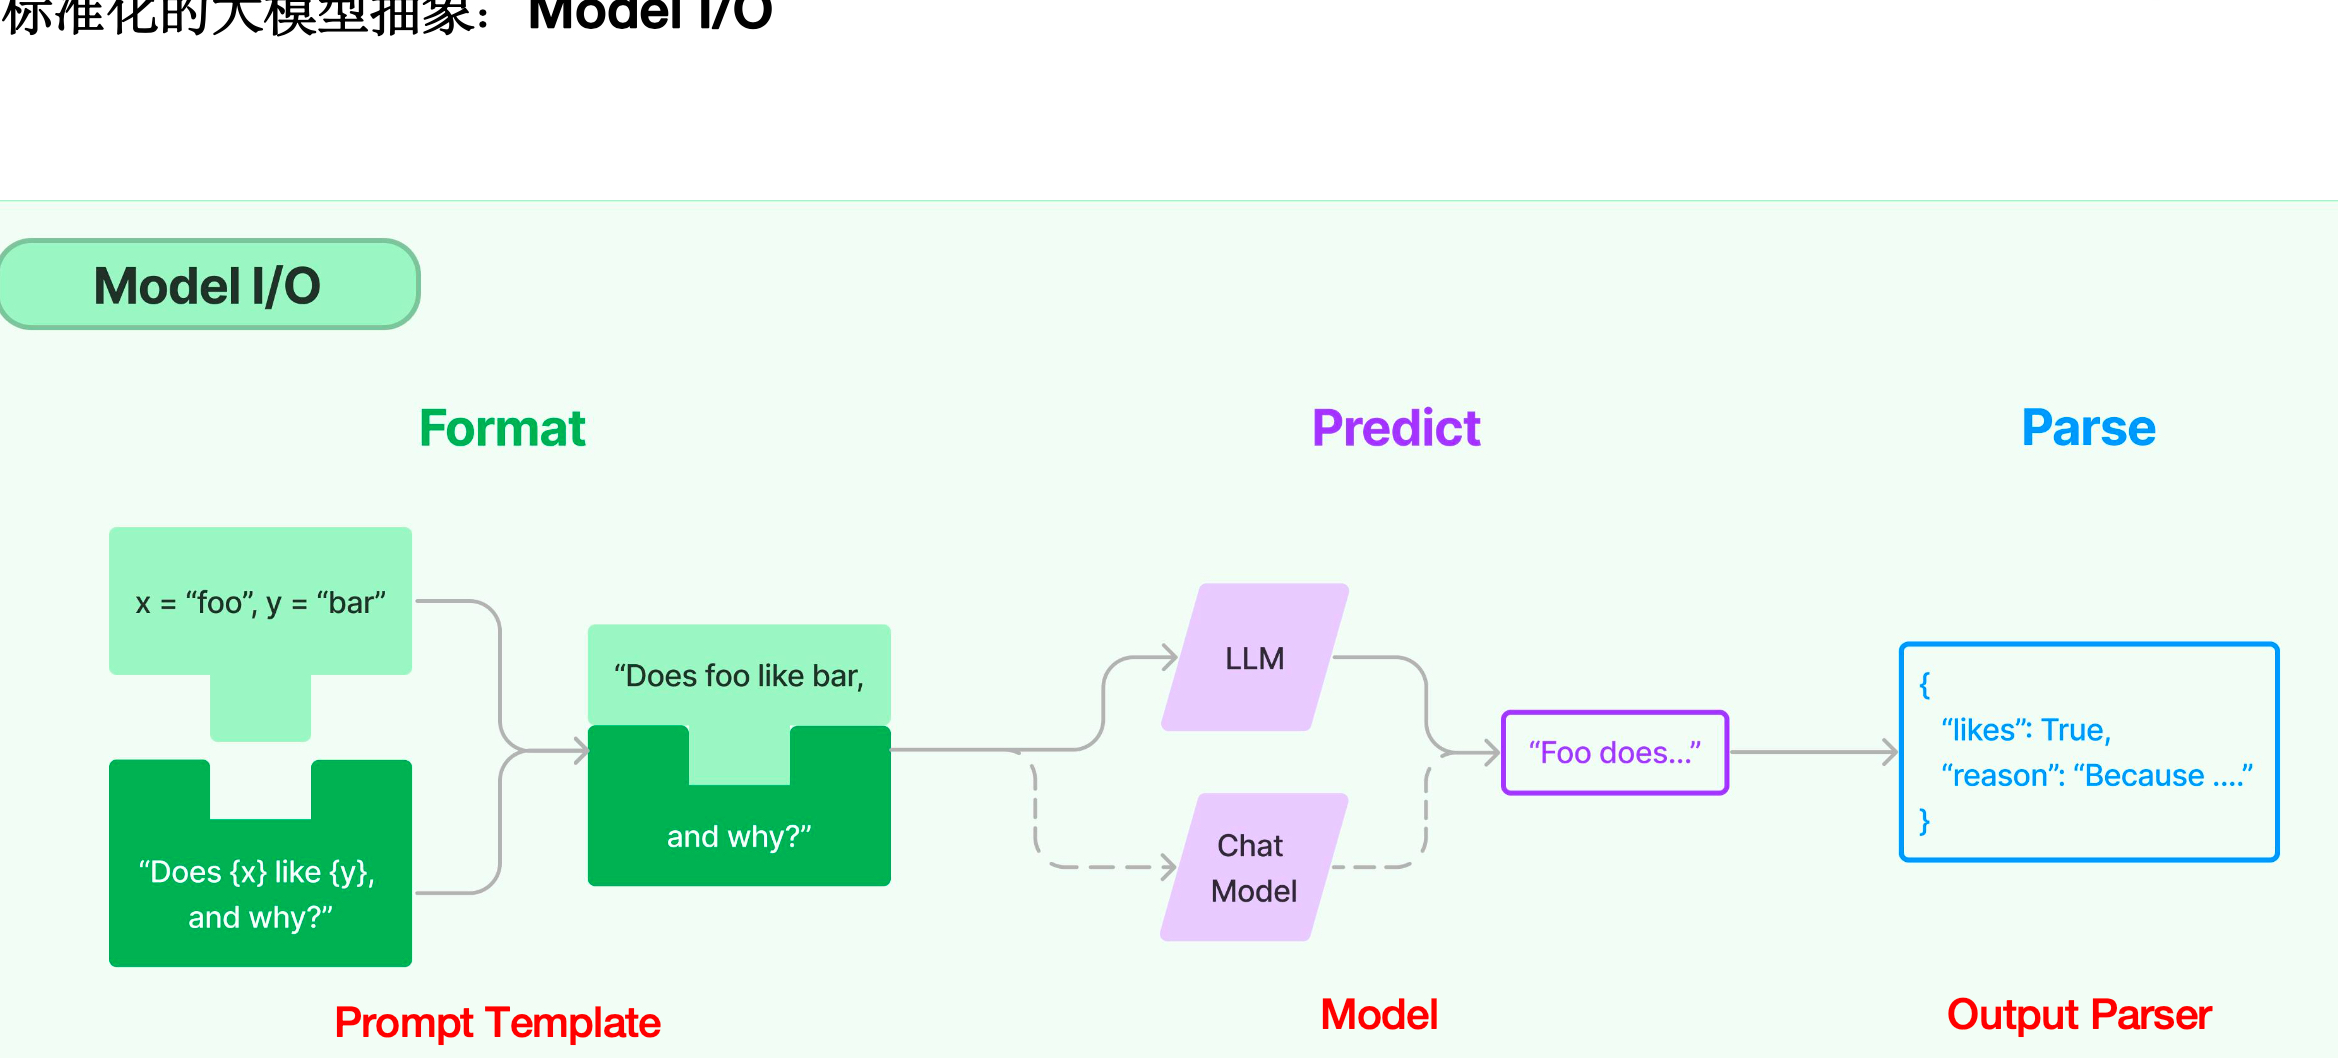
Langchain有model,Data Connection,chains,Memory,Agents,Callbacks,每个模块的使用会在下一篇说明,OpenAI类属于model模块,如下图所示,Model 模块的主要职责1个是提示词的生成,1个是解决对大模型的调用的封装,这个有点像java里面Springboot template对jdbc的封装,封装后统一了对各类模型的调用
此内容由惯性聚合(RSS阅读器)自动聚合整理,仅供阅读参考。 原文来自 — 版权归原作者所有。